Parte 1 de 2 - Medindo engenharia na era dos agentes#
Em uma empresa onde trabalhei, surgiu a proposta de usar o consumo de tokens como um dos indicadores para acompanhar o impacto dos LLMs sobre a produtividade dos desenvolvedores. A lógica apresentada pelo executivo partia de dados que já estavam disponíveis: o provedor permitia acompanhar o consumo por usuário e por time, e a organização também queria entender se as ferramentas de IA estavam de fato entrando no fluxo de desenvolvimento. Usuários ou áreas com maior consumo teriam de demonstrar quais ganhos estavam obtendo com aquele uso.
A proposta combinava duas coisas diferentes: telemetria de adoção e comprovação de resultado. O consumo ajudava a mostrar intensidade de uso, mas, quando entrava na discussão de produtividade, era necessário observar o que acontecia depois. Um time podia consumir muito mais tokens sem necessariamente entregar mais rápido, reduzir retrabalho ou manter a mesma qualidade.
Há várias razões para essa diferença. O consumo pode crescer porque mais pessoas adotaram a ferramenta, porque as tarefas ficaram mais complexas, porque o contexto enviado aumentou, porque o agente passou a fazer mais chamadas de ferramentas ou porque precisou de mais tentativas para concluir a mesma tarefa. Também pode crescer simplesmente porque uma arquitetura ficou menos eficiente. O volume consumido, sozinho, não informa quanto software útil chegou a produção, quanto tempo foi economizado no fluxo completo ou qual foi o efeito sobre qualidade e estabilidade.
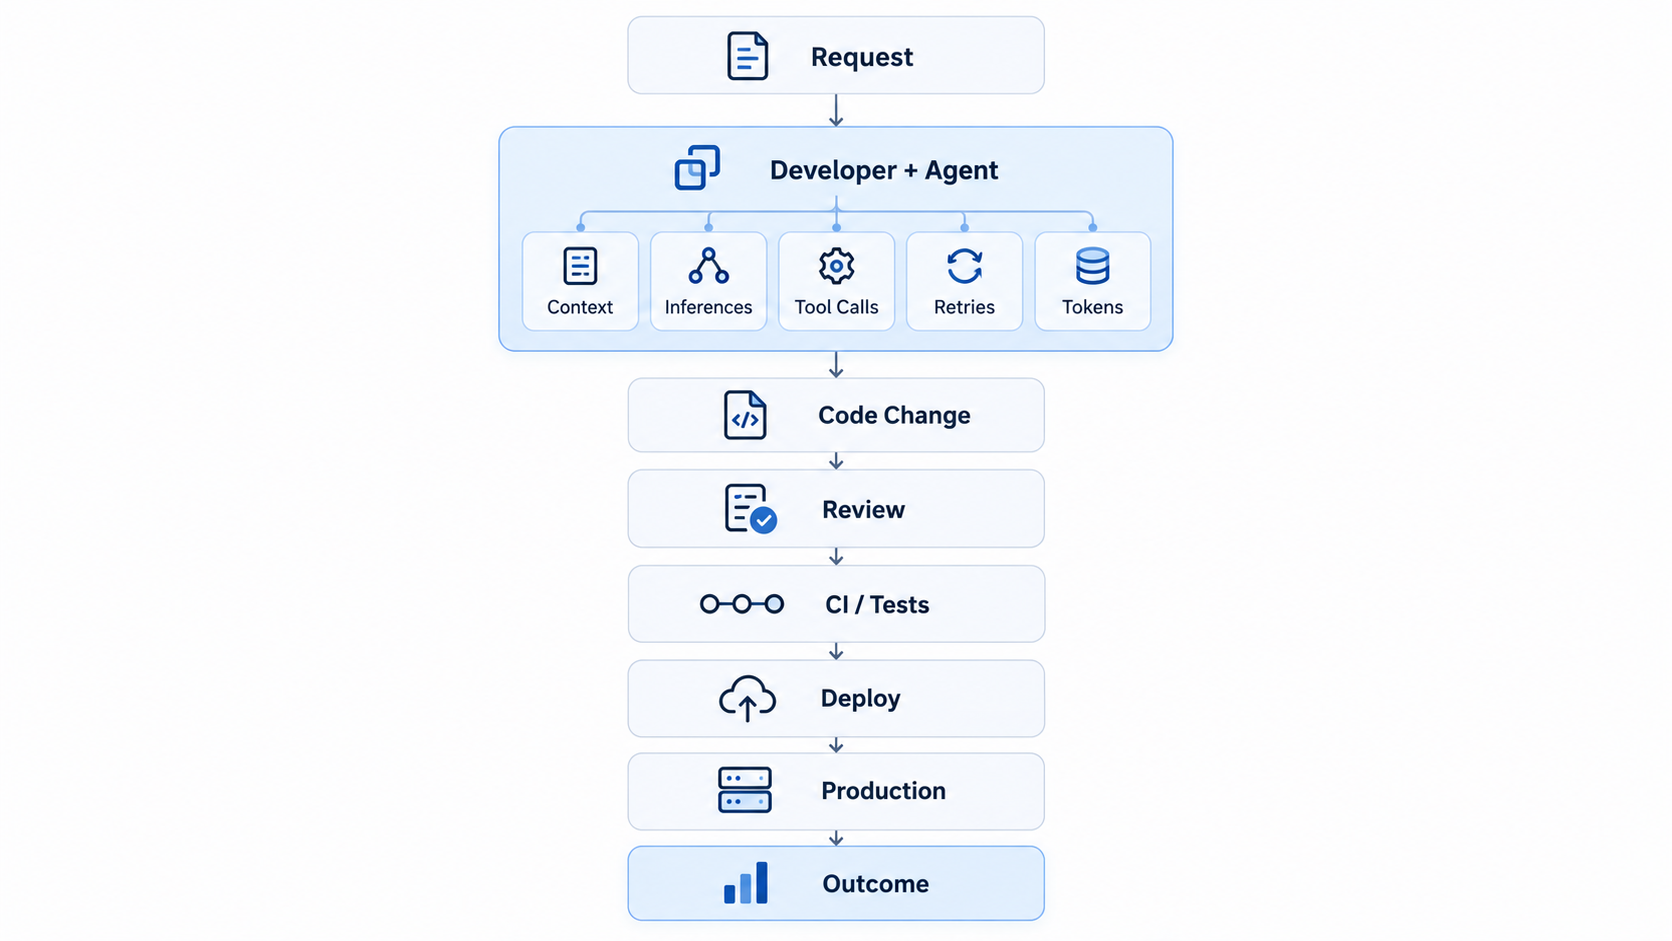
Esse ponto ganhou ainda mais importância com a evolução dos coding agents e dos ciclos iterativos de execução. Entre a solicitação do desenvolvedor e uma mudança de código, o agente pode pesquisar o repositório, abrir arquivos, recuperar contexto, consultar documentação, executar comandos, testar hipóteses, chamar ferramentas, revisar o próprio resultado e repetir parte desse processo. Cada uma dessas etapas pode aumentar o consumo antes mesmo de a mudança entrar em review, CI ou produção.
Por isso, token usage é um dado relevante para analisar essa execução. A questão é quais conclusões podemos sustentar a partir dele.
Considere dois desenvolvedores trabalhando em mudanças comparáveis.
O primeiro usa um agente que recebe uma parcela grande do repositório como contexto, percorre vários arquivos, executa doze ciclos entre análise e correção e consome 8 milhões de tokens. O segundo trabalha com recuperação mais seletiva de contexto, chega à solução em três ciclos e consome 1,5 milhão. As duas alterações passam pelos testes e são aceitas em review.
Ainda sabemos pouco sobre produtividade.
O segundo fluxo parece computacionalmente mais eficiente, mas talvez as tarefas não fossem realmente equivalentes. Também não sabemos quanto tempo humano foi necessário, quanto cada PR permaneceu em review, se houve retrabalho posteriormente ou se alguma das mudanças criou um incidente em produção.
O problema fica mais evidente se desenharmos onde a métrica está sendo observada.
 Ampliar ↗
O consumo de tokens aparece cedo no fluxo; o resultado que associamos à produtividade surge depois de várias outras etapas.
Isso não torna a telemetria da inferência menos importante. Ela responde a um conjunto mais restrito de perguntas: quanto estamos consumindo, quais workloads são mais caros, como o uso está distribuído e onde determinadas arquiteturas estão gastando mais recursos.
A mesma tarefa pode gerar perfis de consumo muito diferentes#
O volume de tokens varia por razões que não estão necessariamente relacionadas à quantidade de valor produzido. Context window, caching, modelo, estratégia de recuperação, número de etapas e arquitetura do agente alteram bastante o consumo.
Um workflow pode usar uma única chamada grande. Outro pode decompor a mesma tarefa entre planner, coder e reviewer. Um terceiro pode executar um evaluator depois de cada mudança. Se houver retries, os três perfis se afastam ainda mais.
Encontrei uma versão desse problema quando construí o Controlled Autonomy Lab, apresentado em 6 padrões de arquitetura LLM: aprendizados de 234 execuções experimentais sobre controle e autonomia. O laboratório compara seis padrões e registra tokens, latência, grounding, trajetória de execução, uso de ferramentas e outras dimensões.
Nas primeiras execuções ficou claro que tokens, latência ou uma métrica genérica de qualidade não seriam suficientes para comparar os padrões. A avaliação acabou sendo separada em camadas, cada uma voltada a uma propriedade diferente do resultado.
Um dos resultados ajuda a mostrar por que isso importa: no repeated benchmark, o chaining fazia três chamadas sequenciais e apresentou grounding específico inferior ao augmented LLM, que utilizava uma chamada, nos três bundles de providers observados. Eu não trataria esse resultado como evidência de que mais chamadas pioram qualidade; o experimento não foi desenhado para provar esse mecanismo. O que ele mostrou foi que quantidade de chamadas não apresentou uma relação monotônica com grounding naquele conjunto de execuções.
A implicação para produtividade é parecida. Dois agentes podem consumir quantidades muito diferentes de inferência e chegar a resultados semelhantes. O consumo, sozinho, não mostra qual configuração contribuiu mais para o fluxo de engenharia.
Quando utilização vira meta#
A situação muda quando token usage deixa de ser apenas telemetria e passa a influenciar metas, rankings ou avaliação de performance.
Em agosto de 2026, o Google Cloud publicou um texto sobre tokenmaxxing, termo usado para descrever a ideia de que aumentar o consumo de tokens levaria, por si só, a melhores resultados com IA. O argumento é que consumo precisa ser relacionado ao outcome obtido e à eficiência do workflow, em vez de ser maximizado isoladamente. What sports cars can teach us about optimizing AI token spend.
Já havia tratado desse fenômeno por outro ângulo em A conta da IA chegou: limitar o uso é a resposta? Naquele texto, o foco era custo e arquitetura. Algumas empresas chegaram a experimentar rankings internos de consumo para estimular adoção e depois encontraram incentivos para consumo artificial.
O incentivo é relativamente fácil de entender. Se uma organização passa a valorizar usuários que consomem mais tokens, várias decisões aumentam o indicador sem necessariamente melhorar o trabalho: enviar mais contexto, manter respostas mais longas, executar mais iterações, usar modelos maiores ou simplesmente levar mais tarefas para o agente.
Há também um efeito menos óbvio. Um desenvolvedor que melhora o harness, passa a recuperar apenas o contexto necessário, utiliza caching e reduz retries pode diminuir muito o consumo para executar a mesma classe de tarefa. Se a empresa interpreta volume como produtividade, uma melhoria de eficiência pode aparecer no dashboard como queda de performance.
Onde tokens são úteis#
Há vários casos em que eu acompanharia tokens de perto.
O primeiro é custo: ao combinar consumo com preço do modelo, caching e tipo de workload, é possível acompanhar custos por aplicação, agente, time ou capability e identificar mudanças relevantes depois de uma alteração arquitetural.
O segundo é adoção: se uma ferramenta foi disponibilizada para 300 desenvolvedores e apenas 20 apresentam uso recorrente, existe uma questão concreta para investigar. Pode ser treinamento, experiência ruim, casos de uso fracos, dificuldade de integração ou simplesmente baixa utilidade para aquele grupo.
O terceiro é diagnóstico: mudanças abruptas no consumo de um workflow podem indicar loops, aumento de contexto, degradação de caching, novas tool calls ou alteração no comportamento do agente.
Tokens também podem participar de análises de eficiência quando existe um outcome bem definido. Custo por tarefa concluída, custo por execução bem-sucedida ou custo por determinada capability permitem comparar versões do sistema com muito mais contexto do que o volume absoluto.
Esse último caso aparece no artigo Automating eval design and hillclimbing with Claude. No exemplo de hillclimbing focado em custo, o objetivo é reduzir custo mantendo ou melhorando performance em uma avaliação separada. A configuração final é comparada tanto pelo resultado quanto pelo custo necessário para alcançá-lo.
Esse desenho preserva o objetivo que queremos otimizar. Reduzir tokens deixando a aplicação pior seria uma regressão; gastar mais para obter uma melhora material pode ser justificável. O consumo passa a ser analisado junto de uma medida de qualidade.
Exposição à IA é uma variável, não o resultado#
Token usage pode cumprir ainda outra função: ajudar a estimar diferentes níveis de exposição à IA.
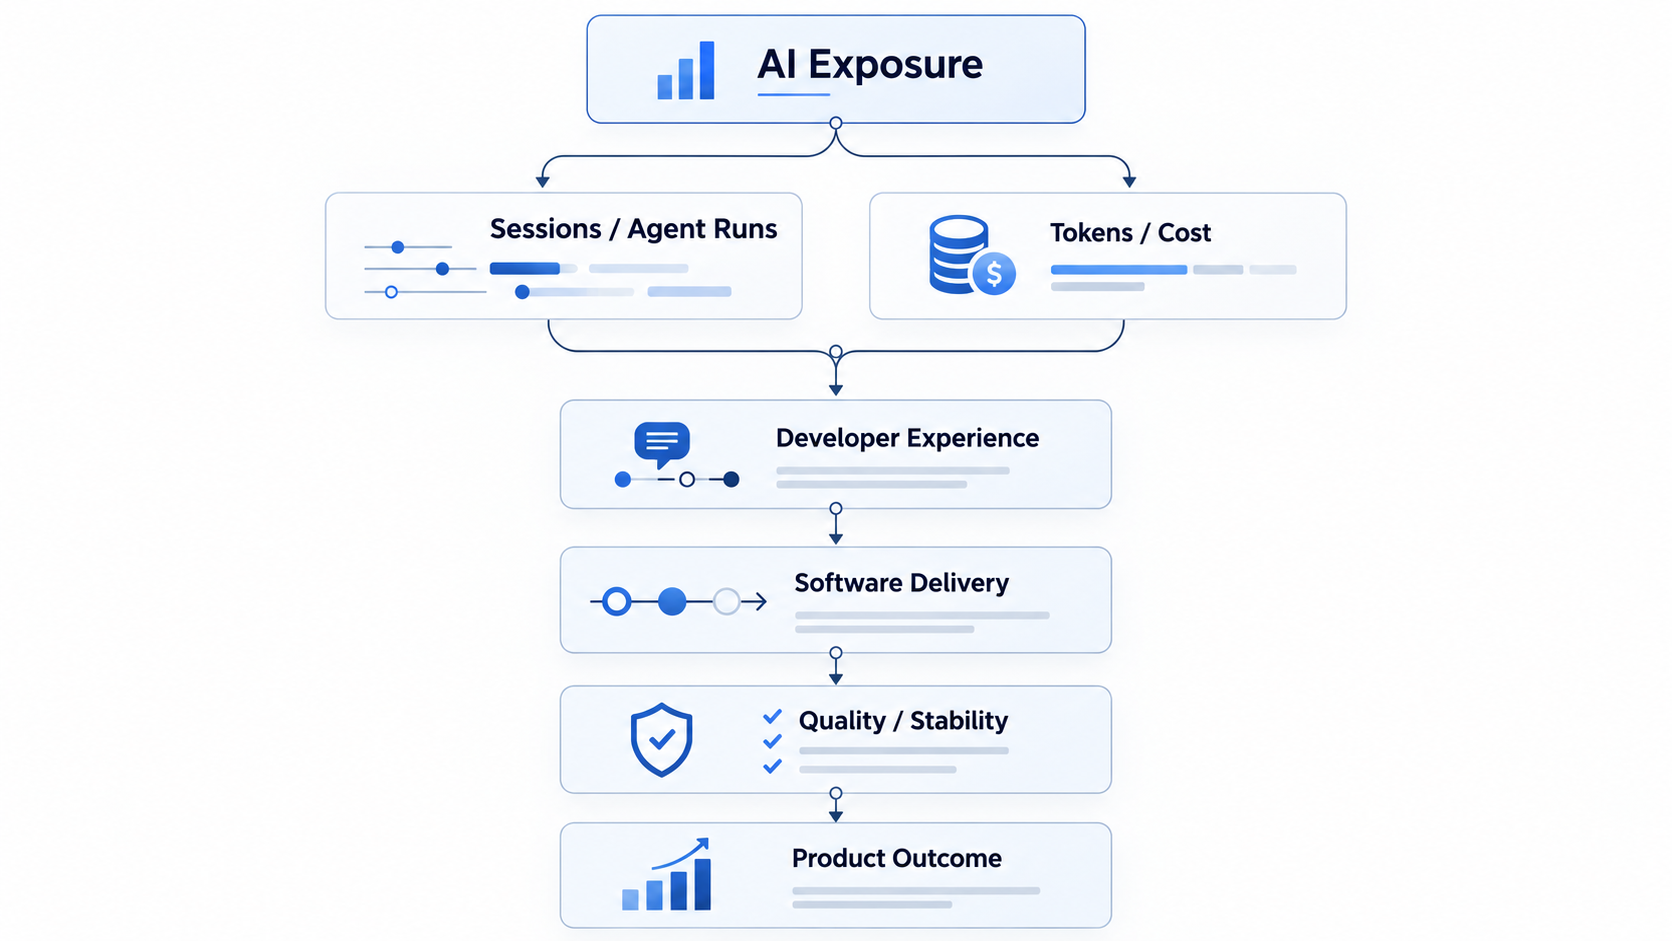
Em um estudo de produtividade, eu não classificaria essa exposição apenas pelo volume consumido. Sessões, dias ativos, agent runs, tipos de tarefa, capabilities utilizadas e frequência de uso ajudam a distinguir alguém que usa o agente diariamente em tarefas curtas de alguém que consome milhões de tokens em poucas execuções longas.
 Ampliar ↗
Ainda assim, maior exposição não prova que a IA causou um resultado melhor. Desenvolvedores mais experientes podem ser os primeiros a adotar a ferramenta, alguns times podem trabalhar em sistemas mais novos e a maturidade do pipeline pode variar bastante entre os grupos.
Mesmo com essas limitações, essa separação resolve um problema importante: evita usar a própria variável de exposição como resultado do experimento.
Da telemetria para a pergunta que realmente importa#
Uma empresa pode ter quase todos os desenvolvedores ativos em uma ferramenta, bilhões de tokens consumidos e milhares de sessões por semana. Esses números demonstram adoção, mas ainda falta saber o que mudou no trabalho.
É nesse ponto que eu encerraria a leitura de token usage. A partir daqui, a análise precisa olhar para outras dimensões: experiência do desenvolvedor, fluxo até produção, estabilidade e, quando houver uma ligação clara, resultado de produto.
Essa mudança também altera o desenho da pergunta. Em vez de “quem consumiu mais?”, passa a interessar se grupos com diferentes níveis de exposição apresentaram mudanças diferentes ao longo do tempo e se essas mudanças continuam visíveis depois de controlar fatores como senioridade, tipo de tarefa, aplicação e maturidade do pipeline.
Parte 2: DORA, Developer Experience e coortes: como comparar essas mudanças sem transformar uma única métrica em prova de produtividade.