Quando um coding agent começa a participar do desenvolvimento, ele entra em um processo que já possui identidade, repositórios, dependências, ambientes de execução, testes, branch policies, CI/CD e regras para promoção de mudanças.
Dar acesso ao repositório resolve apenas uma parte dessa integração. O agente ainda precisa saber qual mudança está sendo solicitada, quais restrições deve respeitar, onde pode executar código, quais ferramentas estão disponíveis e quais resultados precisam ser produzidos antes que uma alteração possa avançar no fluxo.
Foi a partir dessa necessidade que comecei a olhar para Agentic SDLC como um problema de plataforma. O modelo e o coding agent continuam importantes, mas a unidade de arquitetura passa a incluir também o caminho percorrido entre uma intenção de mudança e uma decisão de merge.
Neste texto, vou limitar o recorte a esse intervalo. Release, operação em produção, rollback e incident response merecem uma discussão própria.
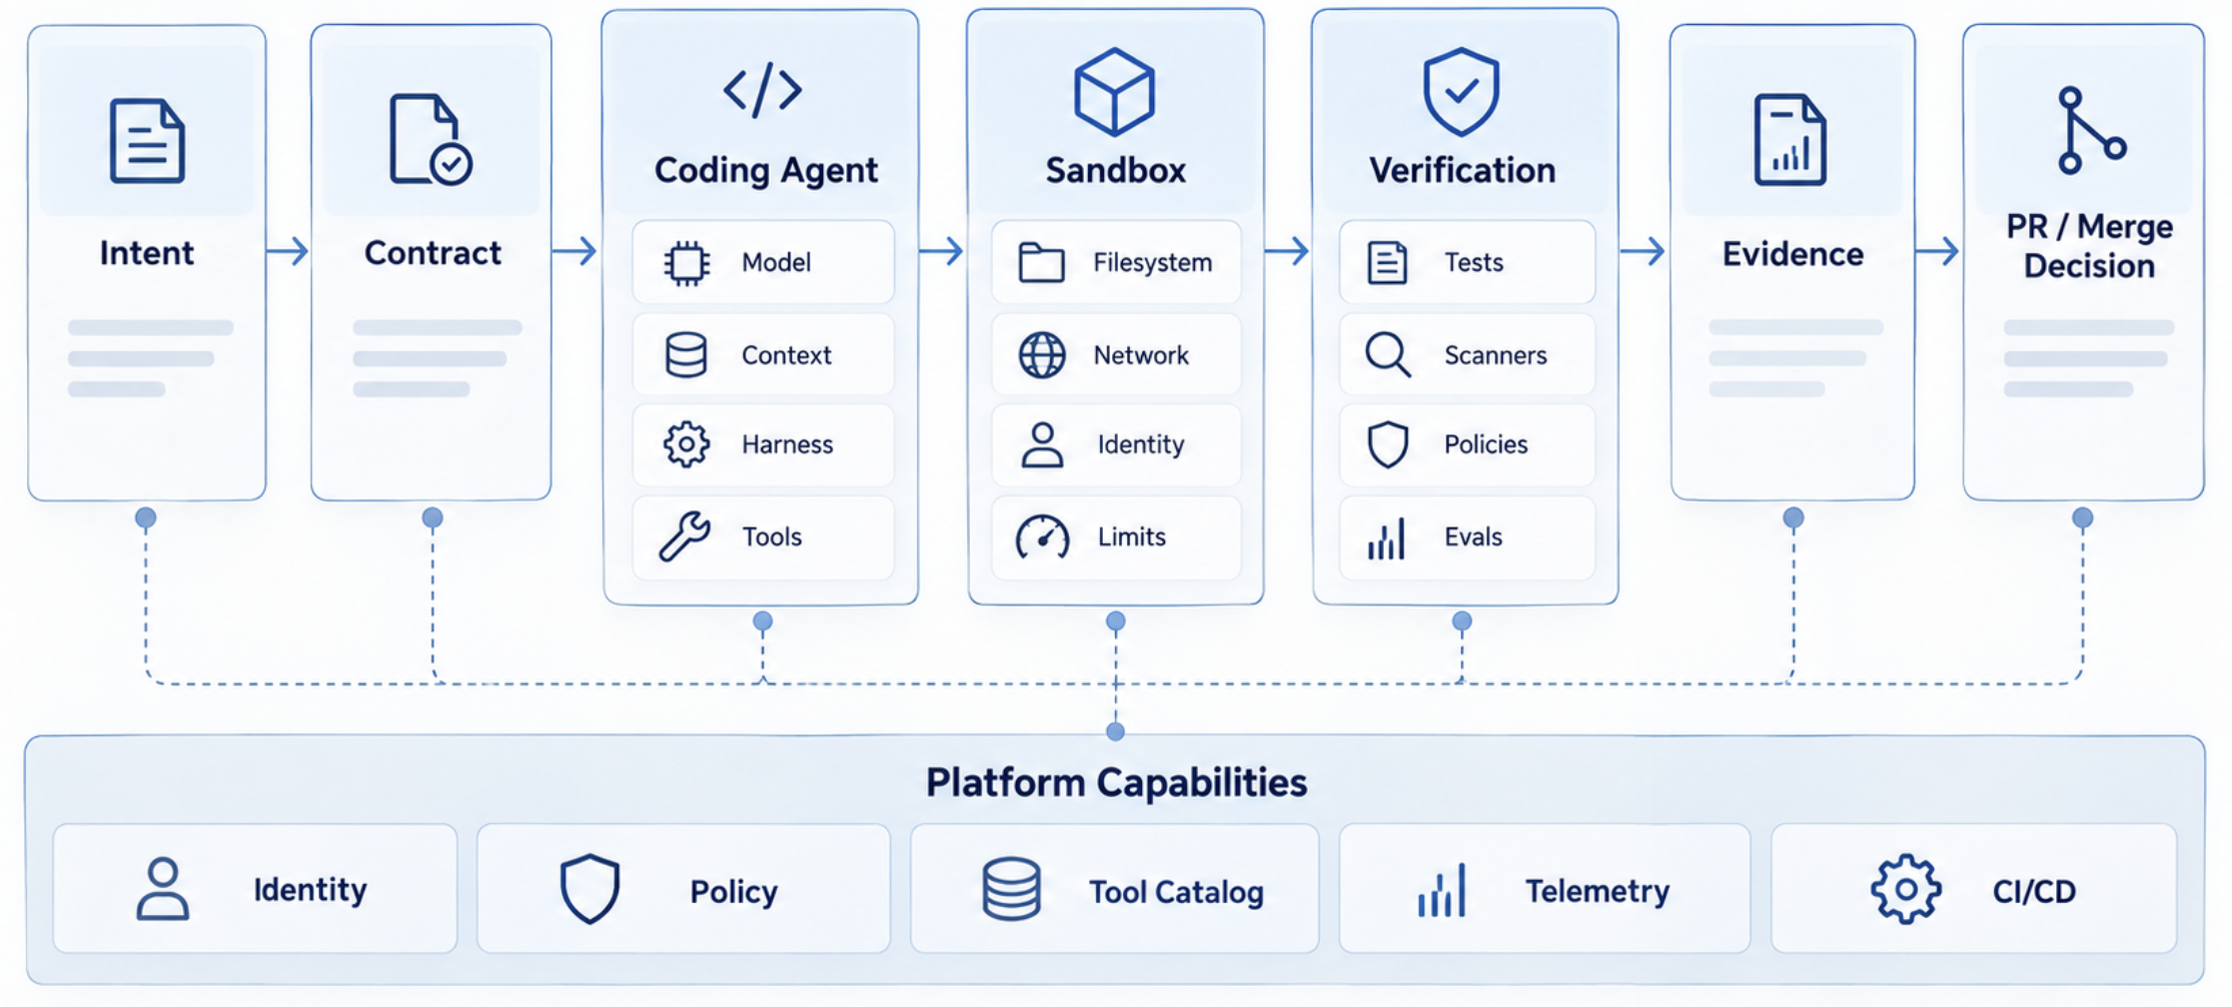
A sequência que uso como referência é:
Intent → Contract → Agent → Sandbox → Verification → Evidence → Merge
 Ampliar ↗
Ela não representa necessariamente um pipeline linear. Algumas etapas podem se repetir e outras podem acontecer em paralelo. O objetivo é identificar quais responsabilidades precisam existir e onde elas deveriam ficar.
O agente entra em um SDLC que já existe#
Imagine um desenvolvedor pedindo:
adicionar suporte a um novo tipo de transferência na API.
Um coding agent consegue localizar arquivos, alterar código, criar testes e executar comandos. Dependendo das ferramentas disponíveis, pode chegar até a criação de um pull request.
Mas o pedido inicial não contém necessariamente as regras que determinam se a implementação está correta:
Qual contrato da API deve permanecer compatível?
Como a aplicação trata idempotência?
Quais bibliotecas podem ser usadas?
Que comportamento é esperado quando o serviço externo está indisponível?
Existem requisitos específicos para logs ou dados sensíveis?
Em um fluxo exclusivamente humano, parte desse conhecimento costuma estar espalhada entre documentação, código, experiência do time e processo de review. Um agente também pode recuperar algumas dessas informações, mas a qualidade dessa recuperação passa a influenciar diretamente a mudança que ele produz.
Para uma plataforma, isso cria um problema de interface. A tarefa precisa chegar ao agente acompanhada de contexto suficiente para execução e de critérios que possam ser usados posteriormente para verificar o resultado.
O contrato precisa atravessar o fluxo#
Já tratei anteriormente de spec-driven development e do papel de especificações, critérios de aceite e restrições na geração de código. Aqui, o interesse está no que acontece com esse contrato depois que o agente começa a trabalhar.
Ele não deveria existir apenas como texto usado no primeiro prompt. Se a tarefa define que determinada operação precisa ser idempotente, esse requisito pode orientar a geração, aparecer em testes e ser verificado posteriormente. Se uma dependência é proibida, o mesmo critério pode ser consumido por um scanner ou quality gate.
Isso permite que diferentes componentes trabalhem sobre a mesma referência.
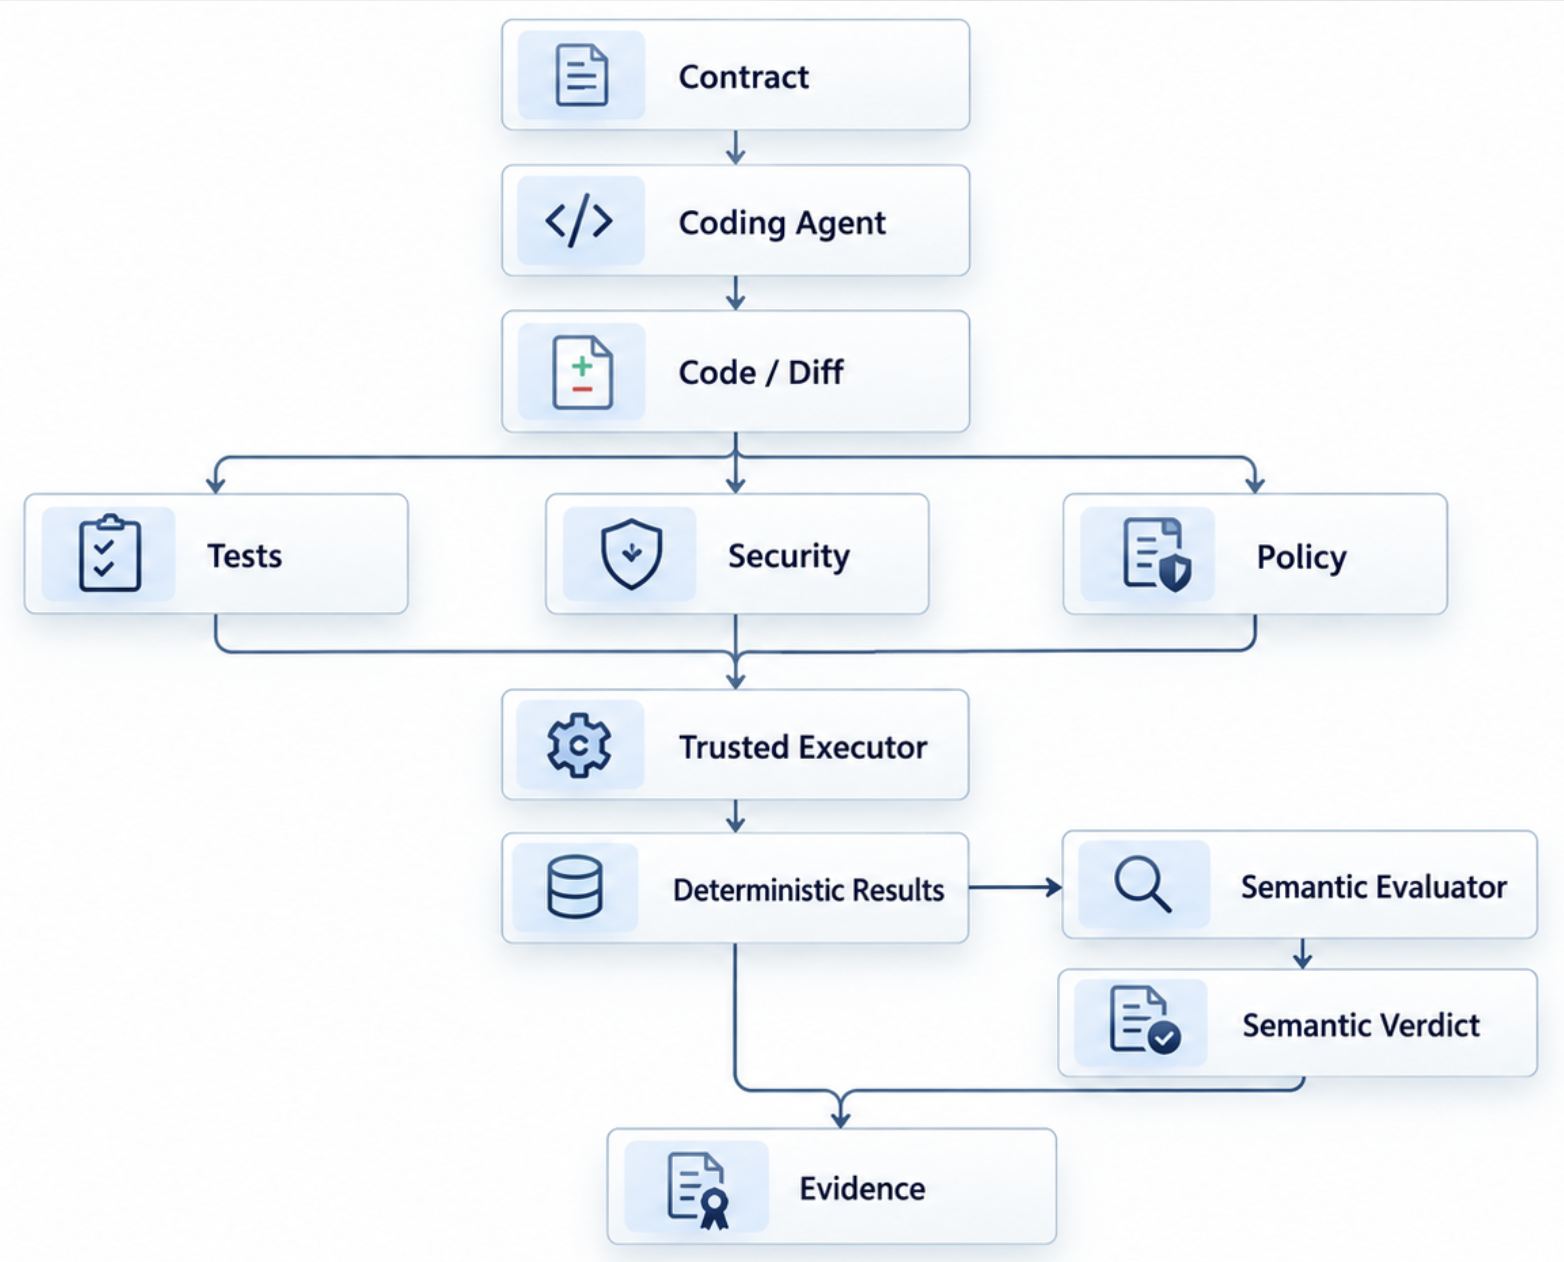
O builder usa o contrato para construir uma proposta. O executor roda os comandos definidos para aquele tipo de projeto. Os verificadores produzem resultados. Um evaluator pode comparar propriedades que não são facilmente verificadas de forma determinística. O pipeline usa esses resultados antes de permitir promoção.
A implementação pode variar bastante entre empresas. O ponto importante é evitar que cada etapa reconstrua a intenção original a partir do output da etapa anterior, porque uma regra que começou explícita pode desaparecer no caminho.
Execução precisa de fronteiras conhecidas#
Um coding agent capaz de alterar arquivos e executar comandos possui uma superfície de ação consideravelmente maior que um assistente que apenas sugere código.
A plataforma precisa decidir onde essa execução ocorre. Para alguns workloads, um workspace local controlado pode ser suficiente; outros podem justificar sandboxes efêmeros ou ambientes remotos isolados.
Independentemente da implementação, eu tentaria tornar explícitos alguns limites: filesystem acessível, rede disponível, recursos computacionais, duração da execução, credenciais e ferramentas.
Credenciais permanentes no ambiente do agente aumentam desnecessariamente a autoridade disponível durante a execução. Quando uma operação realmente exige acesso a outro sistema, credenciais curtas ou workload identity oferecem uma fronteira melhor do que reutilizar segredos de longa duração do desenvolvedor.
O mesmo raciocínio vale para ferramentas: MCPs e outras integrações podem ser oferecidos por meio de um catálogo corporativo com permissões conhecidas. Uma ferramenta de documentação pode ter acesso somente leitura. Um serviço capaz de alterar infraestrutura pode exigir outra política de autorização, porque a plataforma não precisa tratar todas as tarefas como se tivessem o mesmo risco.
Verificação precisa acontecer fora do agente#
Um agente pode escrever código, criar testes e revisar o próprio diff. Essas capacidades são úteis, mas eu não colocaria toda a decisão de qualidade dentro do mesmo loop que produziu a mudança.
Há verificações que já possuem mecanismos determinísticos muito melhores. Compilação, testes, lint, análise estática, dependency scanning e policy checks pertencem naturalmente a um executor confiável cuja execução não depende da decisão do modelo de chamá-los ou não.
Isso cria uma separação útil, onde o agente produz uma proposta de mudança e o executor produz evidências sobre aquela proposta.
 Ampliar ↗
Algumas propriedades continuam difíceis de reduzir a um exit code. Aderência a uma convenção arquitetural, por exemplo, pode exigir avaliação semântica. Nesses casos, um evaluator separado pode ser útil, desde que o seu verdict não seja tratado como verdade absoluta.
A avaliação precisa ter escopo claro e, quando possível, ser calibrada contra exemplos conhecidos.
Essa separação também facilita a evolução. Trocar o coding agent não deveria exigir reconstruir todos os quality gates. Alterar um evaluator não deveria mudar a forma como a aplicação compila ou executa seus testes.
Evidência precisa nascer durante a execução#
Quando o fluxo começa a envolver agente, tools, sandbox e diferentes verificadores, guardar apenas o diff final elimina boa parte do contexto necessário para entender como aquela mudança foi produzida.
Eu criaria um identificador de execução que atravessasse o fluxo.
A partir dele, seria possível correlacionar informações como versão do contrato, modelo utilizado, versão das instruções ou harness, ferramentas acionadas, comandos executados, diff produzido, resultados do executor e verdicts dos evaluators.
Isso não significa registrar indiscriminadamente todos os prompts, arquivos e outputs.
O nível de evidência depende do risco e das regras de privacidade da organização. Muitas vezes, metadados, hashes, versões, resultados e referências aos artefatos já permitem reconstruir o caminho relevante sem transformar observabilidade em uma cópia permanente de todo o contexto do desenvolvedor.
O que me interessa nessa camada é a capacidade de responder perguntas operacionais depois.
Qual contrato estava em vigor quando esse código foi produzido? Que versão do agente executou a tarefa? Os testes obrigatórios passaram? Algum gate foi ignorado? O evaluator que aprovou a mudança era o mesmo usado hoje?
Essas respostas dependem de correlação entre as evidências; caso contrário, cada sistema conserva apenas uma parte da história.
Merge continua sendo uma decisão de autoridade#
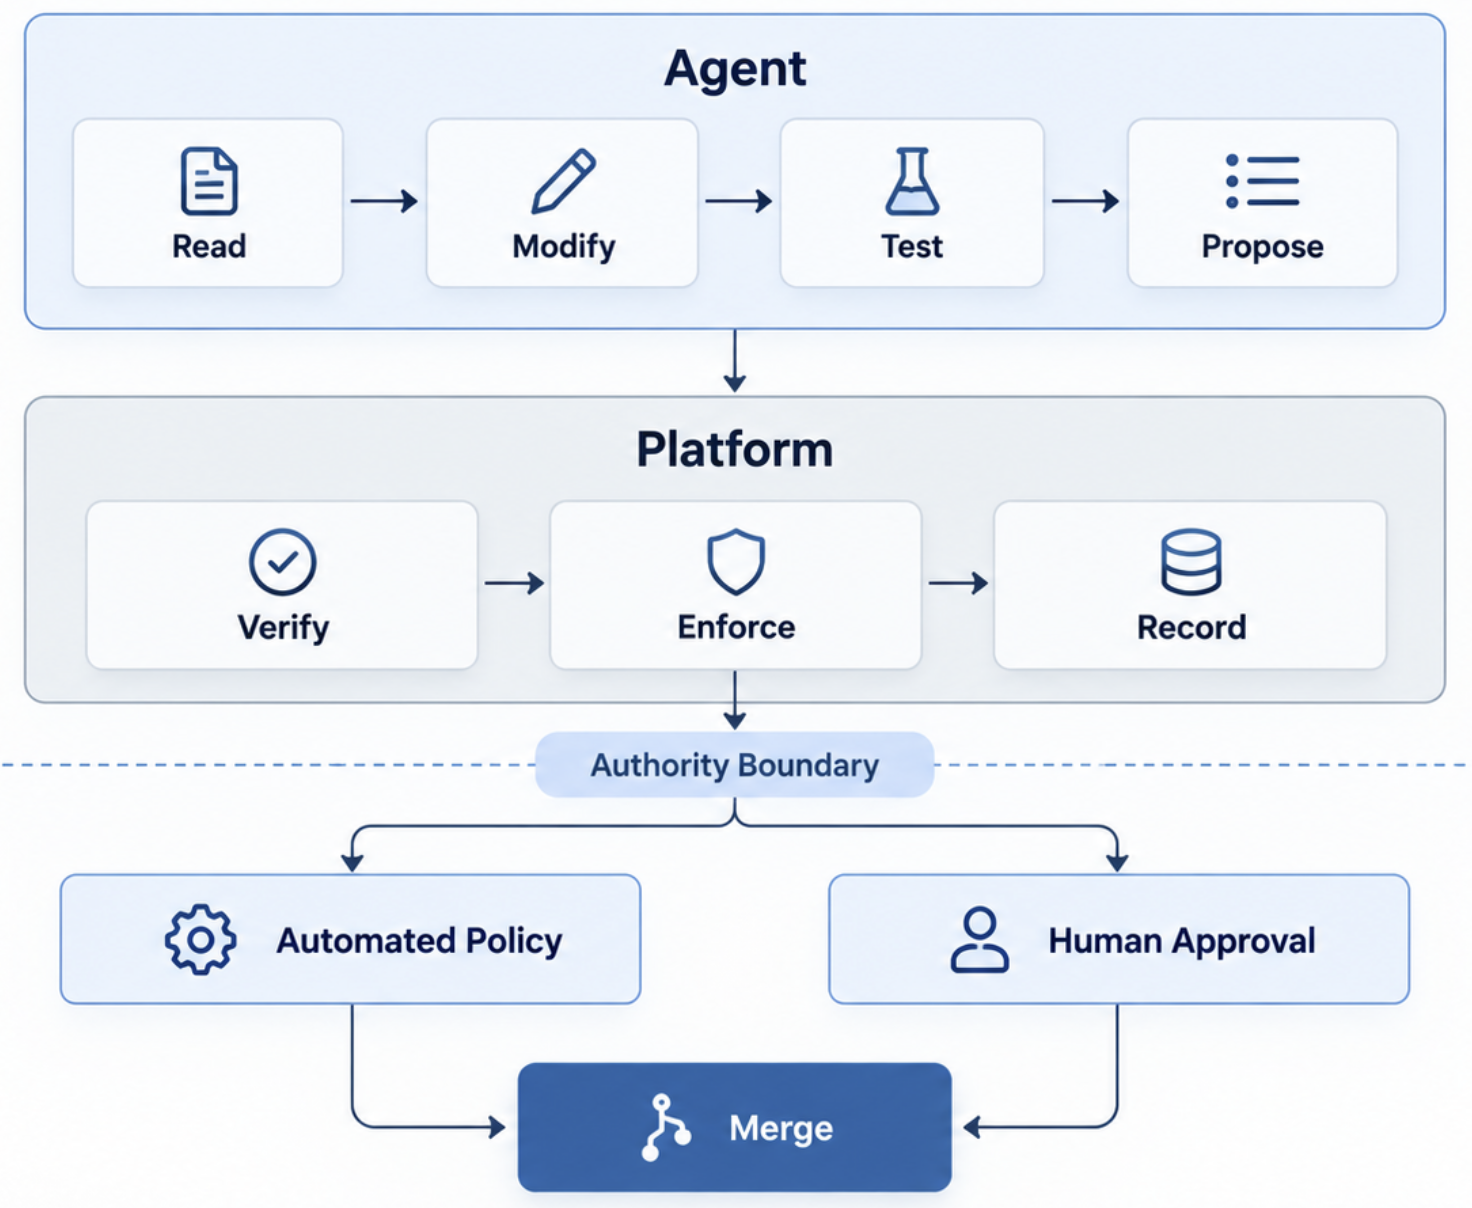
Ao final do fluxo existe uma diferença importante entre produzir uma mudança e ter autoridade para promovê-la.
O coding agent pode preparar o diff e abrir o PR. O executor pode confirmar que os checks passaram. Um evaluator pode fornecer um verdict adicional.
Nada disso exige que o próprio agente tenha autoridade para decidir o merge.
 Ampliar ↗
Essa decisão pode continuar distribuída entre branch policies, CODEOWNERS, quality gates e aprovação humana, de acordo com a criticidade da mudança.
Uma alteração pequena de documentação pode ter um caminho quase automático. Uma modificação de regra financeira pode exigir revisão de pessoas específicas. Uma mudança de infraestrutura pode seguir outro conjunto de políticas.
HITL faz mais sentido quando a revisão está associada a uma decisão concreta de autoridade. Inserir aprovação humana em cada ação do agente cria uma sequência de confirmações que tende a ser ignorada com o tempo.
A plataforma precisa saber qual decisão exige aprovação e por quê.
Quando essas peças viram plataforma#
É possível implementar cada componente acima dentro de um único repositório. O problema aparece quando dezenas ou centenas de times começam a reconstruir as mesmas integrações.
Um cria seu próprio sandbox. Outro escreve hooks diferentes. Um terceiro mantém uma lista local de MCPs. Cada pipeline registra evidência em um formato próprio.
Nesse ponto, parte do Agentic SDLC começa a se aproximar de Platform Engineering.
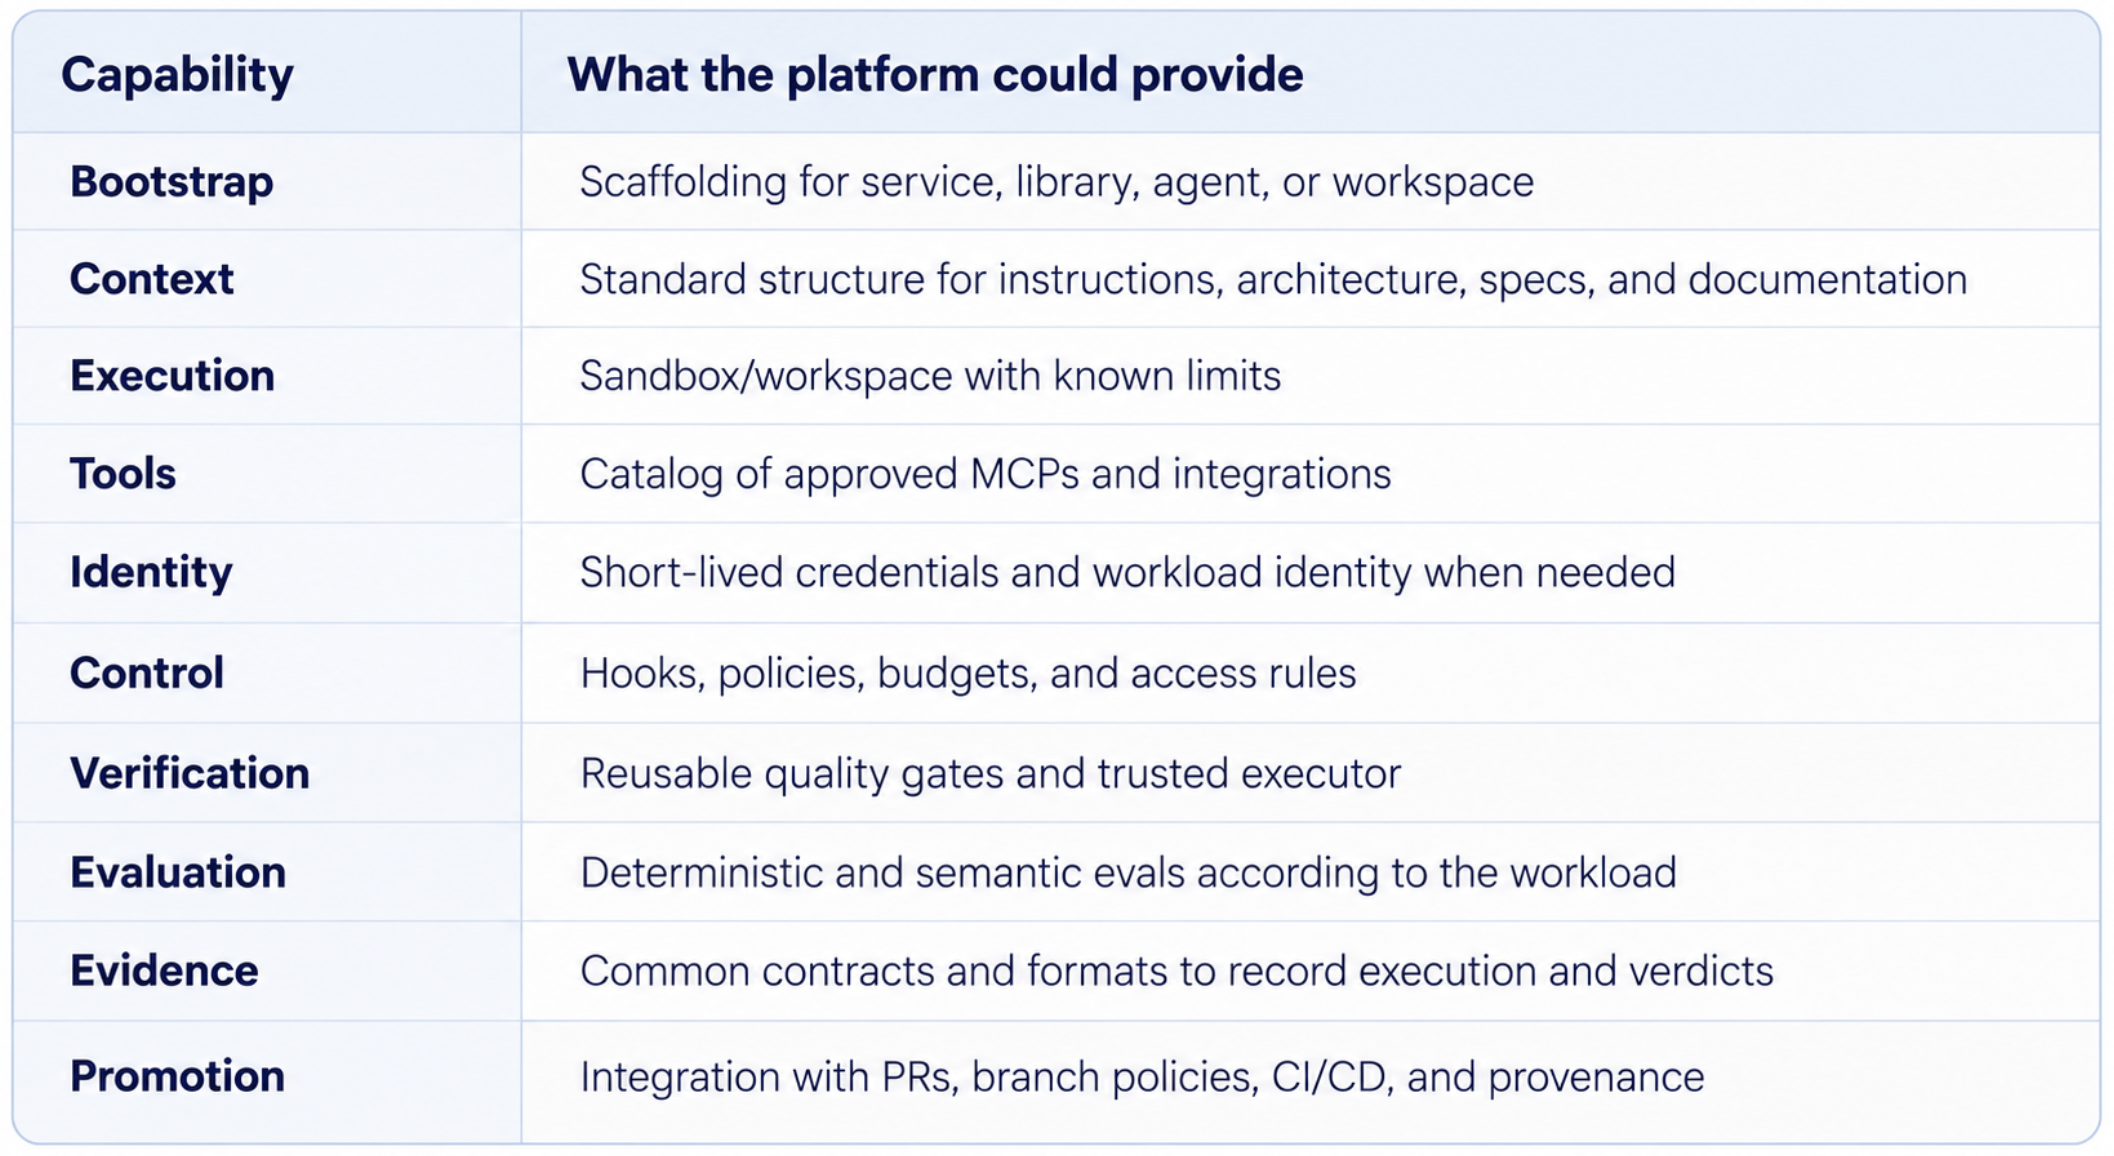
A plataforma pode oferecer um conjunto reutilizável de capabilities:
 Ampliar ↗
Eu não esperaria que todos os times utilizassem todas essas capabilities.
Uma biblioteca Python simples provavelmente precisa de muito menos infraestrutura que um agente com acesso a serviços internos. A vantagem da plataforma está em oferecer componentes conhecidos para que o time não precise começar do zero quando determinada capacidade for necessária.
Também evitaria transformar o golden path em um caminho obrigatório que só funciona para o caso mais comum.
Ele precisa ser o caminho mais fácil quando se aplica e permitir extensões quando o workload realmente exige algo diferente.
A plataforma precisa competir com o atalho#
Existe uma consequência prática que às vezes fica fora do desenho arquitetural.
Se configurar o ambiente corporativo exige abrir chamados, copiar arquivos manualmente, esperar credenciais e descobrir sozinho quais tools são permitidas, os desenvolvedores encontrarão um caminho mais curto.
Esse comportamento já é conhecido em plataformas internas e não surgiu com IA.
Scaffolding, documentação, distribuição de configuração, onboarding e suporte fazem parte da capability tanto quanto os controles técnicos.
Um hook perfeito que nunca chega corretamente à máquina do desenvolvedor não protege o fluxo. Um MCP corporativo difícil de descobrir compete com integrações locais mais fáceis. Uma policy tecnicamente correta, mas incompatível com o workflow diário, cria pressão para exceções.
Por isso eu trataria Developer Experience como parte do desenho da plataforma, e não apenas como uma métrica posterior de satisfação.
Como eu começaria#
Eu não tentaria construir toda essa plataforma antes de colocar o primeiro time para trabalhar.
Escolheria uma classe de aplicação e um conjunto de tarefas suficientemente representativos para descobrir quais interfaces realmente precisam ser compartilhadas.
Por exemplo, um serviço backend com CI já estruturado oferece um bom ambiente para testar scaffolding, contexto, sandbox, execução de testes, evidência e promoção sem introduzir todos os problemas possíveis ao mesmo tempo.
O piloto também deveria ter baseline:
Quanto tempo essas tarefas levam hoje?
Onde o desenvolvedor espera?
Quais erros chegam ao review?
Quantos retornam depois dos gates?
Que partes do fluxo exigem intervenção manual?
A intenção não seria provar previamente que o Agentic SDLC aumenta produtividade. O piloto serviria para observar onde o agente altera o fluxo e quais componentes valem ser transformados em capability de plataforma.
Eu começaria investindo nos pontos que reduzem trabalho repetido entre times: estrutura de contexto, ambientes de execução conhecidos, catálogo de ferramentas, verificação reutilizável, contratos de evidência e integração com o processo de promoção.
Outras camadas provavelmente apareceriam à medida que os workloads ganhassem mais autoridade ou exigissem mais isolamento.
Do agente ao merge#
Quando olho para esse desenho, o coding agent ocupa uma parte importante, mas relativamente pequena do fluxo.
Antes dele existem intenção e contrato. Ao redor estão contexto, identidade, tools e limites de execução. Depois vêm verificações, evidências e decisões de promoção.
Neste recorte, Agentic SDLC como plataforma é o conjunto dessas responsabilidades e das interfaces que permitem que elas funcionem de forma consistente entre projetos.
Para evoluir esse desenho, eu priorizaria interfaces claras entre os componentes, ownership definido e um golden path que os times consigam adotar sem reconstruir a arquitetura a cada projeto.