Parte 2 de 2 - Medindo engenharia na era dos agentes
Na primeira parte desta série, separei duas perguntas que costumam aparecer misturadas: quanto os times estão usando IA e quanto o sistema de engenharia melhorou depois desse uso. Tokens, sessões, agent runs e custo ajudam bastante na primeira. Para responder à segunda, precisamos observar outras partes do fluxo e comparar a mudança com alguma referência.
Eu começaria pela hipótese, não pelo dashboard.
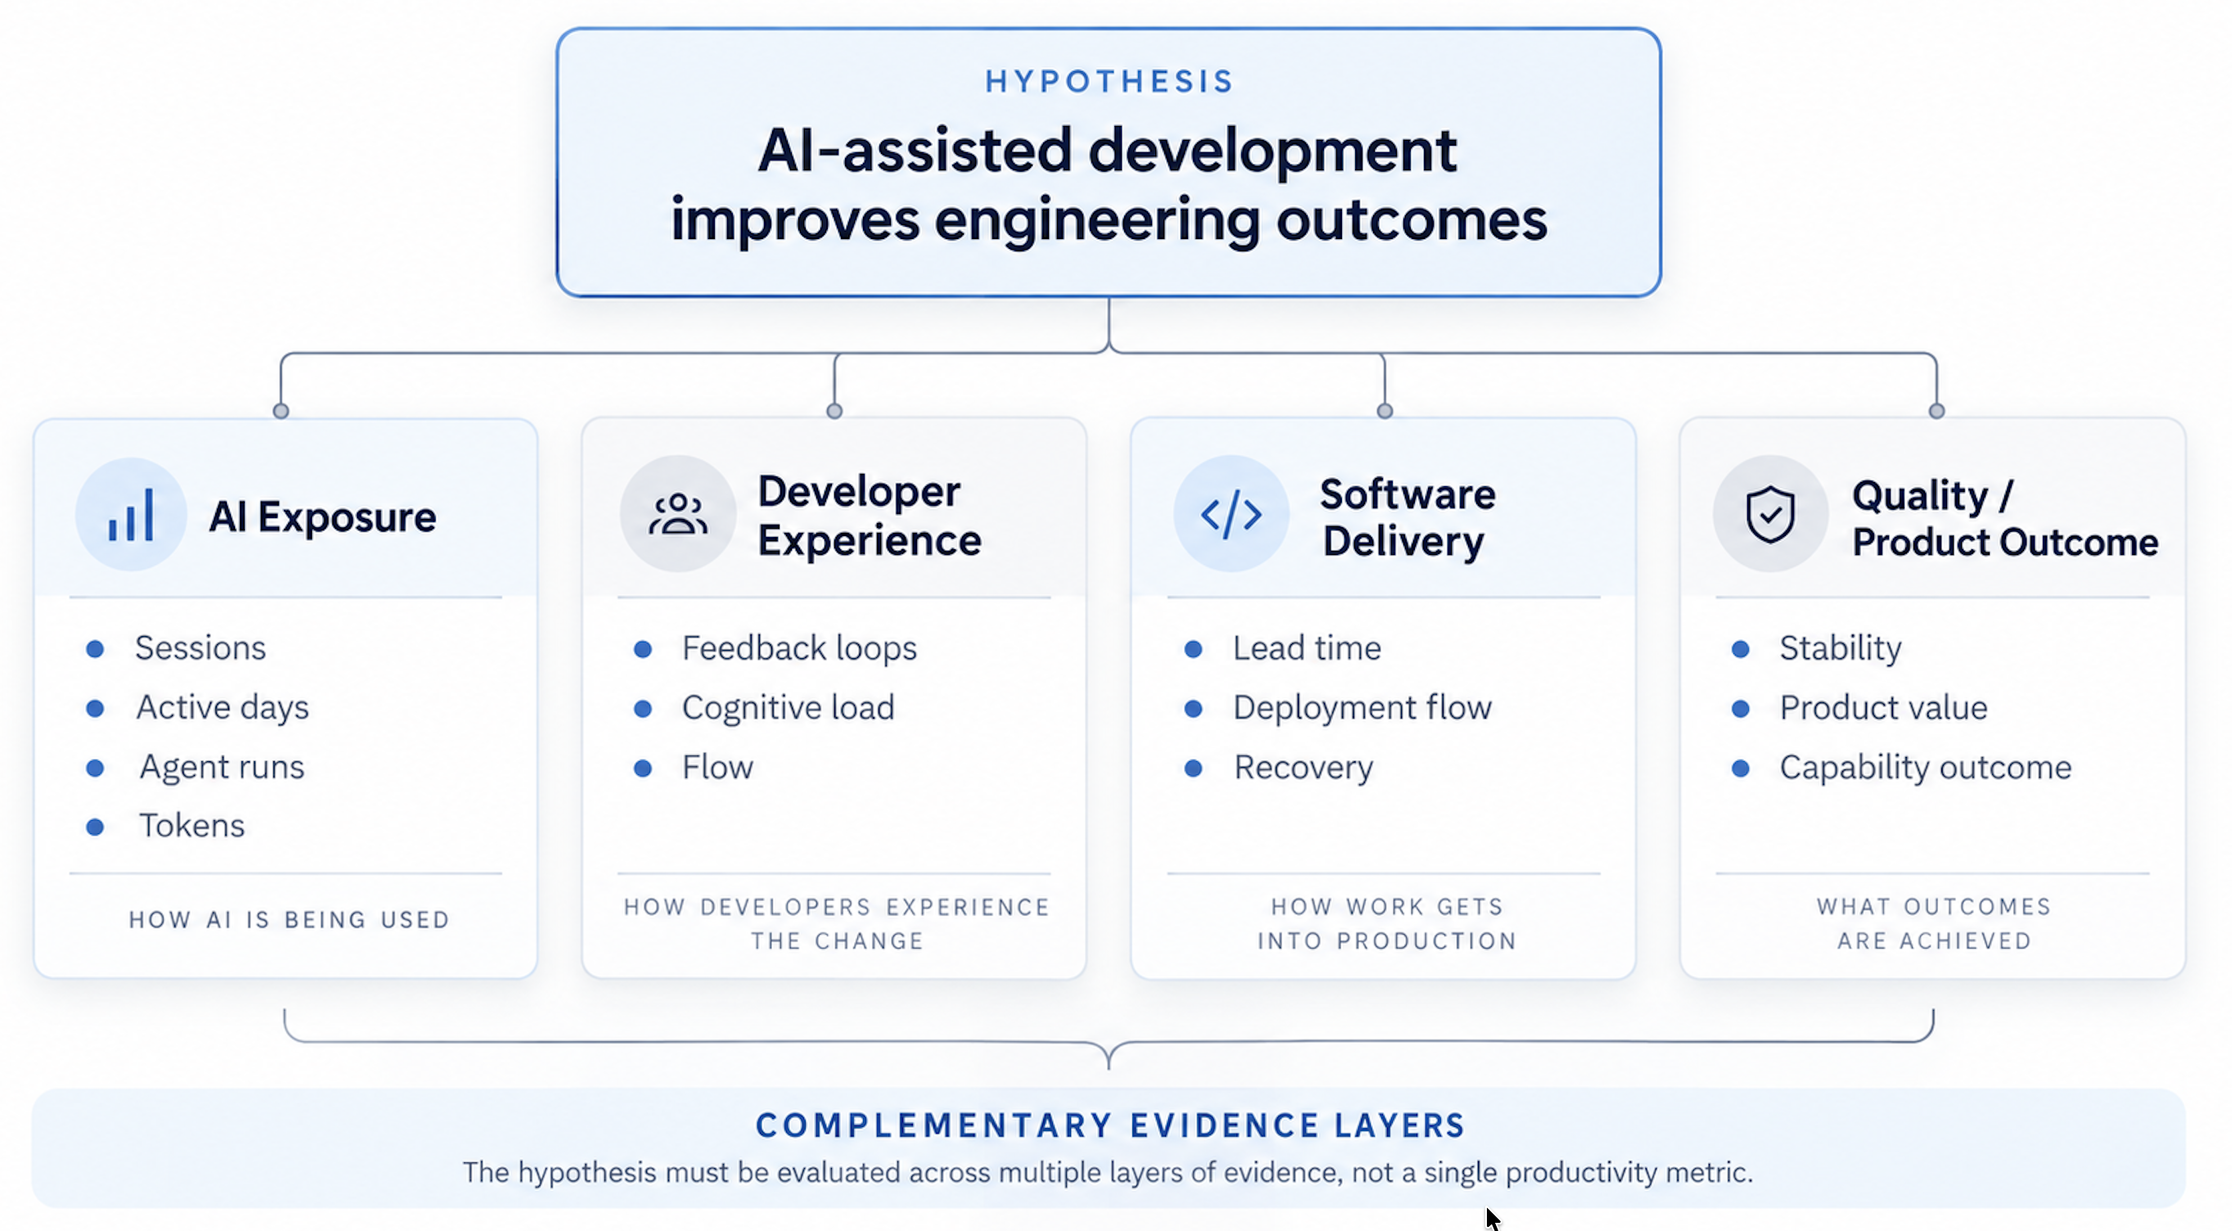
Suponha que uma empresa esteja ampliando o uso de coding agents e queira saber se o investimento está produzindo ganho real. Uma hipótese possível seria: desenvolvedores com maior exposição à ferramenta conseguem levar mudanças até produção em menos tempo, com menor fricção no trabalho e sem aumento relevante de falhas ou retrabalho.
Essa formulação já distribui a análise por diferentes dimensões. O tempo até produção pertence ao fluxo de software delivery. Fricção exige observar a experiência de quem desenvolve. Falhas e retrabalho precisam aparecer como contrapeso à velocidade. E, para estimar se a diferença está associada ao uso de IA, precisamos comparar grupos e períodos de forma minimamente defensável.
 Ampliar ↗
DORA observa o fluxo até produção#
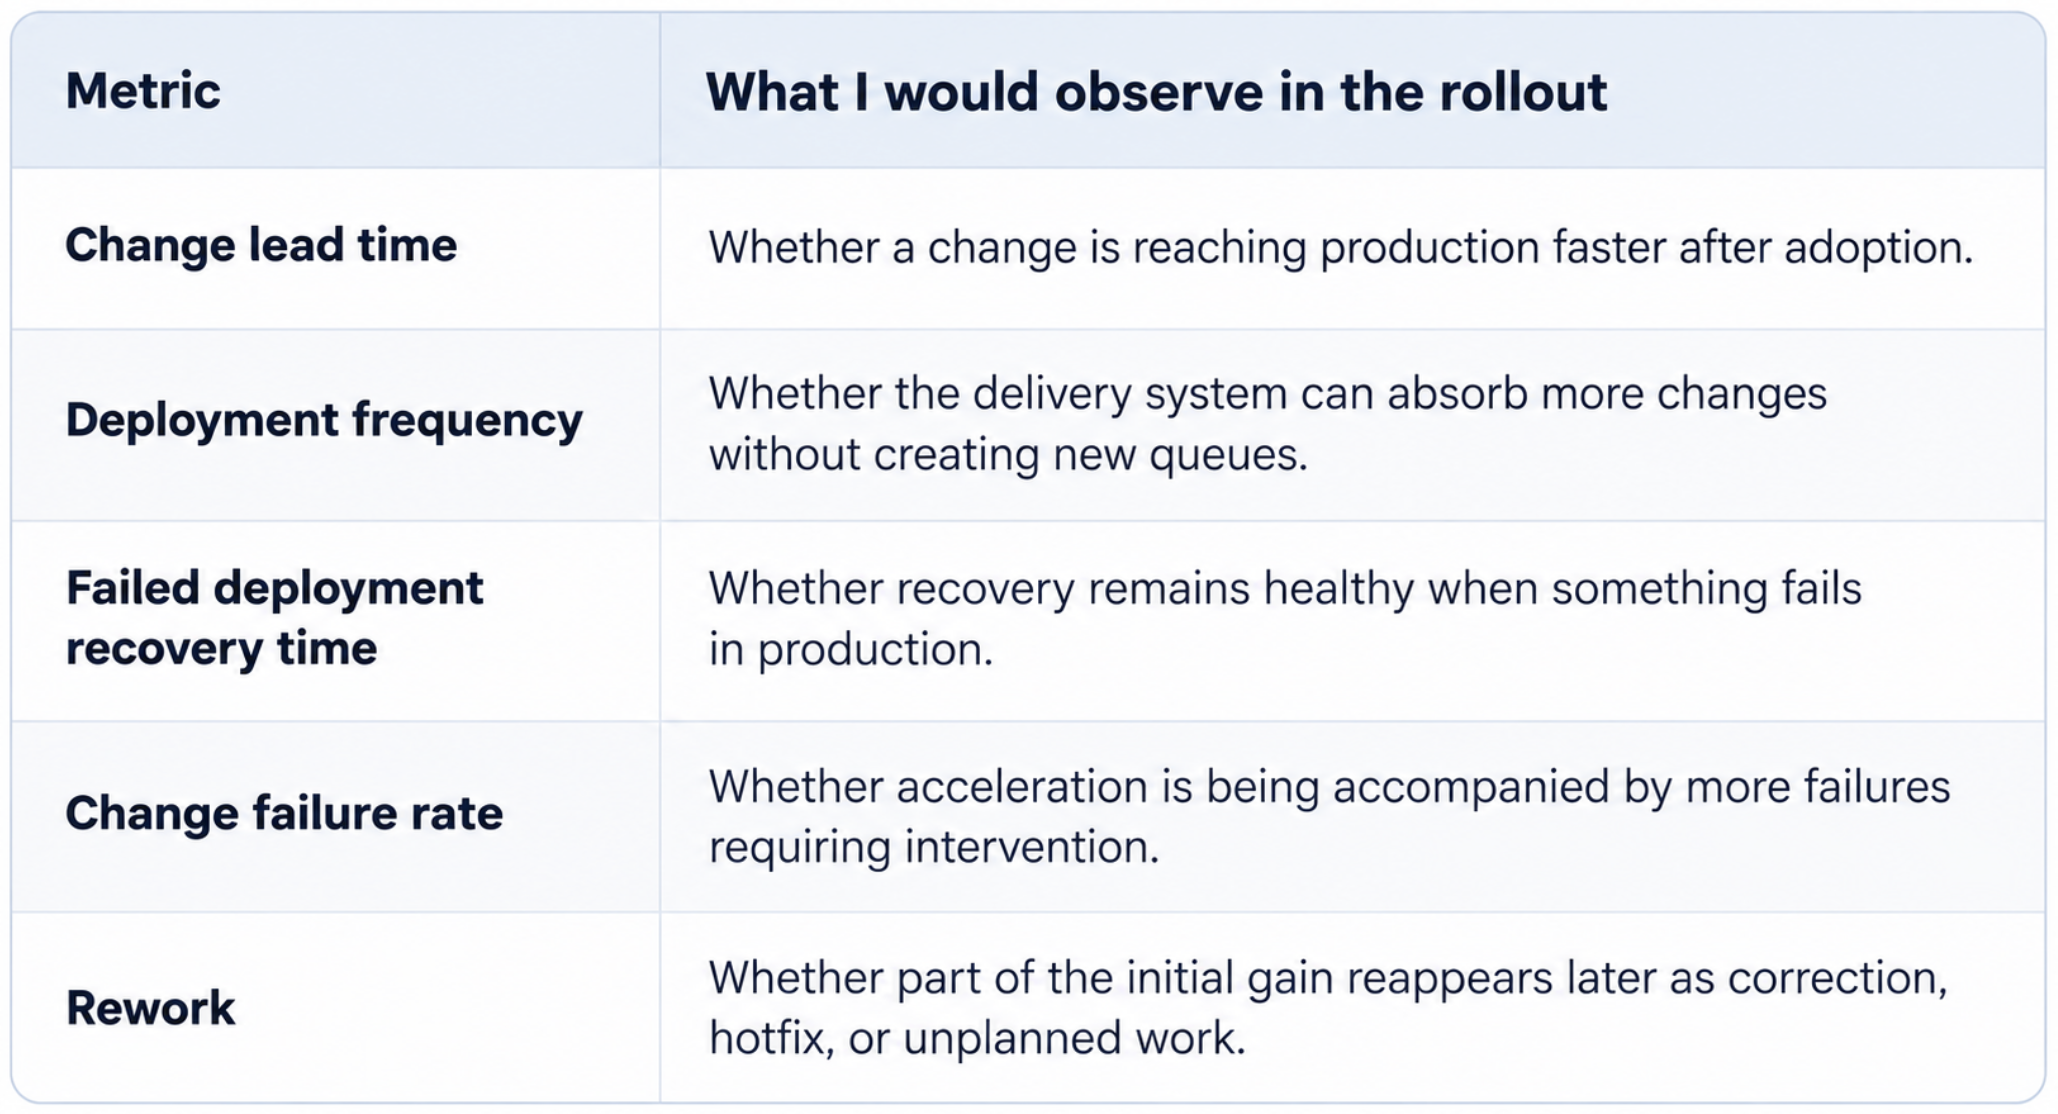
O DORA (DevOps Research and Assessment), programa de pesquisa ligado ao Google Cloud, é uma referência útil para observar software delivery. Hoje, a discussão inclui métricas como deployment frequency, change lead time, change failure rate, failed deployment recovery time e rework. Um caso publicado pelo Google Cloud em 2026 sobre a FINRA (Autoridade Reguladora da Indústria Financeira - EUA) mostra essas métricas sendo usadas de forma adaptada aos objetivos dos times, em vez de como um placar universal. FINRA builds a culture of improvement with DORA and DevOps.
 Ampliar ↗
Essas métricas são particularmente úteis porque um coding agent pode acelerar apenas a primeira parte do fluxo. O desenvolvedor chega mais rápido ao PR, mas o review continua congestionado. O PR entra antes no CI, mas a suíte é lenta ou instável. A geração fica mais rápida, mas a aprovação de segurança mantém a mesma fila. O tempo local melhora e o throughput do sistema quase não muda.
Também não usaria DORA para comparar produtividade individual. A unidade faz mais sentido no nível de aplicação, serviço ou fluxo de entrega. Colocar lado a lado um serviço novo, com pipeline automatizado, e um legado sujeito a aprovações externas produz diferenças que dizem muito sobre o contexto e pouco sobre a IA.
O relatório 2025 DORA State of AI-assisted Software Development é relevante justamente por tratar a adoção de IA como um problema de sistema. Ganhos locais podem existir sem aparecer de forma proporcional na performance do produto quando outras restrições continuam presentes.
Developer Experience mostra o que mudou no trabalho#
Há efeitos que podem aparecer antes de qualquer alteração visível em deployment frequency ou change lead time. Um agente pode reduzir o tempo gasto procurando uma API, acelerar a criação de testes ou facilitar a compreensão de um repositório. Também pode introduzir novas fricções: outputs que exigem muita validação, agent runs longos, alternância constante entre ferramenta e código ou aumento do volume que chega a review.
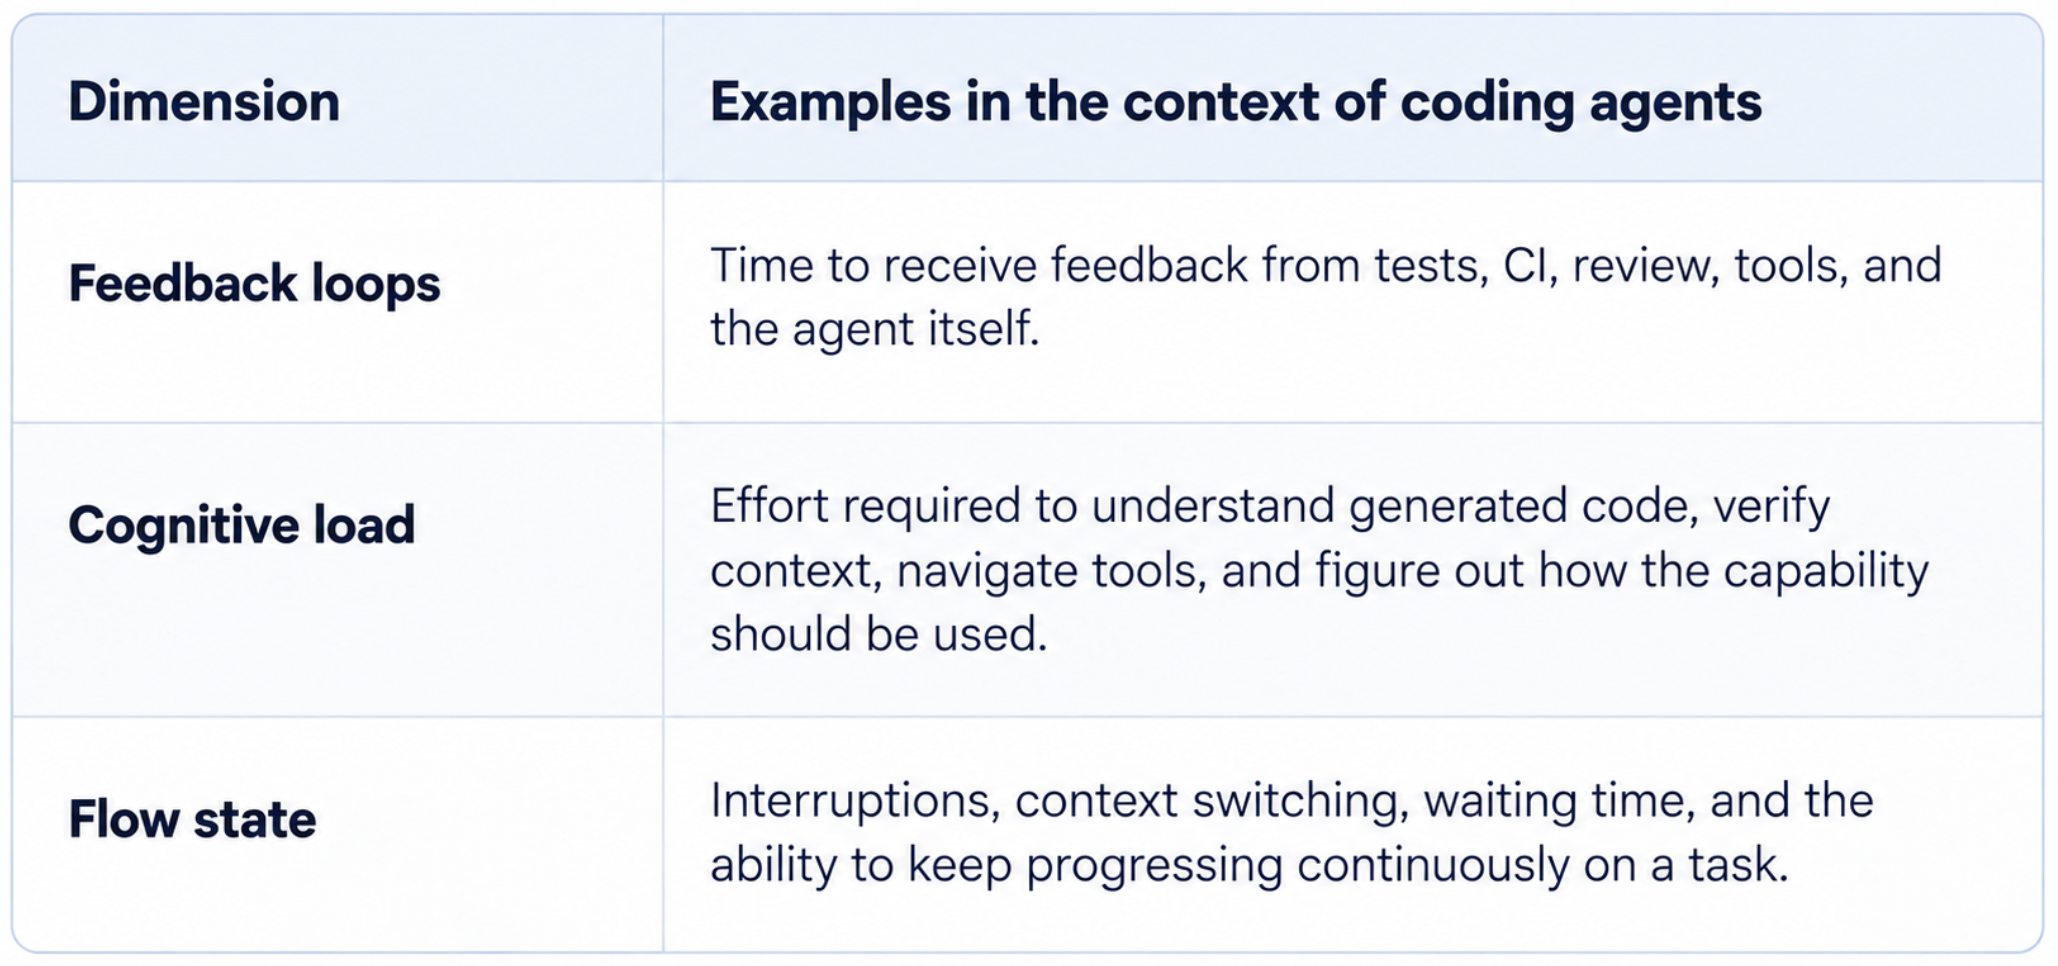
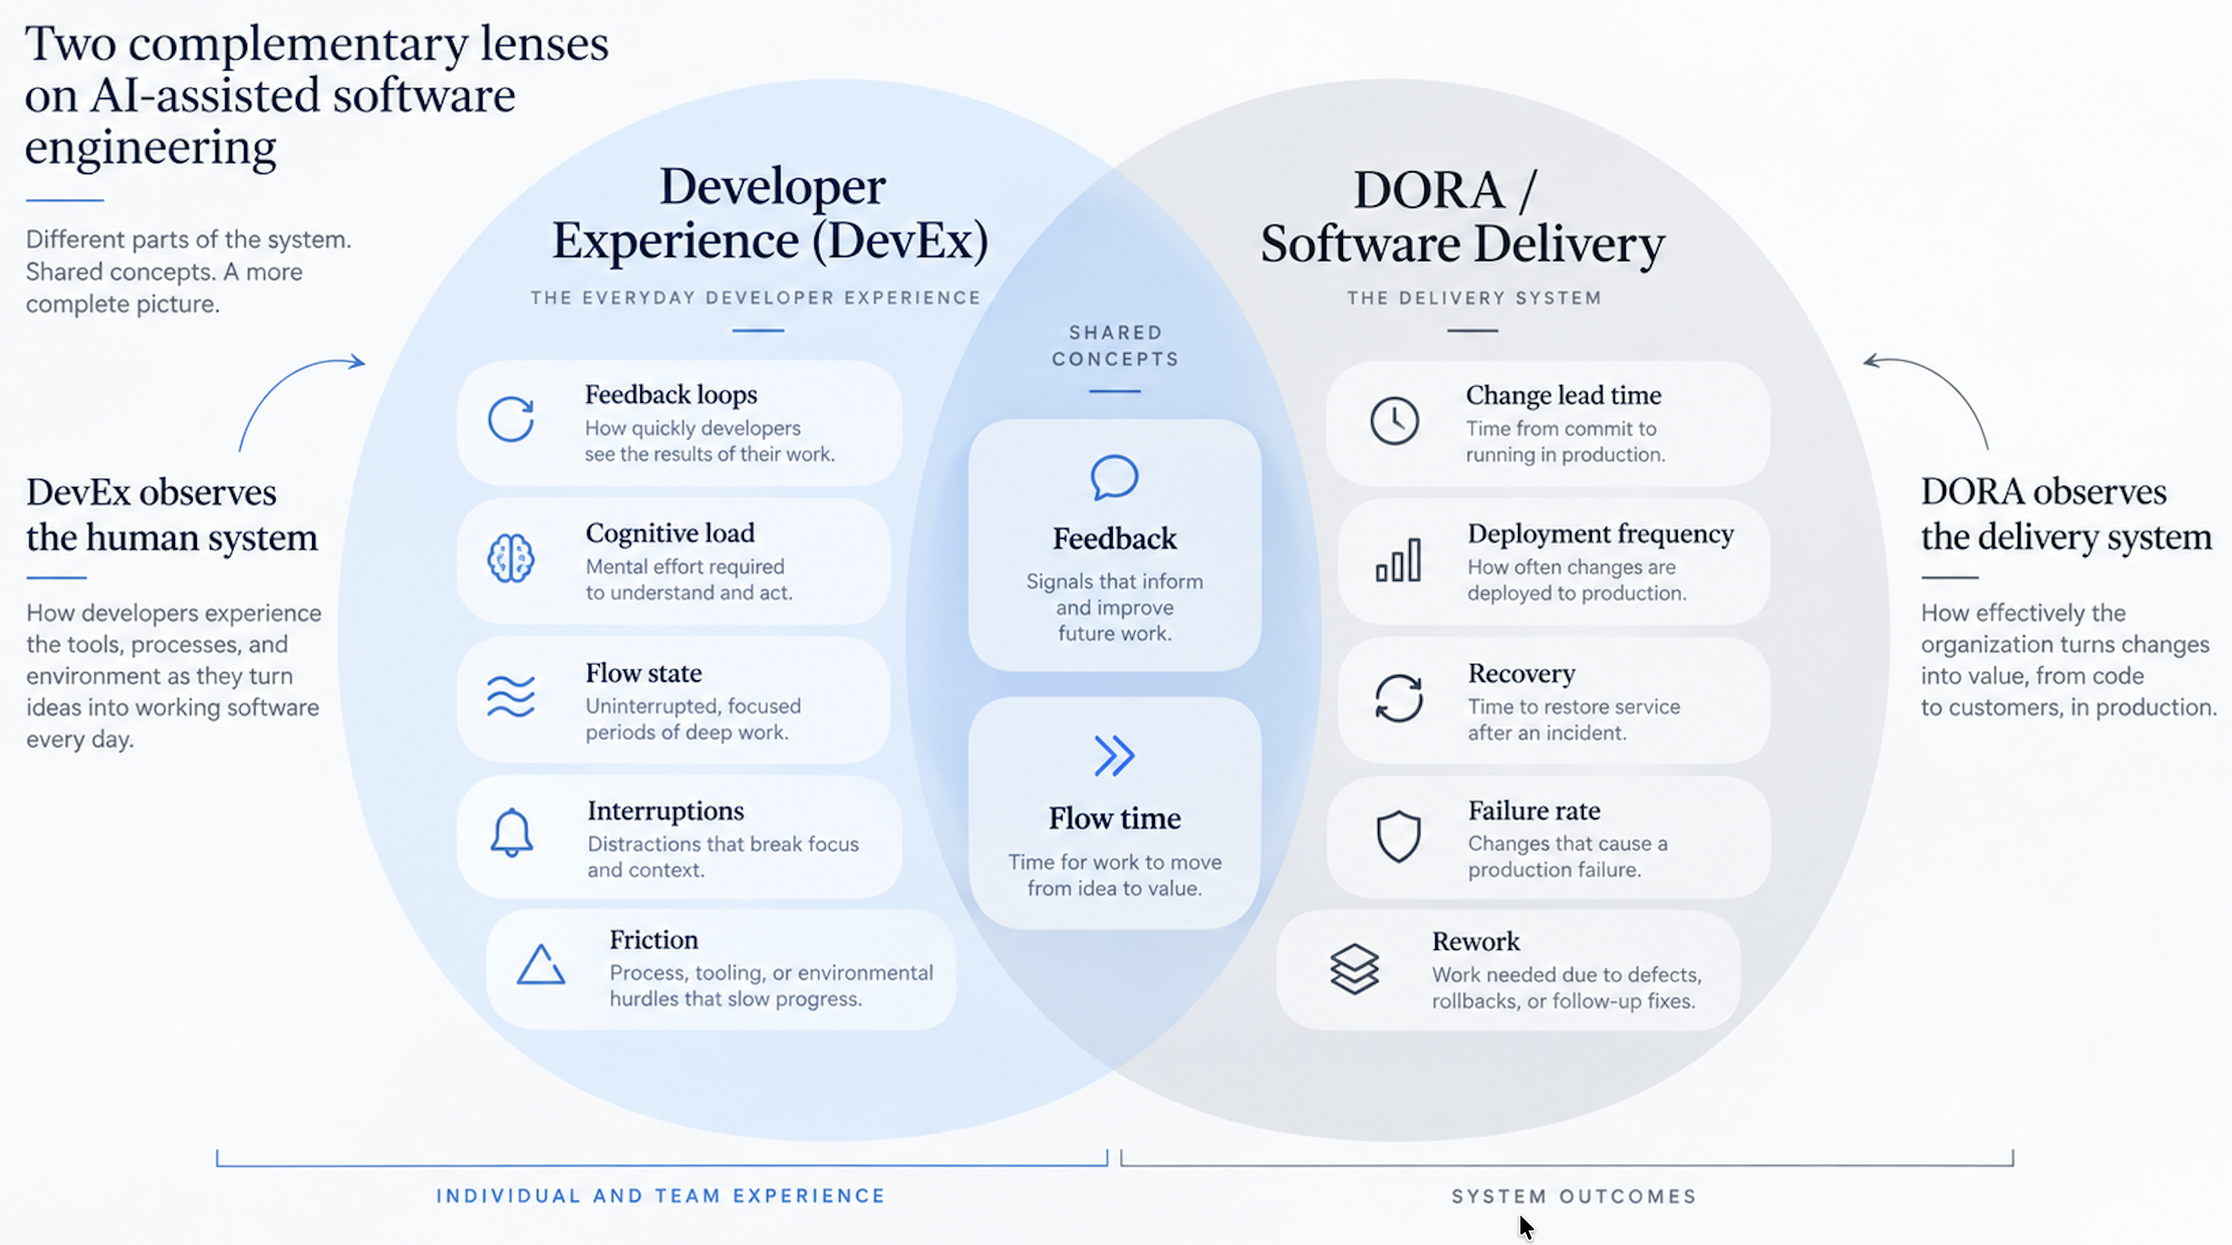
É por isso que eu colocaria Developer Experience ao lado de DORA. O framework apresentado em DevEx: What Actually Drives Productivity organiza essa experiência em três dimensões que funcionam bem para esse tipo de análise: feedback loops, cognitive load e flow state.
 Ampliar ↗
Eu combinaria dados do sistema com feedback dos desenvolvedores. Só survey pode capturar percepção e perder mudanças objetivas no fluxo. Só telemetria pode mostrar tempos e volumes sem explicar por que determinado passo virou fonte de fricção. A própria literatura de DevEx propõe combinar essas duas perspectivas.
O SPACE framework chega a uma conclusão compatível por outro caminho: produtividade de engenharia é multidimensional e não deve ser reduzida a uma única métrica. Para este experimento, eu não precisaria transformar SPACE em mais uma camada do dashboard; ele serve principalmente como lembrete metodológico para não confundir atividade com produtividade. The SPACE of Developer Productivity.
 Ampliar ↗
Coortes permitem comparar mudanças#
DORA e DevEx descrevem o que aconteceu. Para estudar se a adoção de IA está associada a uma mudança, é preciso comparar condições diferentes.
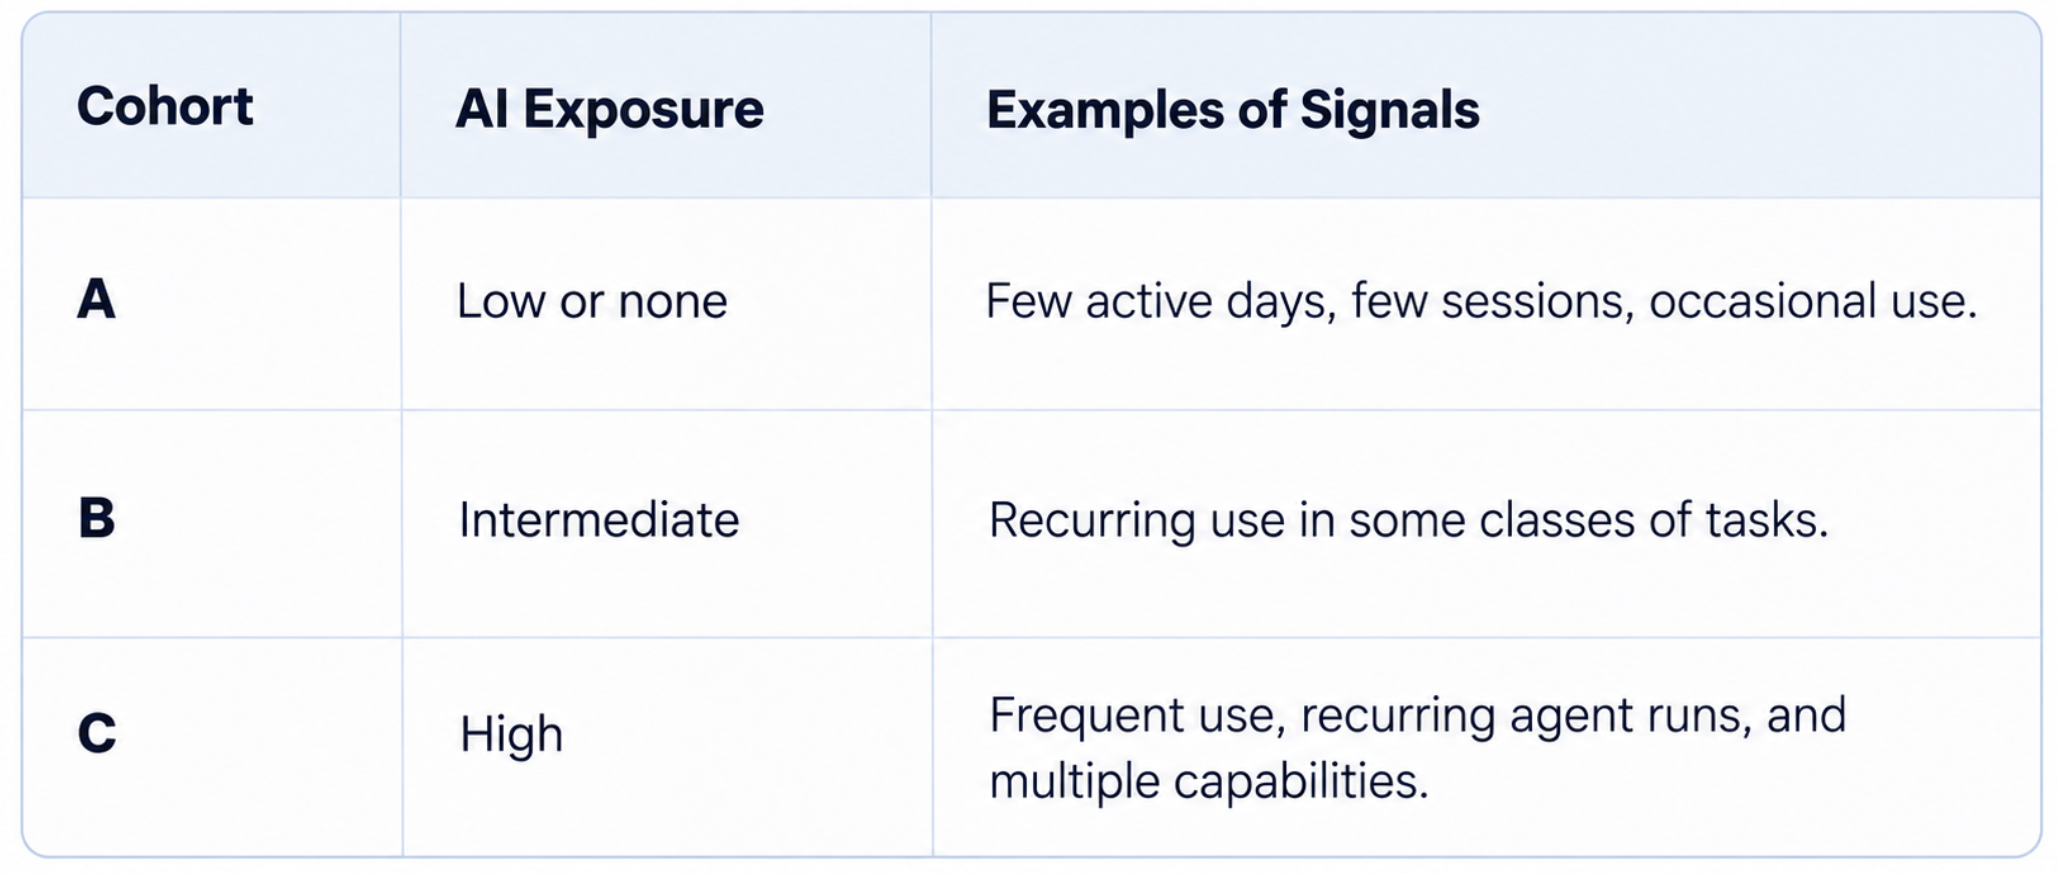
Na primeira parte, tratei exposição à IA como uma variável e não como resultado, o que continua aqui. Eu não classificaria os grupos apenas por tokens: usaria uma combinação de dias ativos, sessões, agent runs, tipos de tarefa, capabilities utilizadas e consumo. Isso reduz a chance de tratar uma única execução muito longa como equivalente a uso recorrente.
Uma segmentação inicial poderia ser simples:
 Ampliar ↗
Essa classificação ainda precisa de contexto. Modelo, ferramenta, disponibilidade de tools, versão do harness, treinamento recebido e maturidade da plataforma podem alterar os resultados. Eu registraria essas variáveis junto das coortes em vez de assumir que “usa coding agent” descreve exatamente a mesma intervenção para todos.
Nem sempre será possível manter um grupo sem IA. Um rollout gradual ajuda: alguns times recebem a capability antes de outros e funcionam temporariamente como referência. Quando a operação permitir, randomizar a ordem do rollout fortalece o desenho. Quando não permitir, eu tentaria parear grupos por domínio, senioridade, tipo de aplicação e maturidade do pipeline.
Antes e depois ainda é pouco#
Comparar apenas o mês anterior e o mês posterior ao rollout pode atribuir à IA uma mudança que aconteceria mesmo sem ela. O time pode ter terminado uma migração, melhorado o CI, reduzido a fila de review ou entrado em um período com menos releases complexas.
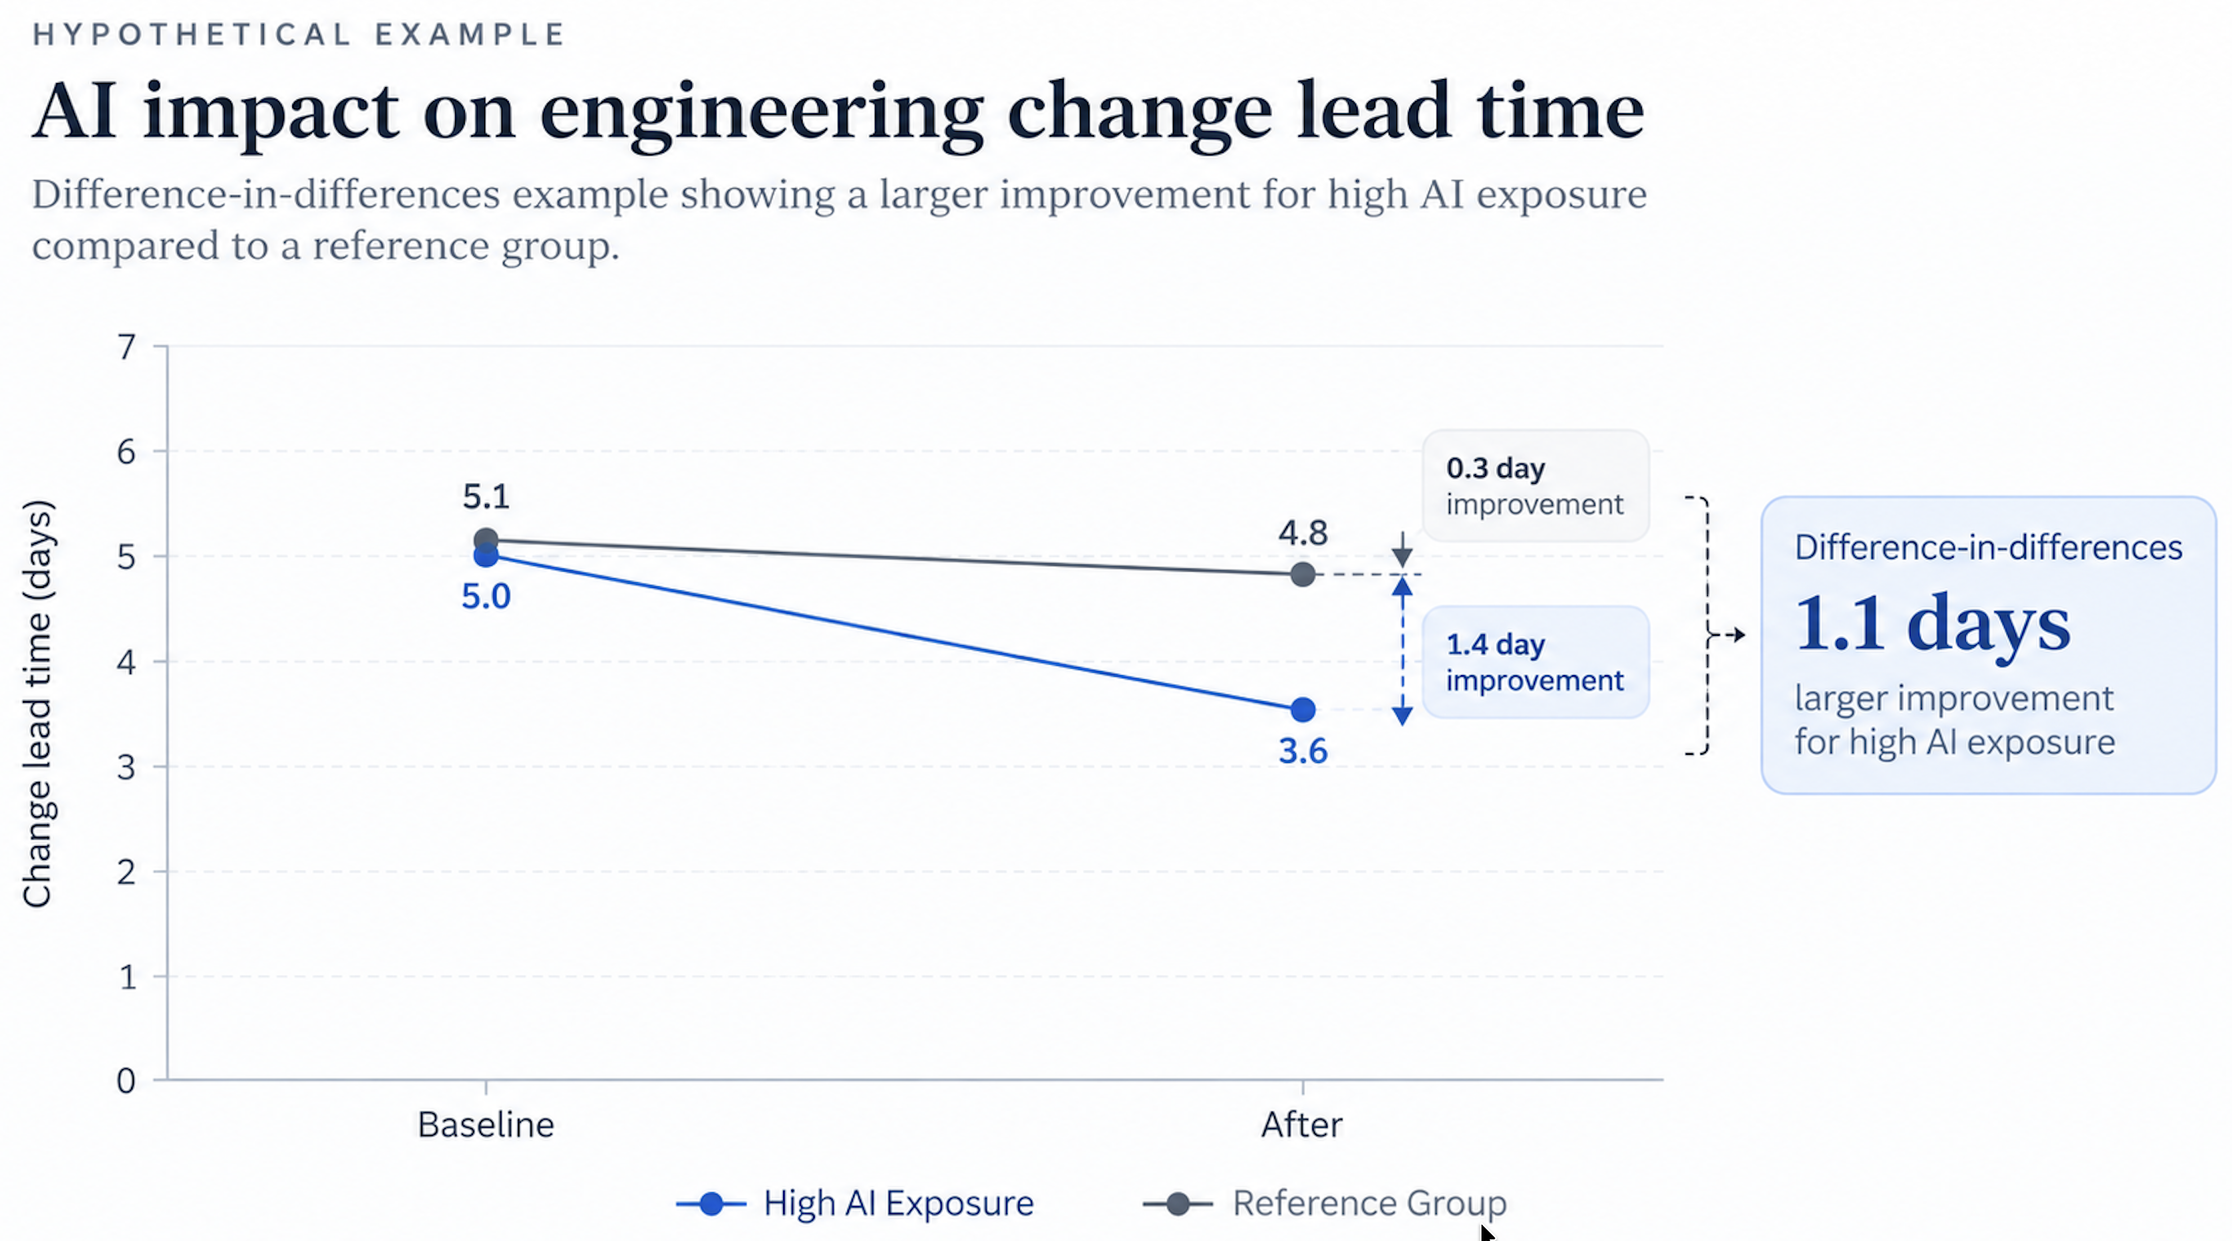
Por isso eu compararia a mudança da coorte exposta com a mudança de uma referência no mesmo período. A lógica é semelhante a uma diferença em diferenças.
Exemplo hipotético: antes do rollout, o change lead time mediano da coorte com alta exposição era 5,0 dias. Depois, caiu para 3,6 dias: melhora de 1,4 dia. No mesmo período, um grupo comparável passou de 5,1 para 4,8 dias: melhora de 0,3 dia. A diferença entre as duas variações é de aproximadamente 1,1 dia. Esse número é mais informativo do que atribuir toda a queda de 1,4 dia à IA.
Eu ainda evitaria chamar esse valor de efeito causal sem olhar para o desenho completo. Diferença em diferenças depende, entre outras coisas, de grupos comparáveis e de uma hipótese plausível de que as tendências teriam evoluído de forma semelhante na ausência da intervenção. O exemplo serve para mostrar por que uma referência temporal ajuda a separar parte do movimento que já estava acontecendo.
 Ampliar ↗
Os fatores de contexto precisam aparecer na análise#
O principal risco de uma comparação por coortes é montar grupos que já eram diferentes antes da adoção. Usuários intensivos tendem a ser early adopters, podem ter mais familiaridade com a ferramenta ou trabalhar em equipes com maior maturidade técnica. Se seus resultados forem melhores, a diferença não pode ser automaticamente atribuída à IA.
Eu registraria pelo menos senioridade, domínio, classe de tarefa, maturidade da aplicação, maturidade do pipeline, composição do time e principais dependências externas. Calendário também importa: freeze, incidentes, migrações, fechamento de trimestre e grandes releases alteram métricas de delivery.
A agregação pode esconder outro problema. Se a adoção for maior em serviços novos e os sistemas legados concentrarem aprovações e dependências, a visão consolidada pode sugerir um efeito que praticamente desaparece quando comparamos aplicações semelhantes. Por isso eu segmentaria antes de concluir.
O período de observação precisa cobrir ciclos suficientes para que um único release ou incidente não determine o resultado. Para métricas de duração, eu olharia distribuições e medianas. Para surveys de DevEx, acompanharia tamanho da amostra, taxa de resposta e evolução por coorte, sem tratar pequenas oscilações como evidência forte.
O dashboard não precisa de um score de produtividade#
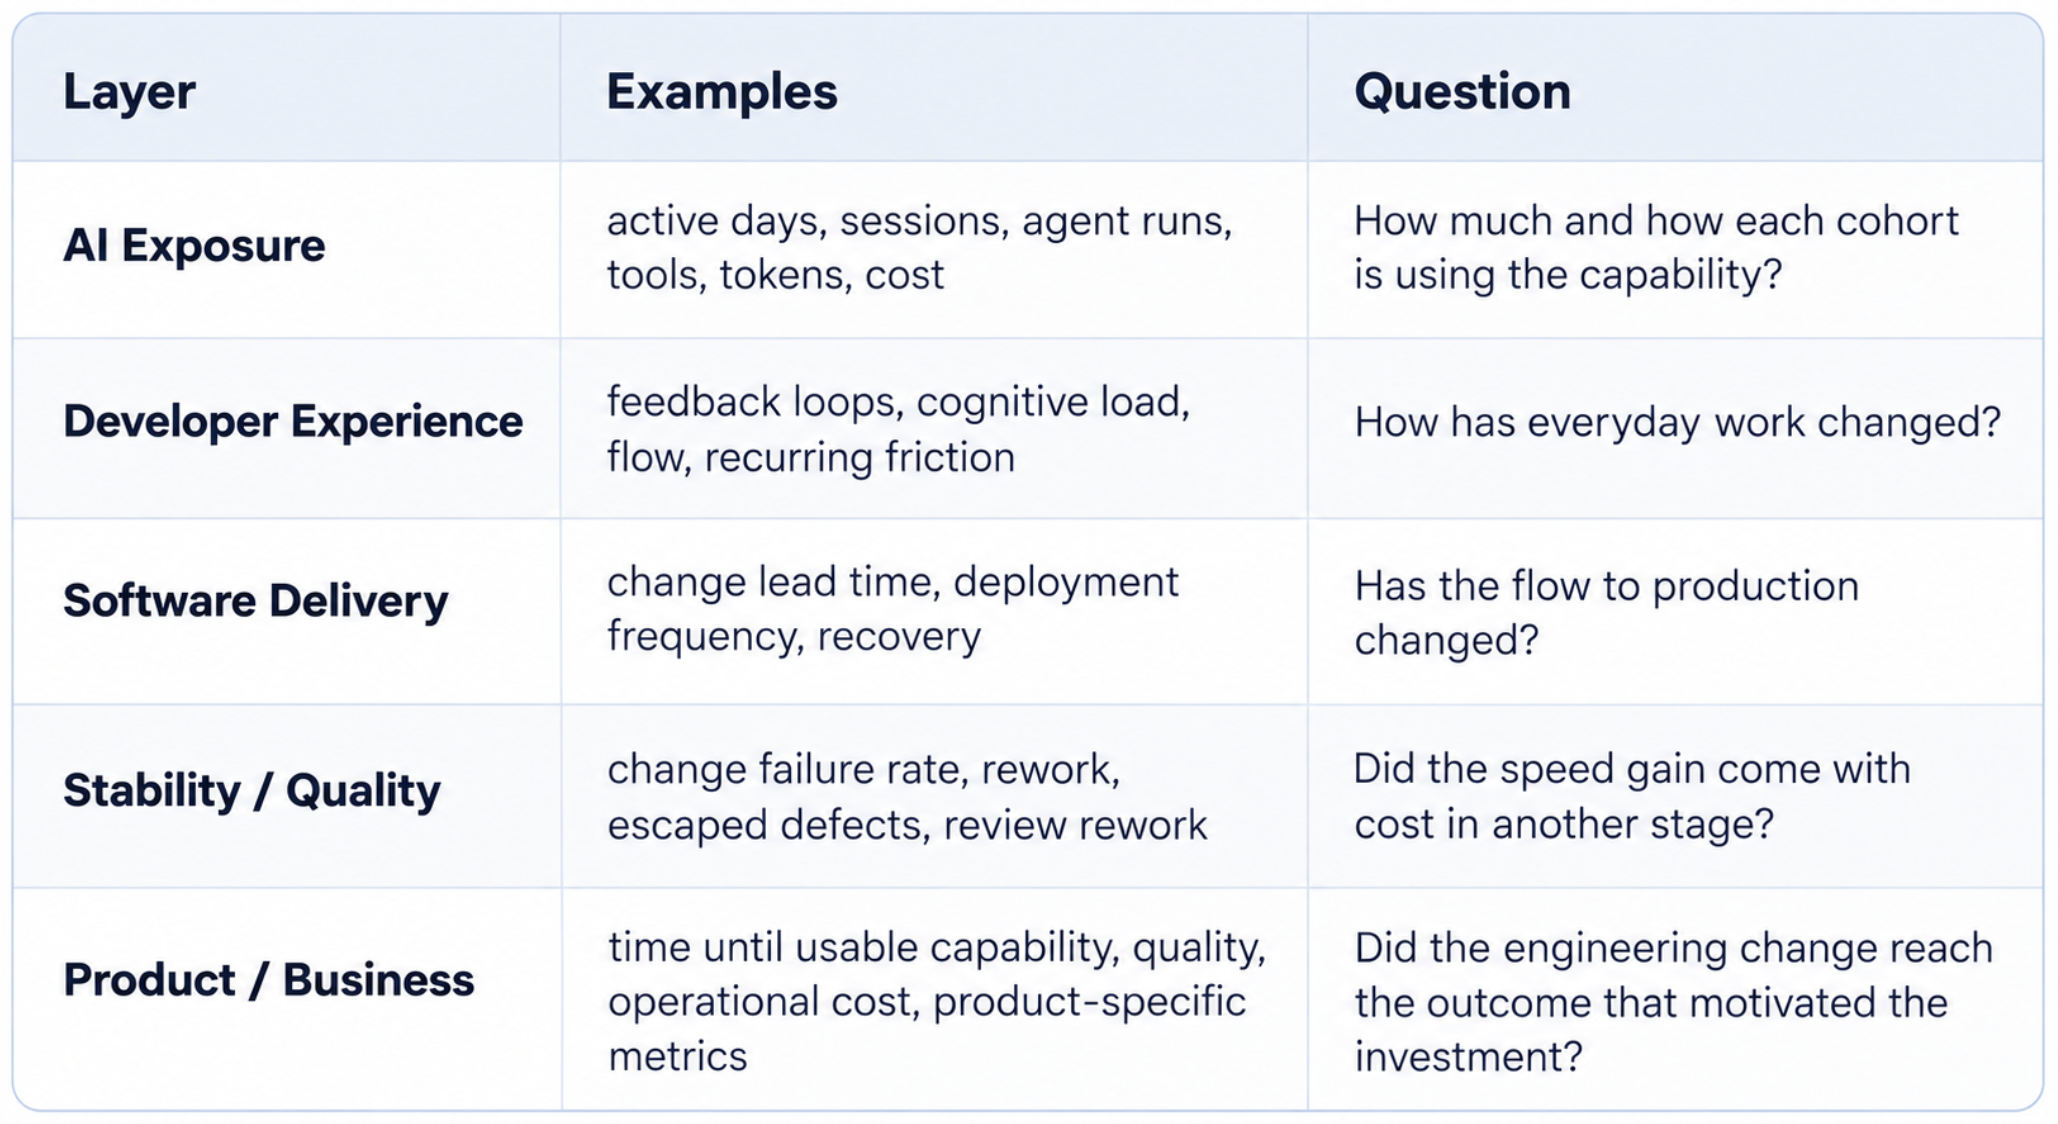
Eu manteria as métricas em camadas e permitiria navegar entre elas, sem tentar condensar tudo em um número único.
 Ampliar ↗
Essa última camada precisa ser específica. Um time de plataforma pode observar tempo de onboarding; uma aplicação bancária pode acompanhar tempo para disponibilizar uma capability, defeitos pós-release ou custo operacional; outro produto pode ter um outcome completamente diferente. Padronizar a métrica de negócio para toda a empresa provavelmente simplificaria demais a análise.
Como eu conduziria o piloto#
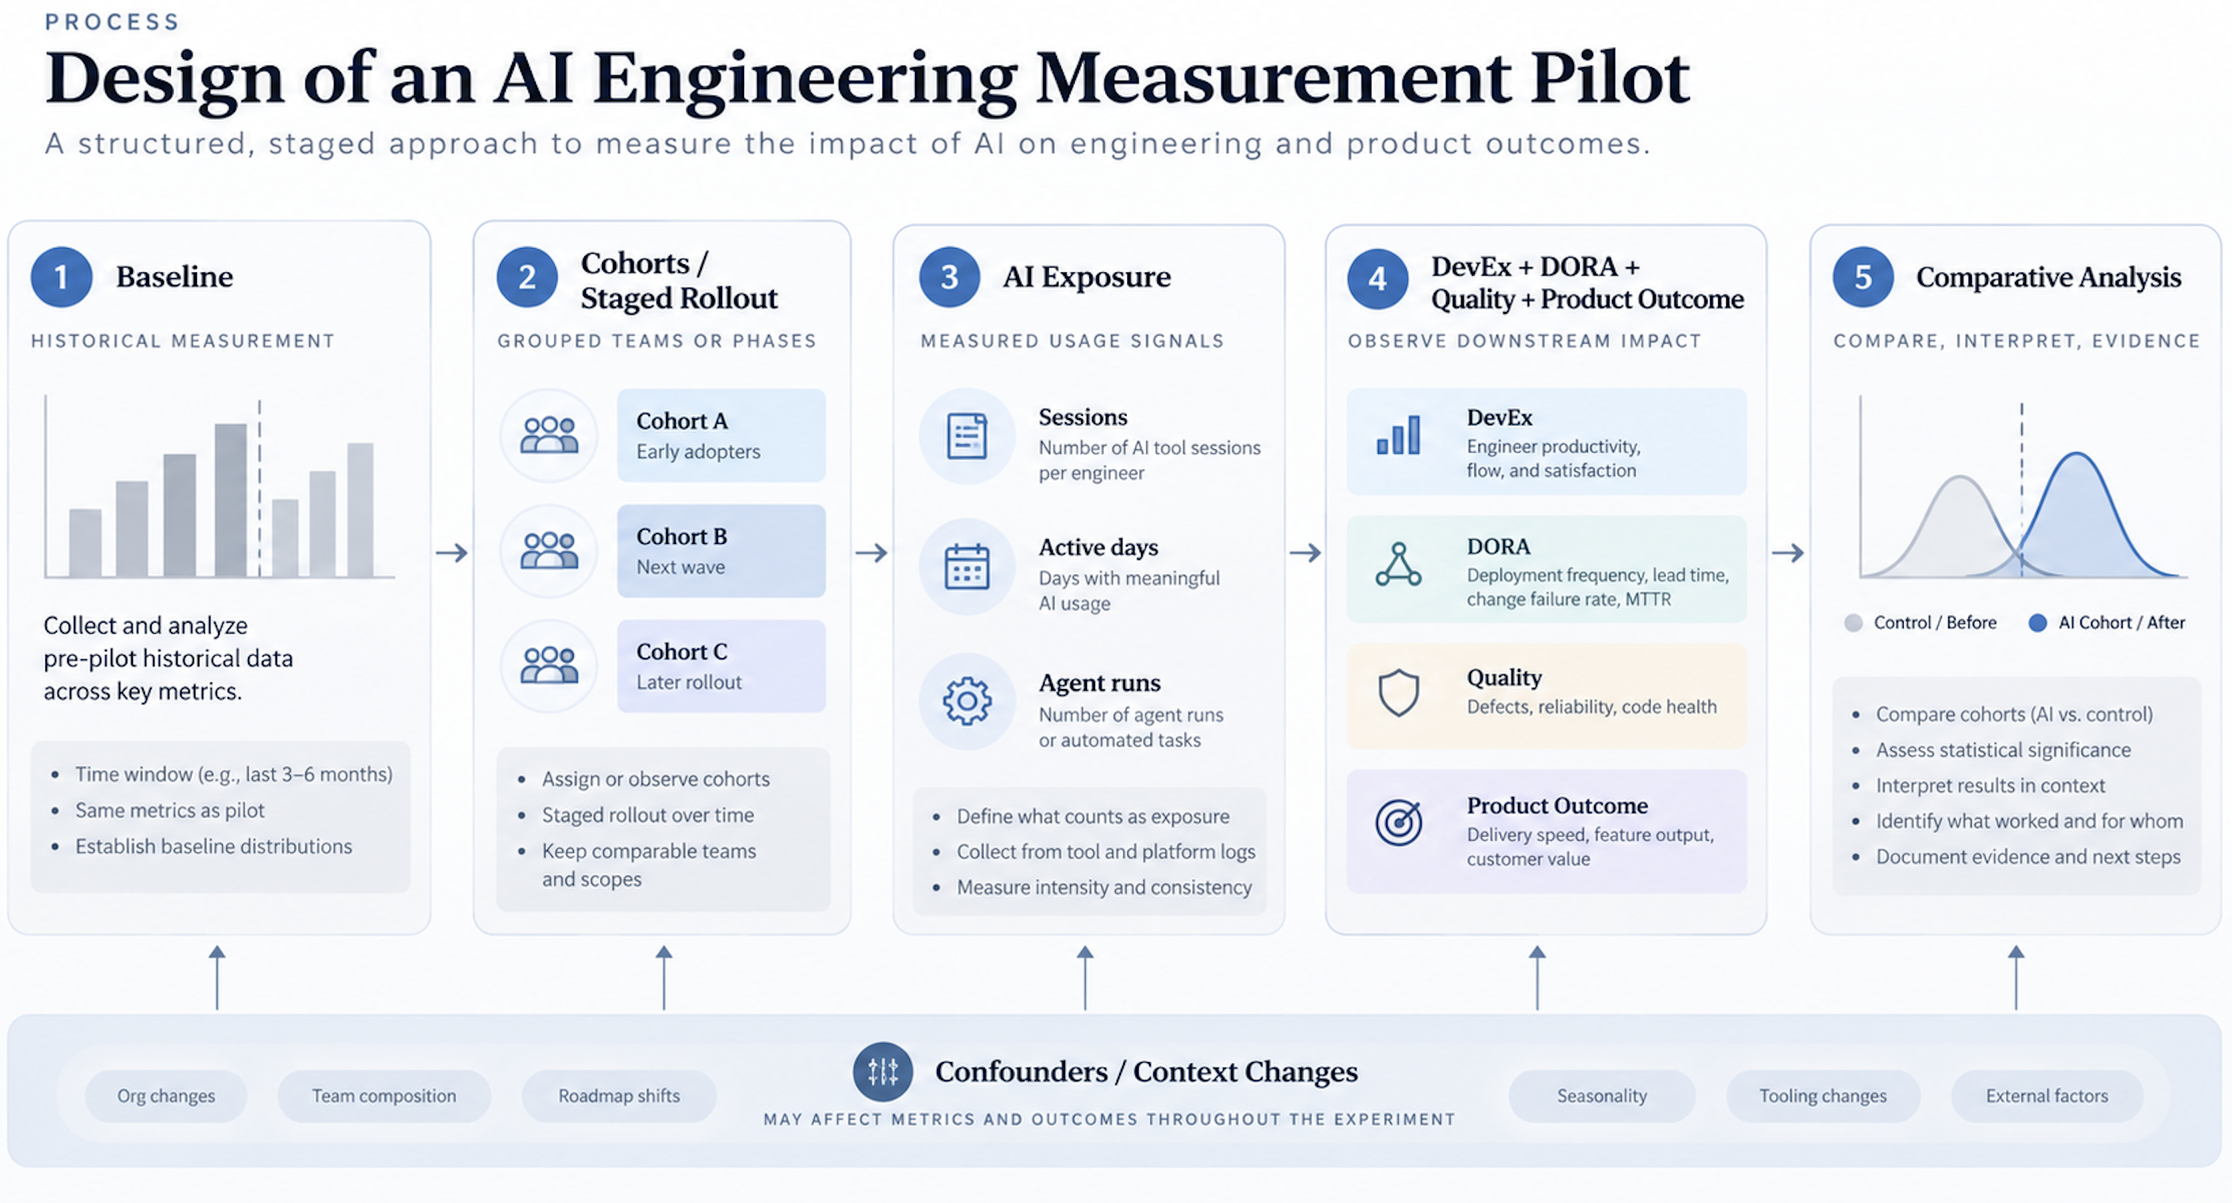
Eu começaria com poucos times ou serviços que fossem realmente comparáveis. Antes do rollout, definiria a hipótese, a unidade de análise e as métricas, evitando escolhê-las depois de ver o resultado. Também coletaria baseline suficiente para cobrir mais de um ciclo de entrega.
A condição de uso precisa ser registrada. Modelo, ferramenta, versão do harness, tools disponíveis e mudanças relevantes no ambiente devem acompanhar os dados. Se a plataforma muda no meio do piloto, aquela mudança passa a fazer parte da interpretação.
Durante o rollout, manteria telemetria de uso separada de outcomes. A análise seria feita por coorte e por período, registrando mudanças externas importantes: alteração de pipeline, reorganização do time, release freeze, migração ou incidente relevante.
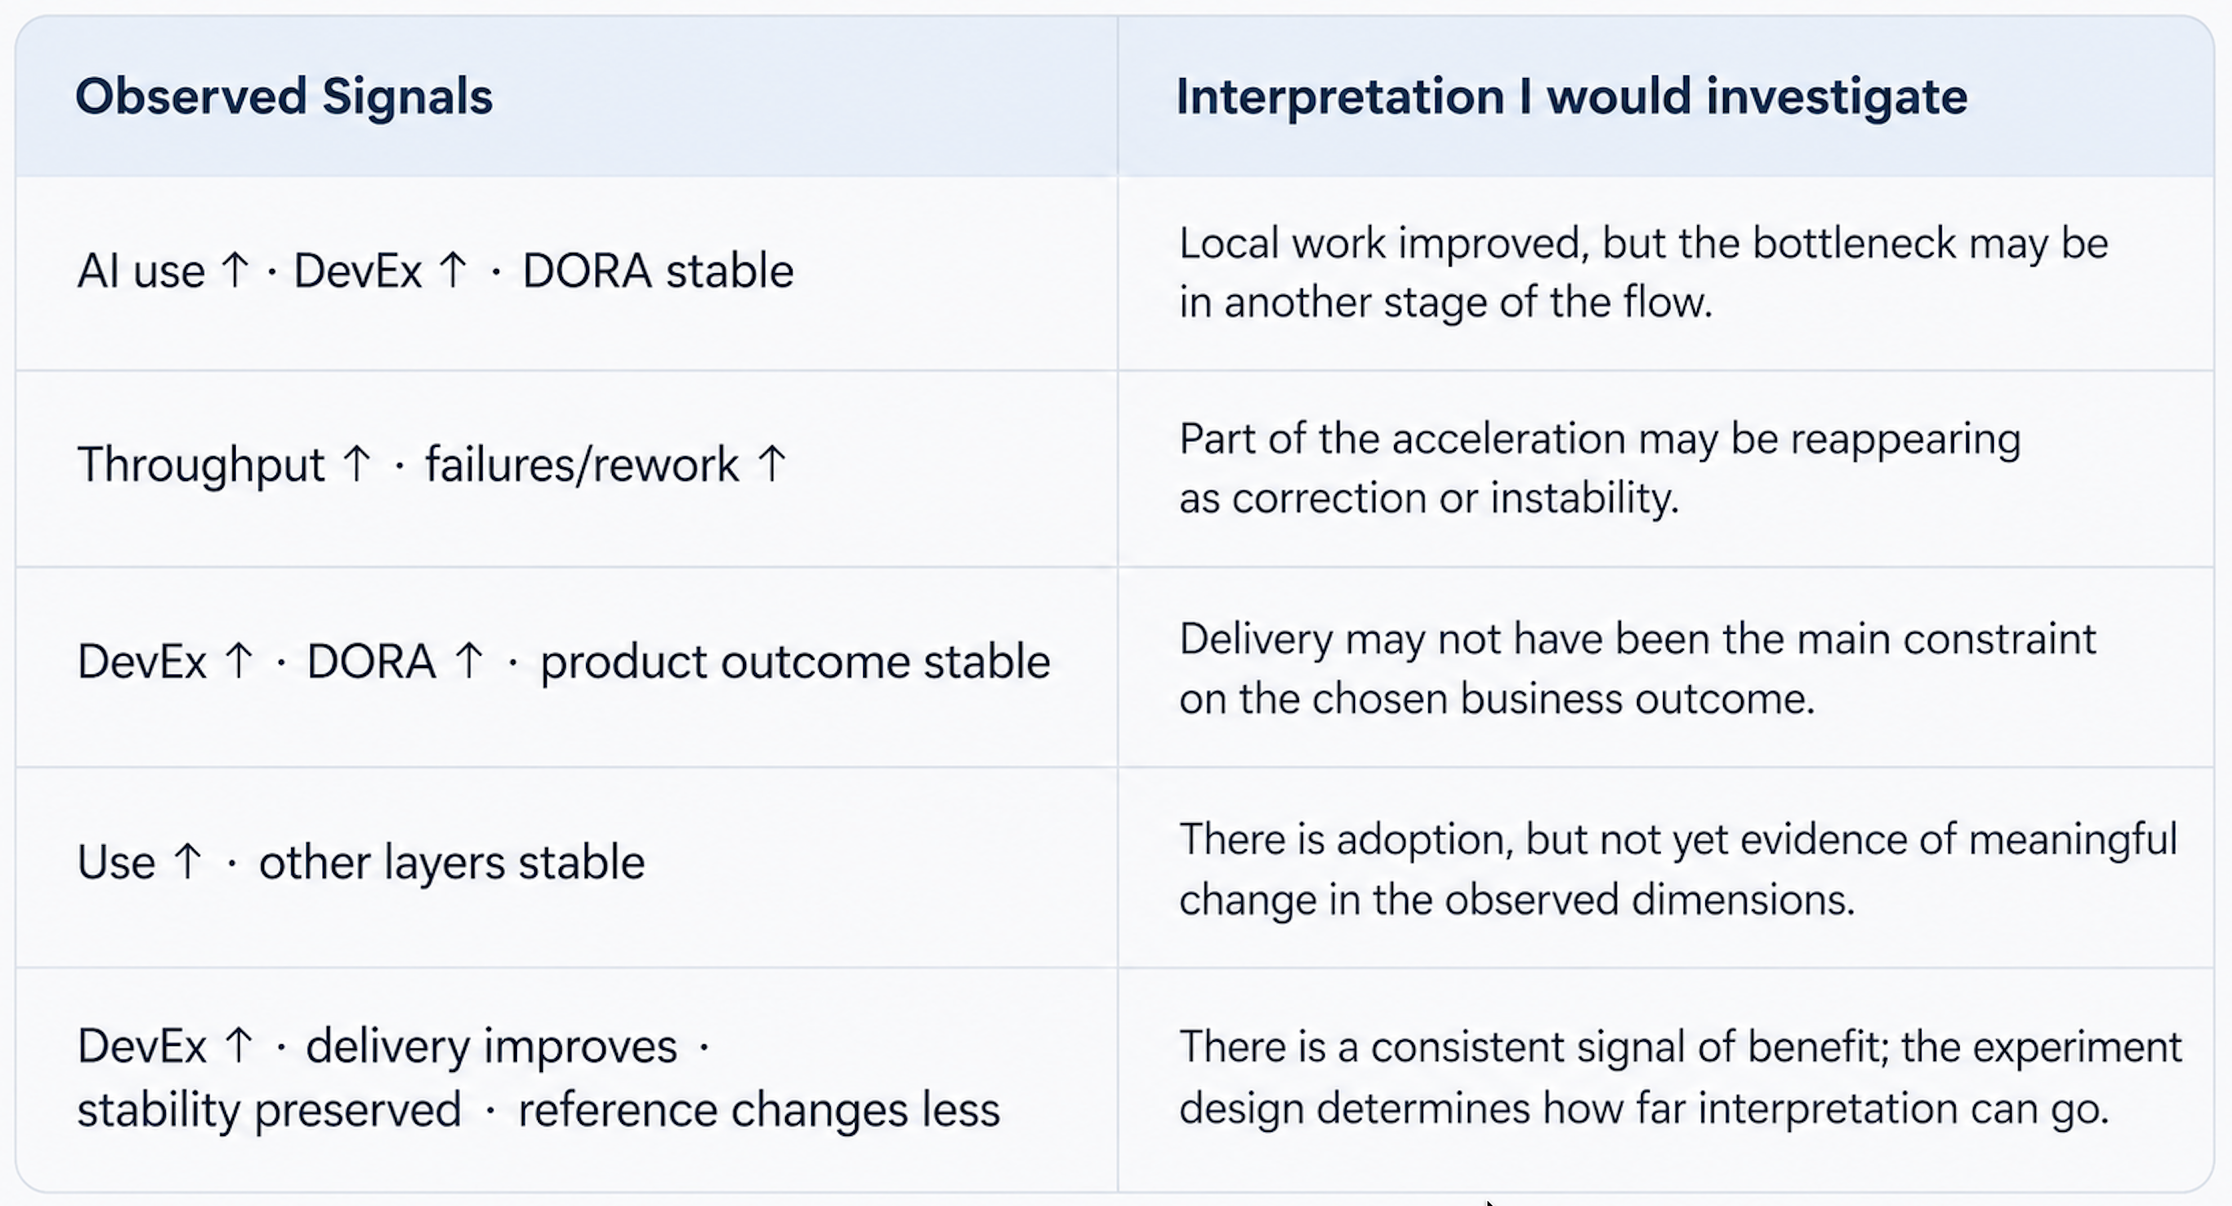
No fechamento, eu procuraria consistência entre as camadas. Melhora de Developer Experience acompanhada de menor change lead time e estabilidade semelhante é uma evidência mais interessante do que qualquer uma dessas métricas isoladamente. Se somente tokens aumentaram, sabemos que houve uso. Se apenas o tempo para produzir a primeira versão caiu, sabemos que uma etapa local acelerou. Se a mudança aparece em DevEx, delivery e qualidade, e também se diferencia de uma referência, a hipótese ganha sustentação.
 Ampliar ↗
Algumas combinações são mais informativas que uma métrica isolada#
 Ampliar ↗
Esse tipo de leitura ajuda a evitar uma conclusão comum em programas de IA: pegar a primeira métrica que se move e transformá-la em prova de ROI. Às vezes, o resultado mais útil do piloto é descobrir onde a aceleração deixou de se propagar.
Eu não usaria o experimento para ranquear pessoas#
As métricas aqui servem para avaliar uma mudança no sistema de engenharia. Transformá-las em avaliação individual mudaria o incentivo e contaminaria a própria medição. Tokens podem ser maximizados, PRs podem ser fragmentados, deploys podem virar meta e surveys deixam de ser uma boa fonte quando responder com franqueza passa a ter consequência pessoal.
Também evitaria criar um “AI productivity score” somando uso, DORA, DevEx e outcome. Um número único é fácil de apresentar e difícil de interpretar. Uma piora em estabilidade poderia desaparecer dentro do score, compensada por mais sessões ou mais deployments, justamente o trade-off que queremos enxergar.
O que uma conclusão útil se parece#
Eu não esperaria terminar o piloto com uma frase do tipo “IA aumentou a produtividade em 27%”. A conclusão que me interessaria seria mais específica: em determinados times, aplicações e classes de tarefa, maior exposição a uma capability bem definida esteve associada a mudanças mensuráveis em algumas dimensões do trabalho e do delivery, dentro das limitações daquele desenho.
Isso é menos conveniente para um slogan, mas muito mais útil para decidir investimento. Permite entender onde ampliar o rollout, onde a plataforma precisa mudar, quais tipos de trabalho respondem melhor e quais restrições continuam limitando o sistema.
É também onde as duas partes desta série se encontram. Telemetria de IA descreve uso, custo e exposição. Developer Experience mostra como o trabalho mudou. DORA ajuda a observar se essa mudança chegou ao fluxo de entrega. Qualidade e estabilidade mostram se houve deslocamento de custo. Coortes e baseline colocam a mudança em perspectiva. O resultado de produto fecha a análise quando existe uma relação clara com aquilo que a organização pretendia melhorar.