Agent = Model + Harness
Como guides, sensors, data context layer, orchestration e feedback layer transformam o que esta série construiu em um programa auditável e por que o inner harness do fornecedor não cobre, sozinho, as obrigações regulatórias brasileiras.
O harness que já existia sem nome#
Nos cinco artigos anteriores, construímos, peça por peça, a infraestrutura de um programa de IA generativa em uma instituição financeira regulada: política, arcabouço normativo, frameworks, arquitetura e processo de engenharia. Faltava apenas um nome para o sistema formado por todos esses componentes: o harness.
A fórmula que organiza essa ideia é direta: Agent = Model + Harness
Mitchell Hashimoto ajudou a popularizar o termo harness engineering em fevereiro de 2026 ao descrever uma disciplina simples: cada erro recorrente do agente deve resultar em uma melhoria no ambiente, nas instruções ou nas ferramentas que o cercam. Dias depois, a OpenAI apresentou uma experiência de desenvolvimento agent-first resumida pela frase "Humans steer. Agents execute." A equação Agent = Model + Harness, posteriormente sistematizada pela LangChain e utilizada por Birgitta Böckeler em sua taxonomia na Thoughtworks, ajuda a organizar essa mudança de perspectiva.
À medida que modelos de fronteira se aproximam em diversas capacidades, uma parcela crescente do diferencial deixa de estar na escolha isolada do modelo e migra para o sistema construído ao redor dele.
As três fases de maturidade da engenharia de IA#
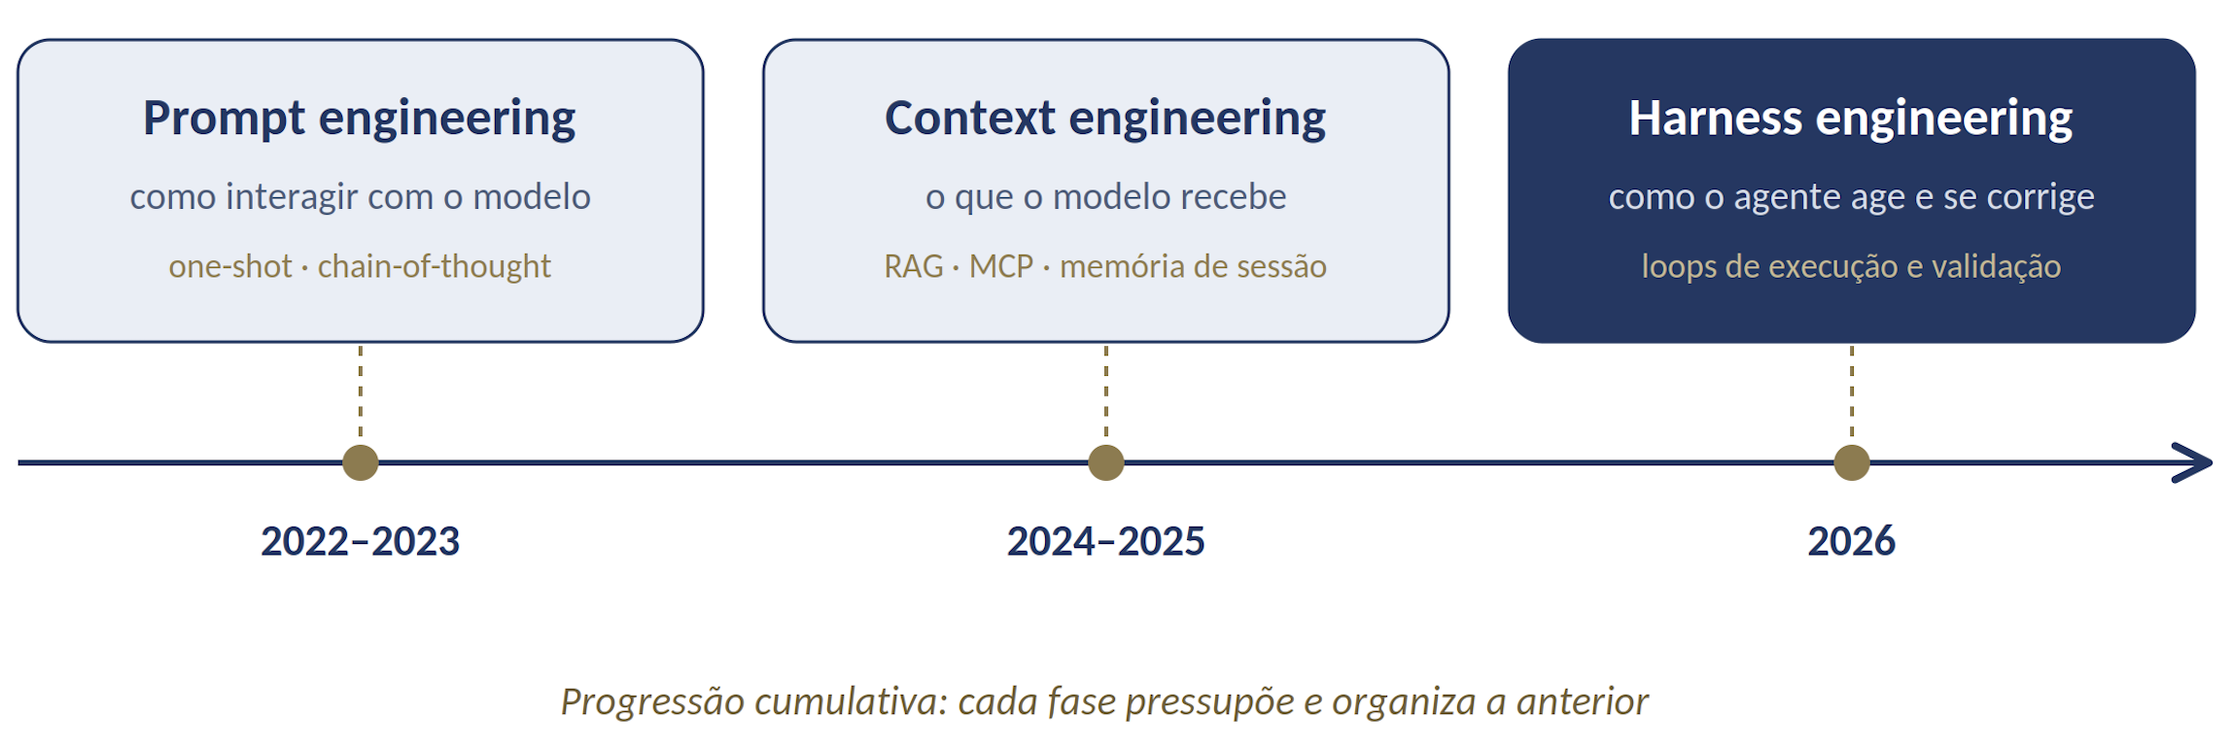
Harness engineering não surgiu no vácuo. Uma forma útil de interpretar essa evolução é dividi-la em três camadas cumulativas de maturidade, cada uma construída sobre a anterior:
 Ampliar ↗
A progressão é cumulativa. Harness engineering pressupõe prompts bem escritos e contexto bem administrado e organiza essas práticas em uma estrutura operacional.
As cinco camadas do harness#
Böckeler, da Thoughtworks, organiza o harness em dois tipos de componente: guides e sensors. Guides são controles de feedforward: instruem o agente sobre o que pode fazer antes da ação e sensors são controles de feedback: observam e validam o comportamento durante ou depois da execução.
Um exemplo torna a distinção concreta. O CLAUDE.md é um guide porque orienta o agente antes de agir. Um hook que analisa o resultado depois de uma alteração funciona como sensor. Quando esse mesmo hook bloqueia um comando antes da execução, atua como guard, sendo um ponto de enforcement.
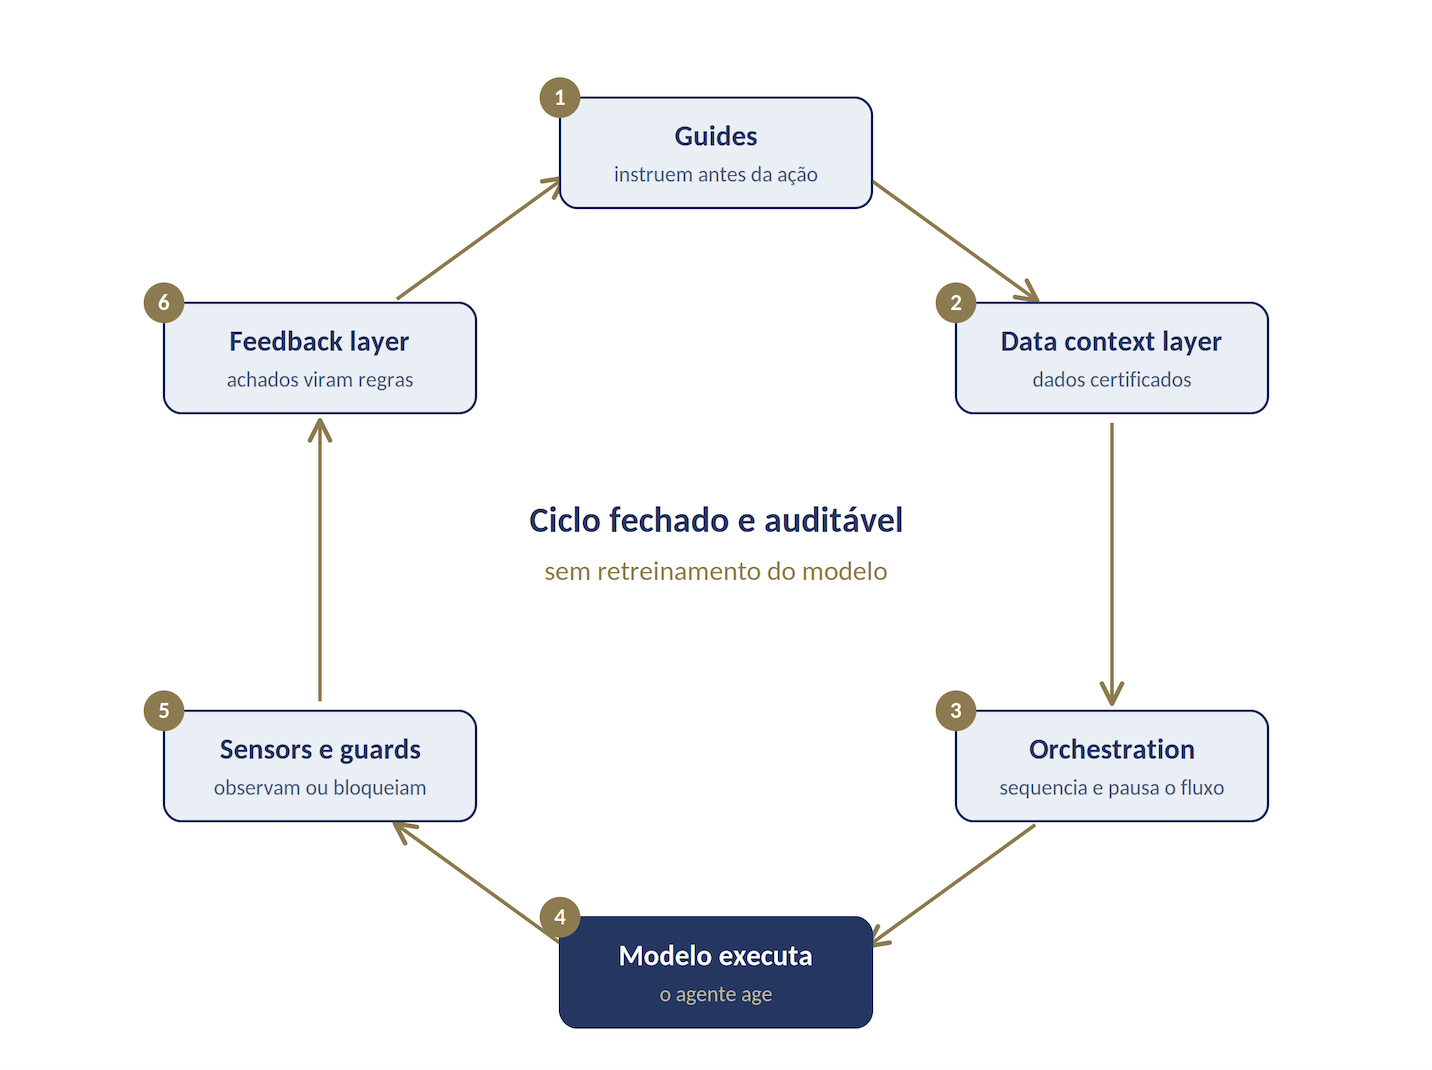
A partir dessa base, o harness pode ser organizado em cinco camadas:
1. Guides#
Documentos e configurações que restringem o comportamento do agente antes da ação: CLAUDE.md, managed-settings.json e system prompts corporativos. Em uma instituição financeira, podem proibir o uso de PII, restringir destinos externos e definir padrões obrigatórios de output.
2. Sensors e guards#
Hooks, loops de validação, evals, detectores de drift, gates de qualidade e integrações com SIEM, que observam, validam ou bloqueiam ações durante e depois da execução. Exemplos: prompt-linter, secret-scan, bash-guard, SonarQube gate e casos de uso específicos de IA no SIEM. A classificação depende da função e do momento em que o componente atua, não apenas da ferramenta utilizada.
3. Data context layer#
Dados certificados e fontes autorizadas que o harness disponibiliza ao agente em tempo de execução: camada que garante que o modelo raciocine sobre informações confiáveis e dentro do escopo permitido. Exemplos: um MCP interno do SonarQube em modo somente leitura e uma base sanitizada do Confluence, sem acesso direto a dados de clientes.
4. Orchestration#
Sequenciamento de tarefas, gates de revisão e condições de parada: camada que define em que ordem o agente trabalha, quando pode avançar e quando deve interromper a execução para revisão humana. Em um fluxo regulado: spec → geração → hooks → gateway → CI/CD → revisão humana → merge.
5. Feedback layer#
Captura das correções humanas e transformação desses achados em regras ativas: o harness aprende com os erros sem que o modelo precise ser retreinado. Achados de revisão viram novas regras no CLAUDE.md; ocorrências recorrentes passam a ser detectadas pelo prompt-linter.
Essas cinco camadas operam em dois níveis: o que o fornecedor entrega por padrão e o que a instituição constrói sobre essa base. É nessa diferença que a regulação brasileira entra na arquitetura.
Inner harness e outer harness: onde a regulação vira controle técnico#
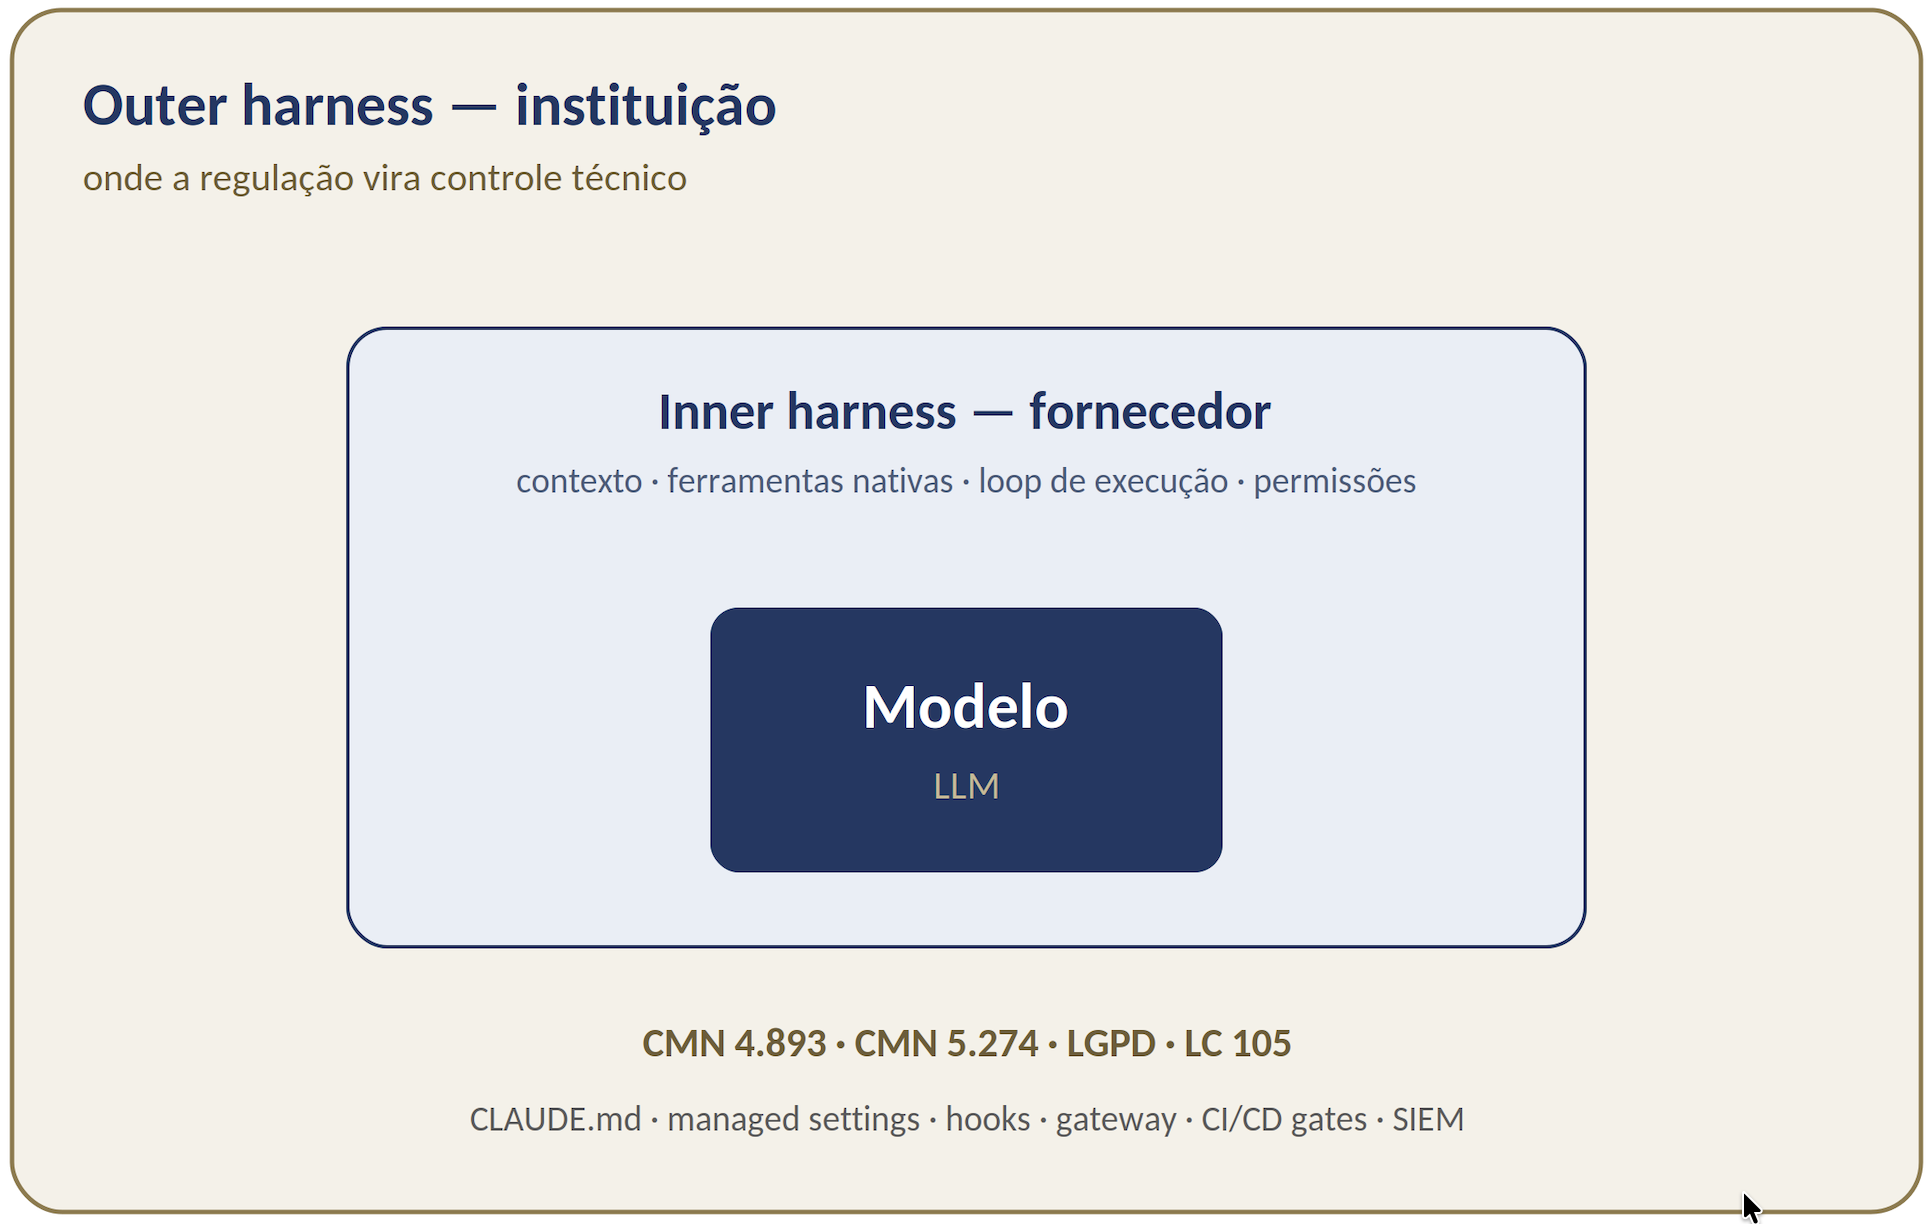
Böckeler chama de user harness a camada que o time constrói sobre o que já vem embutido no agente pelo fornecedor. Neste artigo, uso os termos inner harness e outer harness para a mesma distinção.
O inner harness é o que a Anthropic entrega com o Claude Code: janela de contexto, ferramentas nativas, loop de execução e permissões básicas. Como foi desenvolvido para o mercado global, não incorpora, por padrão, os controles específicos da Resolução CMN nº 4.893, da LGPD, da LC 105 ou da Resolução CMN nº 5.274. O fornecedor não tem como antecipar quais obrigações serão aplicáveis a cada instituição ou quais evidências um regulador local exigirá.
O outer harness é a camada construída pela própria instituição: CLAUDE.md corporativo, managed settings, hooks, gateway on-premises, allowlist de MCPs, gates de CI/CD, revisão humana e integração com SIEM. É nessa camada que requisitos regulatórios, políticas internas e decisões de risco se transformam em controles técnicos demonstráveis.
 Ampliar ↗
A consequência é assimétrica: sem o inner harness, não existe agente; sem o outer harness, existe um agente em produção, mas não a capacidade de demonstrar os controles que uma inspeção regulatória pode exigir.
 Ampliar ↗
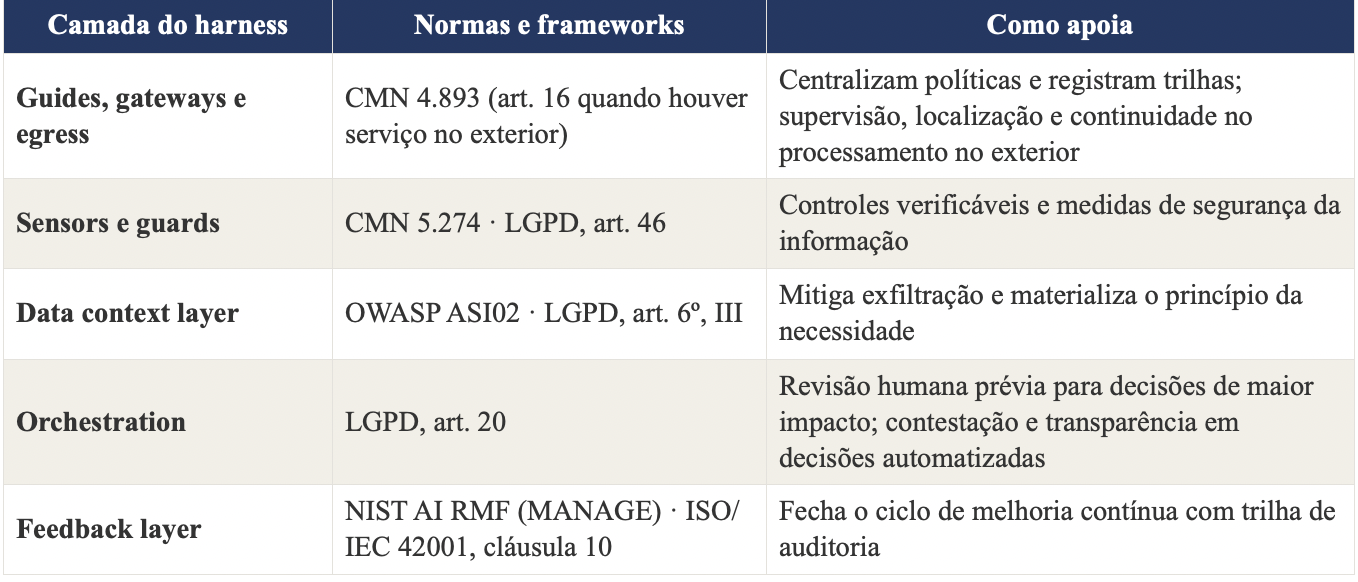
Forma-se um ciclo fechado, auditável e independente de retreinamento. O mapeamento entre normas e camadas é orientativo:
 Ampliar ↗
Os failure modes que o harness resolve#
Modelos utilizados de forma isolada podem alucinar. Agentes autônomos acrescentam uma categoria diferente de risco: falhas que emergem porque o modelo executa sequências de ações sem supervisão humana em cada etapa. Algumas delas são recorrentes o suficiente para exigir controles específicos.
Victory declaration bias ou premature completion: o agente considera a tarefa concluída sem verificar se o resultado é válido. O controle é um gate obrigatório de CI antes da abertura ou aprovação de qualquer PR: se os testes não passarem, o pipeline não avança. Esse comportamento pode contribuir para o ASI09 Human-Agent Trust Exploitation quando induz aprovação humana sem validação suficiente.
Context anxiety: ao acreditar que está próximo do limite da janela de contexto, o modelo toma atalhos ou abandona tarefas incompletas, mesmo quando ainda há espaço disponível. A Cognition AI documentou esse comportamento em produção com o Claude Sonnet 4.5. O harness responde dividindo tarefas em etapas menores, criando checkpoints explícitos e orientando o agente a pausar quando houver incerteza.
One-shotting overreach: o agente tenta concluir todo o trabalho em uma única execução, sem revisões intermediárias. O controle combina limite de escopo por sessão nos guides com sub-tarefas e gates de revisão definidos pela orchestration.
Exfiltração por uso de ferramentas - ASI02: o agente utiliza uma ferramenta para enviar dados a um destino não autorizado. A mitigação combina allowlist de destinos, hooks, path-guard, controles de egress e MCPs somente leitura, sem acesso a dados de clientes.
Prompt injection indireta - ASI01 Agent Goal Hijack: conteúdo malicioso presente em arquivos, repositórios ou fontes externas tenta redefinir os objetivos do agente. O controle está em tratar conteúdo externo como dado, nunca como instrução confiável, inspecionando-o antes de disponibilizá-lo ao modelo.
Alucinação normativa: o agente cita uma norma com número, artigo, conteúdo ou vigência incorretos. O controle é um gate de orchestration que exige revisão jurídica ou regulatória antes da publicação, do merge ou de qualquer decisão baseada naquela referência.
O caso da CVE-2026-21852, apresentado na Parte 3 da série, é um exemplo concreto de risco associado a configurações carregadas de um repositório. Um projeto malicioso podia redirecionar o ANTHROPIC_BASE_URL no Claude Code antes da confirmação de confiança do desenvolvedor. Na arquitetura proposta nesta série, o vetor seria mitigado por configurações corporativas imutáveis distribuídas via MDM, atualização obrigatória para uma versão corrigida (igual ou superior à 2.0.65) e controles de egress capazes de impedir redirecionamentos para endpoints não autorizados.
O feedback layer fecha o ciclo#
O harness trata erros estruturalmente: não por retreinamento, mas pela criação de restrições que impedem a repetição do mesmo comportamento. Hashimoto descreve uma mecânica semelhante, onde comportamentos inadequados observados durante o uso são transformados em novas regras, instruções ou melhorias nas ferramentas que cercam o agente.
Essa dinâmica se aproxima do processo de melhoria contínua da cláusula 10 da ISO/IEC 42001, na qual uma não conformidade deve gerar correção, análise da causa e ação para evitar recorrência:
ocorrência em produção → revisão humana → análise de causa raiz → nova regra → atualização do controle → bloqueio da recorrência → novo ciclo de avaliação
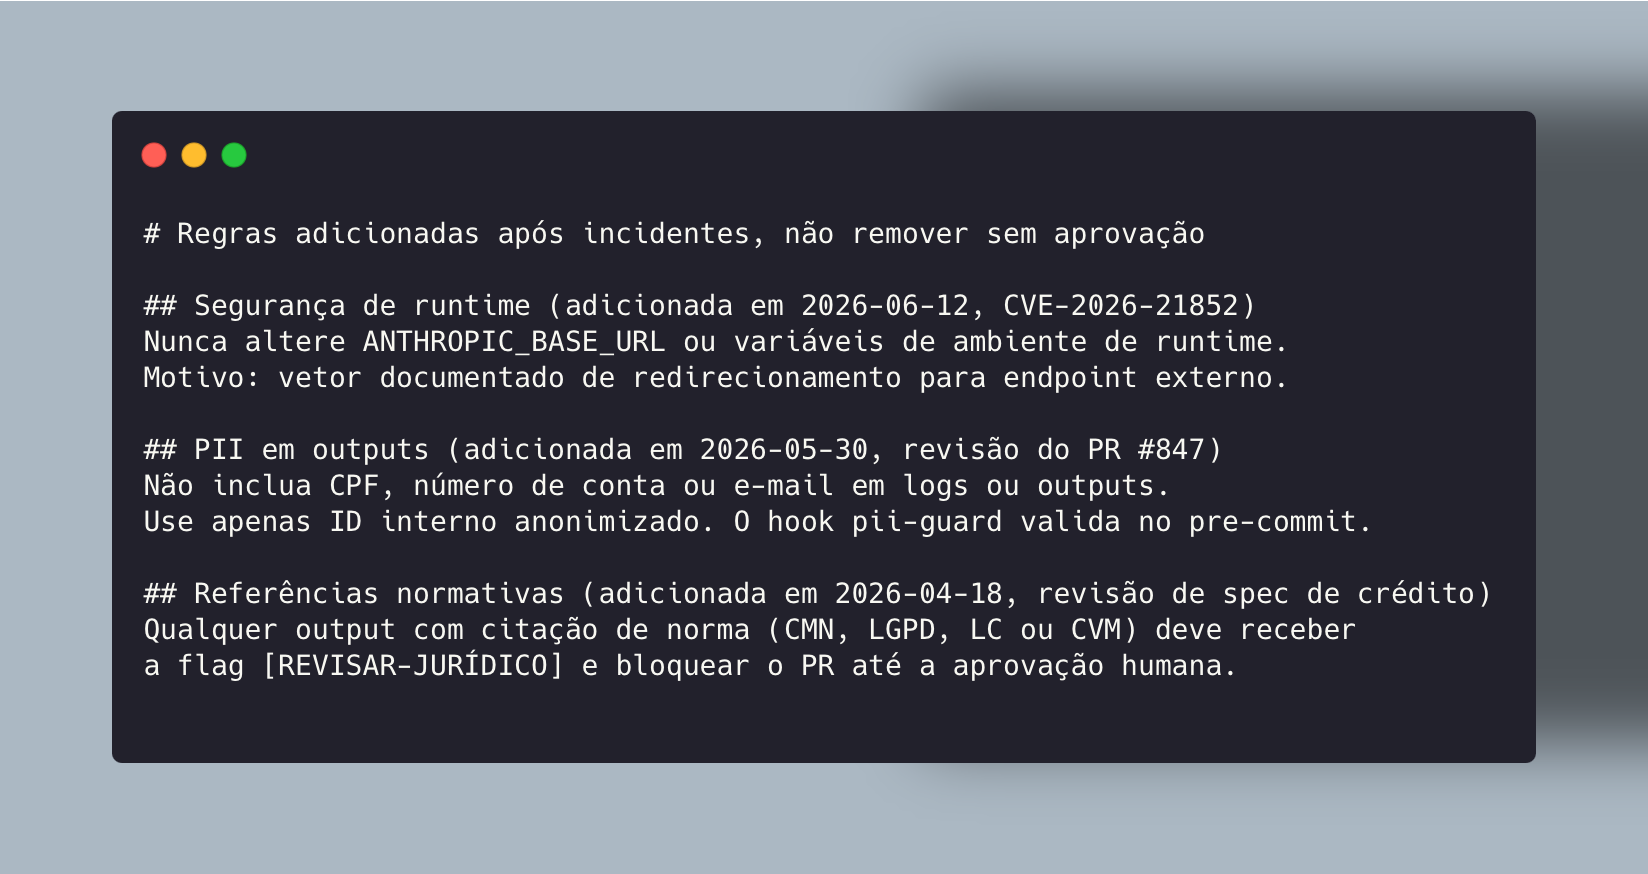
As regras acumuladas no CLAUDE.md mantêm data, origem e justificativa. O exemplo abaixo é ilustrativo, incidentes, datas e números de PR são fictícios:
 Ampliar ↗
Cada entrada representa um incidente tratado. Data, origem e regra resultante formam a trilha de auditoria do feedback layer.
O modelo continua o mesmo antes e depois da correção; o que muda é o harness, uma restrição de comportamento na camada entre o modelo e a produção, mais rápida de aplicar do que qualquer ajuste no modelo, além de auditável e reversível.
Há, porém, uma ressalva importante: o harness também envelhece. Regras criadas para uma versão do modelo podem se tornar desnecessárias ou até contraproducentes na seguinte. O próprio context anxiety ilustra o risco, mitigações escritas para contornar o comportamento de uma versão viram peso morto quando a versão seguinte não o apresenta da mesma forma. Por isso, o harness deve ser versionado e reavaliado a cada troca de modelo. Controle sem eval contínua se transforma em dívida operacional.
O outer harness que a série já construiu#
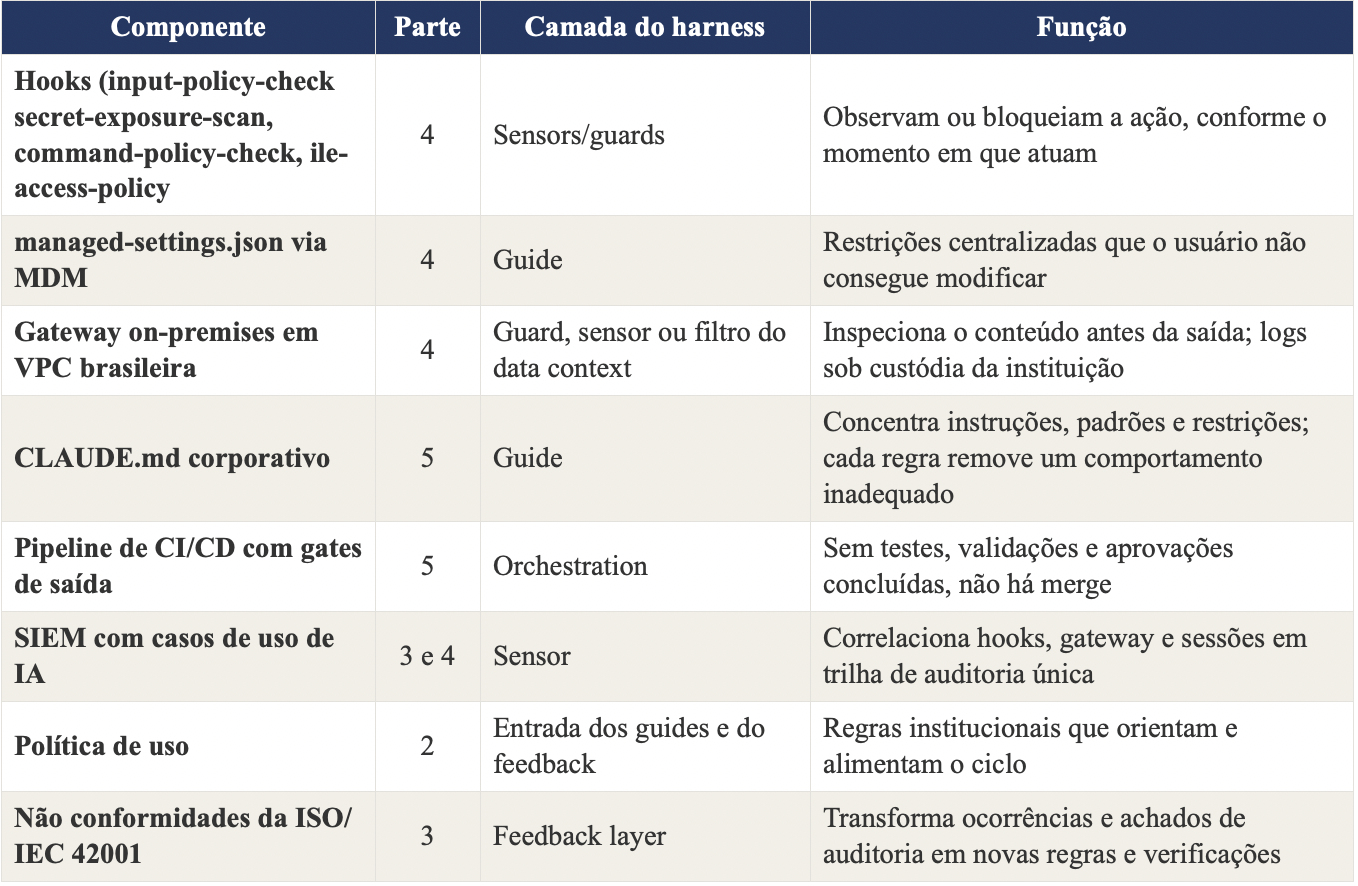
Ao longo dos cinco artigos anteriores, descrevi os componentes do outer harness sem utilizar esse nome. Este artigo organiza cada peça dentro de uma arquitetura comum:
 Ampliar ↗
O outer harness, portanto, já estava construído. Faltava o conceito que organizasse essas peças em uma arquitetura coerente. Com o harness nomeado, o programa de IA generativa deixa de ser apenas funcional e passa a ser demonstrável: torna-se possível mostrar a um auditor qual camada responde a cada risco, qual artefato comprova que o controle está ativo e como o sistema aprende quando esse controle falha.
Os seis princípios que atravessaram a série#
O programa apresentado ao longo desta série pode ser resumido em seis princípios operacionais:
1. Regulatório primeiro#
Nenhum ambiente de produção deve operar com dados reais antes da aprovação da política, da análise de impacto, dos instrumentos contratuais aplicáveis e da avaliação dos requisitos regulatórios relevantes. O passivo criado pela adoção na sequência errada é difícil de reconstruir durante uma auditoria.
2. Residência condiciona a arquitetura#
O enquadramento depende de onde o dado é processado, e não apenas de onde o fornecedor mantém sua sede. Um gateway em ambiente brasileiro centraliza inspeção, minimização e rastreabilidade antes da saída, apoiando o atendimento à LC 105 e reduzindo a exposição associada à LGPD. Ele não elimina, por si só, as exigências do art. 33 quando dados pessoais continuam sendo processados no exterior.
3. Produto não é fornecedor#
O regime de dados é definido pela superfície utilizada. O mesmo fornecedor pode oferecer produtos adequados a workloads regulados e outros que não devem receber dados sensíveis. Tratar todas essas superfícies como equivalentes é um risco de arquitetura e governança.
4. Fail-closed como invariante#
Um controle que pode ser ignorado quando falha não é um controle efetivo. Sem gateway, não há acesso. Sem revisão humana, não há merge. Sem evidência, não há aprovação.
5. Spec primeiro, código depois#
A IA generativa amplifica o que recebe como contexto. Sem estrutura, o modelo preenche lacunas e inventa regras de negócio. Com uma spec bem definida, torna-se um amplificador da engenharia.
6. Agent = Model + Harness#
Guides, sensors, data context, orchestration e feedback são o que transforma um modelo de linguagem em um agente confiável, controlável e auditável em um ambiente regulado.
O modelo pode ser o mesmo. O controle demonstrável não é.
Este é o artigo 6 de 6 da série "IA Generativa em Instituição Financeira Regulada". Os artigos anteriores abordaram política de uso, arcabouço normativo, frameworks de risco, arquitetura de residência de dados e spec-driven development com IA.
Links:
Parte 1 - O mapa do que vem pela frente: https://bit.ly/4oXLCsi
Parte 2 - O labirinto regulatório brasileiro: o que BACEN, CVM, ANBIMA e LGPD exigem antes do primeiro prompt: https://bit.ly/4wfQRG1
Parte 3 - Frameworks na prática: NIST AI RMF, ISO 42001, OWASP e GAIG traduzidos em controle e evidência: https://bit.ly/4vzlXZf
Parte 4 - Arquitetura: onde a política vira controle técnico e por que a residência de dados define o desenho: https://bit.ly/44EOSzh
Parte 5 - Spec-driven development com IA: cinco anti-padrões e o fluxo que torna a resposta rastreável: https://bit.ly/4vchwmq