Parte 5 de 6 - Série: IA Generativa em Instituição Financeira Regulada
A parte anterior resolveu por onde o dado deve passar: gateway sob controle da instituição, infraestrutura localizada no Brasil, fail-closed e uma trilha de auditoria com retenção definida por categoria de evidência.
A arquitetura, porém, não determina como o código deve ser gerado. É aí que muitos programas de IA aplicada ao desenvolvimento deixam uma lacuna: o modelo produz código plausível, mas plausibilidade não é correção. Quando o contexto é incompleto, o modelo preenche lacunas com suposições, as quais podem chegar ao repositório sem vínculo com uma decisão de negócio documentada.
A premissa deste artigo é que em ambiente regulado a especificação não serve apenas para documentar. Ela pode funcionar como controle técnico e como parte da evidência do processo.
Código gerado por IA não tem isenção de responsabilidade regulatória#
O uso de IA não transfere a responsabilidade pelo software ao fornecedor do modelo. A instituição continua responsável pelo sistema colocado em produção, enquanto desenvolvedores, revisores e demais profissionais respondem pelos papéis que exercem no processo de desenvolvimento, validação e aprovação. A Resolução CMN 4.893/2021, alterada pela Resolução CMN 5.274/2025, reforça a necessidade de procedimentos e controles para o desenvolvimento seguro de sistemas de informação e para a adoção de novas tecnologias. Quando ferramentas externas passam a integrar esse processo, entram também os controles relacionados à contratação, à gestão de terceiros, ao acesso, à rastreabilidade e à proteção de dados. O enquadramento exato depende da arquitetura adotada e da modalidade de prestação do serviço. Na prática, cabe à instituição definir como a ferramenta pode ser utilizada, quais instruções e restrições devem orientá-la e de que forma seus resultados serão revisados antes de chegar à produção.
O ponto não é impedir o uso de IA no ciclo de desenvolvimento, mas evitar que ela seja usada sem processo, critérios e evidências. O mesmo princípio que justifica uma etapa explícita de crítica e validação em assistentes de investimentos também vale para a geração de código: “a IA gerou sozinha” não transfere a responsabilidade nem explica quais controles foram aplicados. Sem instruções documentadas, critérios de aceite e registro de revisão do output, fica difícil demonstrar para Compliance, auditoria ou reguladores que a ferramenta operou dentro dos parâmetros definidos pela instituição. É aí que a spec faz a diferença: ela transforma intenção em regra verificável e geração em processo rastreável.
Os cinco anti-padrões que o auditor vai encontrar no seu processo#
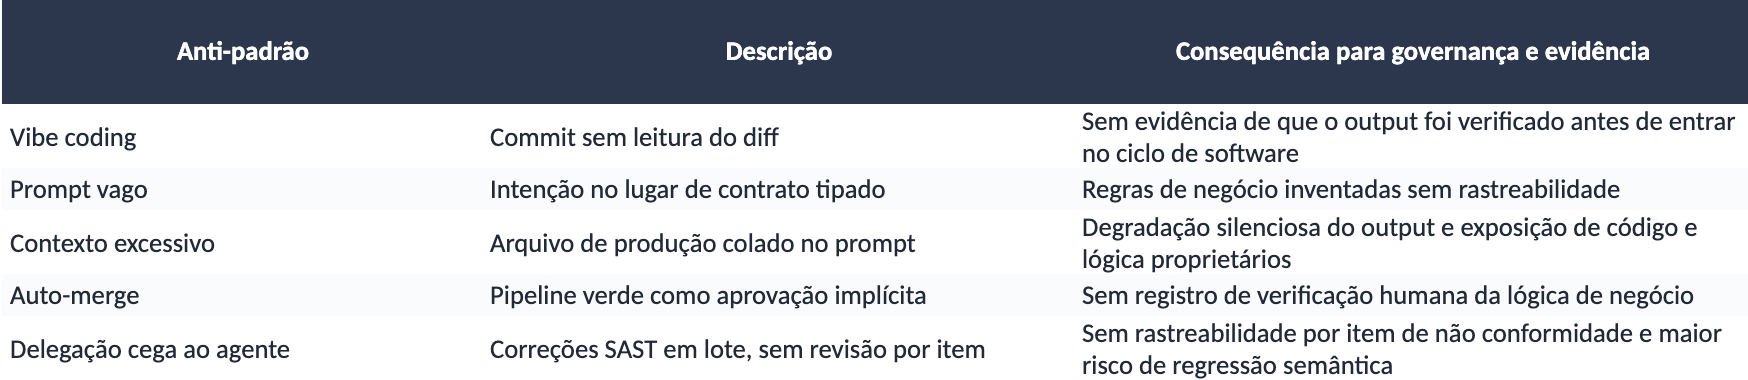
1. Vibe coding: aceitar o primeiro output e fazer commit#
Andrej Karpathy deu nome à prática em fevereiro de 2025: aceitar mudanças sem ler os diffs, devolver mensagens de erro ao modelo e contornar bugs em vez de investigá-los. No fim, o desenvolvedor assume a autoria de um código que não revisou.
Em uma avaliação da Veracode com mais de cem modelos, 45% das amostras geradas para as tarefas do estudo falharam nos testes de segurança. É um resultado relevante, mas limitado aos cenários avaliados por um fornecedor de segurança e não uma taxa universal de vulnerabilidade em código gerado por IA. Uma nota de pesquisa da CSA (Cloud Security Alliance) também citou um estudo anterior que apontou aumento de 37% nas vulnerabilidades críticas após sucessivas iterações sem revisão humana estruturada. Como a referência é indireta, o dado precisa ser interpretado com cautela. Ainda assim, o alerta permanece: iterar sem um gate humano não garante melhoria e pode ampliar o risco. O descompasso entre percepção e produtividade também aparece nos dados. Em um estudo da METR realizado com ferramentas do início de 2025, 16 desenvolvedores experientes levaram, em média, 19% mais tempo para concluir as tarefas com IA, embora acreditassem ter obtido um ganho de velocidade de aproximadamente 20%. O resultado é útil como alerta sobre a percepção de produtividade, mas não deve ser generalizado para todas as equipes ou gerações de ferramentas. A própria METR publicou uma atualização do experimento em fevereiro de 2026, indicando que esse cenário pode estar mudando.
Sem leitura do diff, não há evidência de que o output gerado tenha sido efetivamente verificado antes de entrar no ciclo de software. Em ambientes regulados, essa revisão pode ser exigida pela política de desenvolvimento seguro, pela segregação de funções e pelo nível de risco da mudança.
2. Prompt vago: "faça um endpoint de pagamento"#
Um prompt como “faça um endpoint de pagamento” comunica a intenção, mas não define o contrato. Sem tipos, regras de negócio, restrições de segurança e casos de borda, o modelo precisa preencher as lacunas com suposições. Em um produto financeiro, essas lacunas podem envolver taxas, limites, arredondamento, idempotência e convenções de tratamento de erros. O código resultante pode parecer coerente e tecnicamente correto, mesmo quando implementa uma regra que nunca foi definida pelo negócio.
O mesmo problema pode passar despercebido pelos testes. Se o modelo inventa determinado comportamento e, em seguida, gera o teste unitário usando essa mesma suposição como resultado esperado, o teste passa. Ele comprova apenas que o código corresponde à premissa criada pelo próprio modelo, não que corresponde à regra real do produto. A divergência pode aparecer somente na integração ou em produção.
Uma revisão recente sobre spec-driven development, publicada em 2026, reúne estudos ainda iniciais que indicam melhora na qualidade do código gerado quando especificações refinadas por humanos substituem prompts vagos. Alguns dos estudos citados reportaram reduções de erro de até 50% em cenários controlados. Como as evidências ainda são emergentes, esse número deve ser interpretado como resultado experimental, não como garantia aplicável a qualquer projeto.
Em um produto financeiro regulado, código baseado em regras de negócio presumidas pode até ter cobertura de testes, mas não possui cobertura de processo: não há uma decisão documentada que explique de onde aquela regra veio.
3. Contexto excessivo: colar o arquivo inteiro de produção#
A intuição é simples: quanto mais contexto o modelo recebe, melhor será a resposta. Na prática, contexto útil não é sinônimo de contexto abundante. Um trabalho sobre context engineering publicado em agosto de 2025 propõe a seleção e a injeção direcionada de informações relevantes para melhorar a aderência de assistentes de código a projetos complexos. A conclusão prática é que não basta preencher a janela de contexto. Arquivos inteiros podem adicionar informações redundantes, instruções conflitantes e detalhes sem relação direta com a tarefa, reduzindo a capacidade do modelo de identificar o que realmente importa, sem necessariamente sinalizar essa perda de qualidade.
A abordagem mais segura é fornecer o contexto mínimo suficiente e recuperar informações adicionais apenas quando forem necessárias. O risco, porém, não se limita à qualidade do output: colar arquivos de produção em um prompt pode expor código proprietário, credenciais, segredos, dados pessoais e informações protegidas por políticas internas ou contratos. Se o conteúdo revelar operações, serviços ou informações de clientes, também pode envolver o dever de sigilo previsto na Lei Complementar nº 105/2001. O , hook corporativo apresentado na Parte 4 da série, funciona como uma barreira preventiva: antes do envio, aplica regras para detectar dados pessoais, segredos, credenciais, arquivos protegidos e padrões de código classificados pela instituição.
O anti-padrão cria, portanto, dois riscos ao mesmo tempo: degradação silenciosa do resultado e exposição indevida de informações que não deveriam sair do perímetro corporativo.
4. Auto-merge: PR com gates automatizados verdes, sem revisão humana#
O SonarQube AI Code Assurance permite identificar projetos que contêm código gerado por IA e submetê-los a padrões de qualidade específicos, com análise estática e quality gates mais rigorosos. Esses controles são importantes, mas verificam apenas aquilo que pode ser traduzido em regras automatizadas. Um pipeline aprovado pode demonstrar que o código compilou, passou pelos testes existentes e não violou as regras configuradas. Ele não comprova, por si só, que a implementação corresponde à regra de negócio esperada. Um erro semântico em uma operação de crédito, como precisão inadequada no cálculo de juros, arredondamento diferente do previsto em contrato ou tratamento incorreto de uma condição de exceção, pode passar pelo SAST e por todos os testes disponíveis quando o comportamento correto não estiver representado em contratos, regras analisáveis ou casos de teste.
Por isso, tratar o pipeline verde como autorização automática para merge elimina um ponto importante de verificação da lógica de negócio. A necessidade dessa revisão deve ser definida conforme a criticidade da mudança, a política de desenvolvimento seguro e as regras de segregação de funções da instituição. O NIST Secure Software Development Framework, por exemplo, organiza práticas de segurança que precisam ser integradas ao ciclo de desenvolvimento, e não concentradas apenas em uma ferramenta ou etapa automatizada. Gates técnicos e aprovação humana também são controles distintos no próprio fluxo do repositório. Em plataformas como o GitHub, status checks e revisões obrigatórias de pull requests podem ser configurados separadamente nas regras de proteção da branch.
Em uma auditoria, a instituição pode precisar demonstrar como mudanças de maior risco foram analisadas e aprovadas. Um pipeline verde registra a aprovação dos controles automatizados, não substitui a evidência de revisão da lógica de negócio quando essa revisão é exigida pelo risco.
5. Delegação cega ao agente: “resolva todos os achados do Sonar”#
Pedir a um agente que analise e corrija automaticamente todos os achados de SAST parece uma forma eficiente de eliminar dívida técnica. O problema surge quando as correções são aplicadas em lote, sem escopo definido para cada item e sem uma revisão individual dos impactos. No domínio financeiro, um comportamento que parece incorreto de forma isolada pode ser intencional: um tratamento silencioso de erro, por exemplo, pode fazer parte de uma estratégia de idempotência para impedir o reprocessamento de uma transação. Ao “corrigir” esse comportamento com base apenas em uma regra genérica, o agente pode produzir uma solução tecnicamente convincente e, ao mesmo tempo, introduzir uma regressão sutil na lógica de negócio.
O OWASP Top 10 for Agentic Applications 2026 classifica como ASI09 Human-Agent Trust Exploitation o risco de respostas confiantes e bem apresentadas levarem operadores humanos a aprovar ações prejudiciais. A correção automática de um achado de SAST é um exemplo possível desse mecanismo: a alteração parece segura, satisfaz a ferramenta de análise e pode até melhorar o código localmente, mas muda um comportamento que o agente não compreende por completo. A ISO/IEC 42001, em sua cláusula 10, trata da melhoria contínua e do tratamento de não conformidades e ações corretivas. No processo de desenvolvimento, isso significa que um achado precisa ser analisado, tratado e encerrado com evidências proporcionais ao risco, e não apenas removido da lista da ferramenta. Correções em lote, sem justificativa e revisão por item, enfraquecem essa rastreabilidade. O scanner pode ficar verde, mas permanece sem resposta a pergunta mais importante: o que foi alterado, por que a solução era adequada e como a instituição verificou que ela não introduziu uma regressão?
O problema não é permitir que o agente proponha correções, mas sim transformar a proposta em alteração aprovada sem preservar o vínculo entre o achado, a decisão tomada, a revisão realizada e o resultado dos testes.
Os cinco anti-padrões em síntese:
 Ampliar ↗
Sete etapas com gates explícitos: como tornar a geração rastreável#
No Technology Radar de 2025, a Thoughtworks descreveu o spec-driven development como uma abordagem em que especificações de requisitos bem elaboradas orientam agentes de IA na geração de código executável. A própria análise, porém, faz uma ressalva: quando a especificação se torna excessivamente detalhada e tenta definir todo o trabalho antes de a implementação começar, o processo pode perder agilidade e se aproximar de um modelo em cascata.
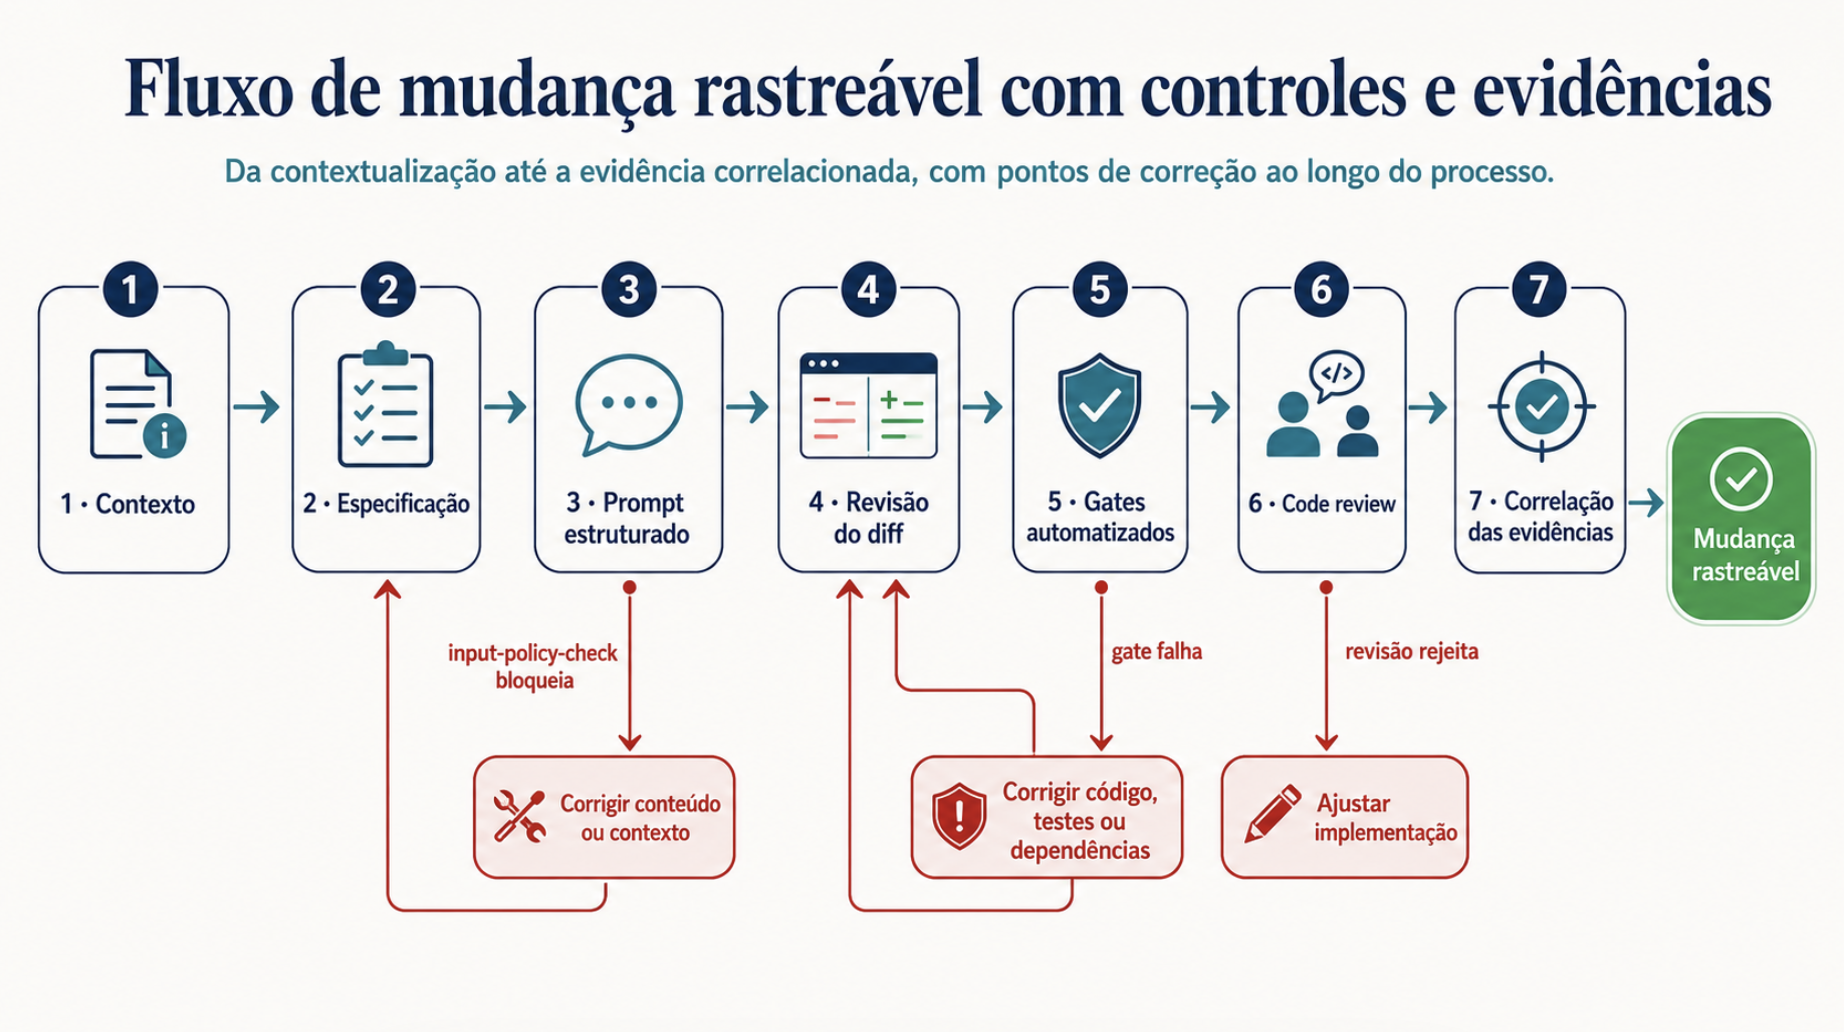
O fluxo de sete etapas apresentado a seguir reduz esse risco ao limitar cada spec a uma unidade de trabalho: uma função, um endpoint ou uma regra de negócio. A especificação orienta a próxima mudança sem tentar antecipar todo o sistema.
Ferramentas como Kiro, GitHub Spec Kit e Tessl já oferecem fluxos orientados por especificações, passando por requisitos, desenho técnico, planejamento e implementação. Essas ferramentas, no entanto, não incorporam automaticamente os controles, as evidências e as responsabilidades específicas de uma instituição financeira brasileira. Regras de acesso, proteção de dados, revisão independente, segregação de funções, rastreabilidade e retenção de evidências ainda precisam ser definidas pela própria organização.
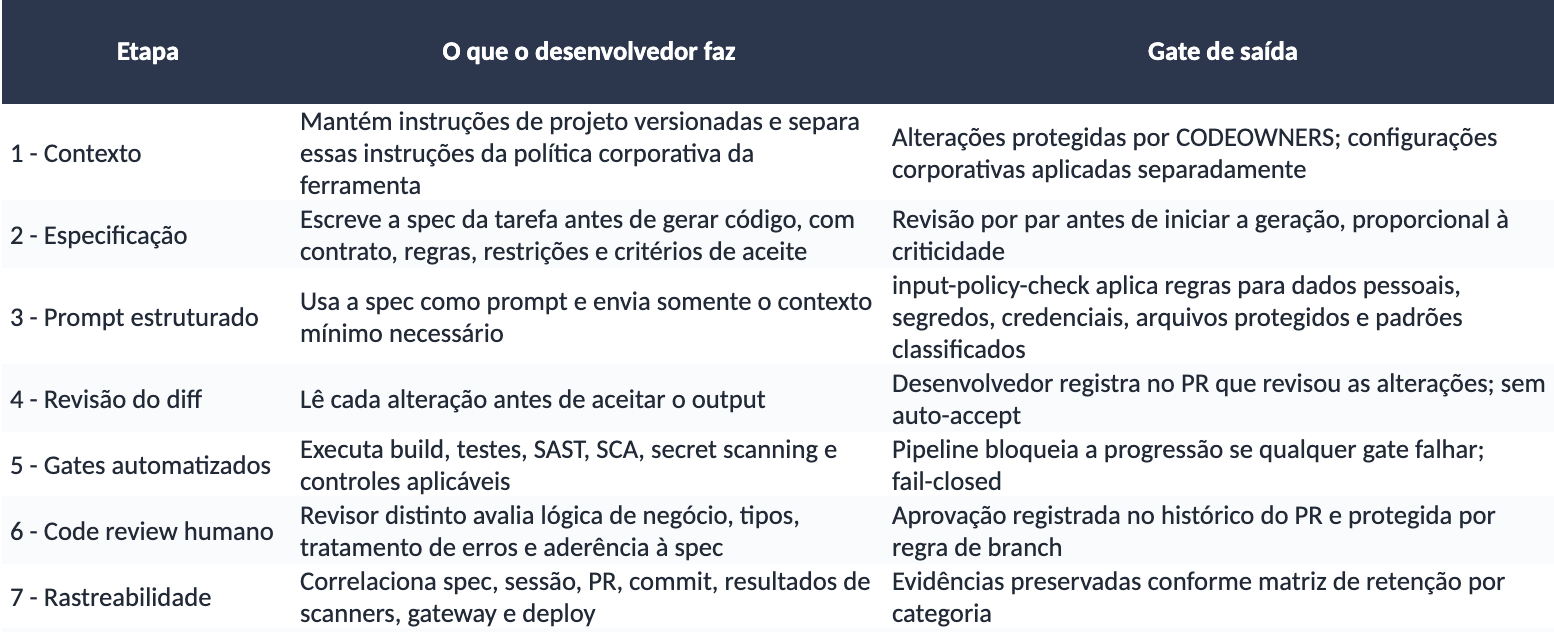
O fluxo a seguir adiciona essa camada de governança ao processo spec-first.
 Ampliar ↗
 Ampliar ↗
A revisão do diff, na Etapa 4, é a aplicação prática do controle que a Parte 3 desta série relacionou ao LLM05 Improper Output Handling, do OWASP Top 10 para aplicações com LLMs. O risco descrito pelo OWASP está no uso de outputs do modelo sem validação, tratamento ou verificação adequada antes que sejam encaminhados para outros componentes. No desenvolvimento de software, isso significa não aceitar ou executar automaticamente o código gerado. Ler o diff, compreender as mudanças e verificar seus impactos é o que transforma o output do modelo em uma alteração conscientemente assumida pelo desenvolvedor.
Ainda assim, a revisão do autor não elimina a necessidade da Etapa 6. Code review humano e gates automatizados cumprem funções diferentes.
Ferramentas como o SonarQube AI Code Assurance verificam propriedades que podem ser representadas por regras: vulnerabilidades conhecidas, bugs, complexidade, duplicação, cobertura e outros indicadores de qualidade e segurança. Esses controles são essenciais, mas trabalham sobre aquilo que foi codificado em regras, testes ou contratos analisáveis. O revisor humano avalia outra dimensão: se a implementação corresponde ao comportamento esperado pelo negócio. Isso inclui verificar se os tipos são adequados ao domínio financeiro, se os cálculos respeitam as regras do produto, se o arredondamento está correto e se o tratamento de erros reflete uma decisão documentada e não uma suposição plausível do modelo.
Por isso, a Etapa 6 não repete a Etapa 5: o pipeline demonstra que o código passou pelos controles automatizados definidos pela instituição enquanto o code review demonstra que alguém diferente do autor avaliou o significado e os impactos da mudança antes de aprová-la.
A spec como instrução ao modelo e artefato de demonstrabilidade#
Em junho de 2025, Andrej Karpathy popularizou o conceito de context engineering: a disciplina de selecionar e organizar exatamente as informações de que o modelo precisa para executar o próximo passo. No desenvolvimento assistido por IA, a spec cumpre esse papel: delimita o contexto, explicita as regras e reduz o espaço para que o modelo complete lacunas com suposições. Ao mesmo tempo, torna-se parte da evidência do processo: registra quais parâmetros, restrições e critérios deveriam orientar a geração.
A spec, sozinha, não comprova que o modelo recebeu exatamente aquelas instruções. Para isso, precisa estar correlacionada ao identificador da sessão, aos registros do gateway, ao diff, ao PR e aos resultados dos controles automatizados. Em conjunto, esses artefatos ajudam a demonstrar como a geração foi conduzida e revisada.
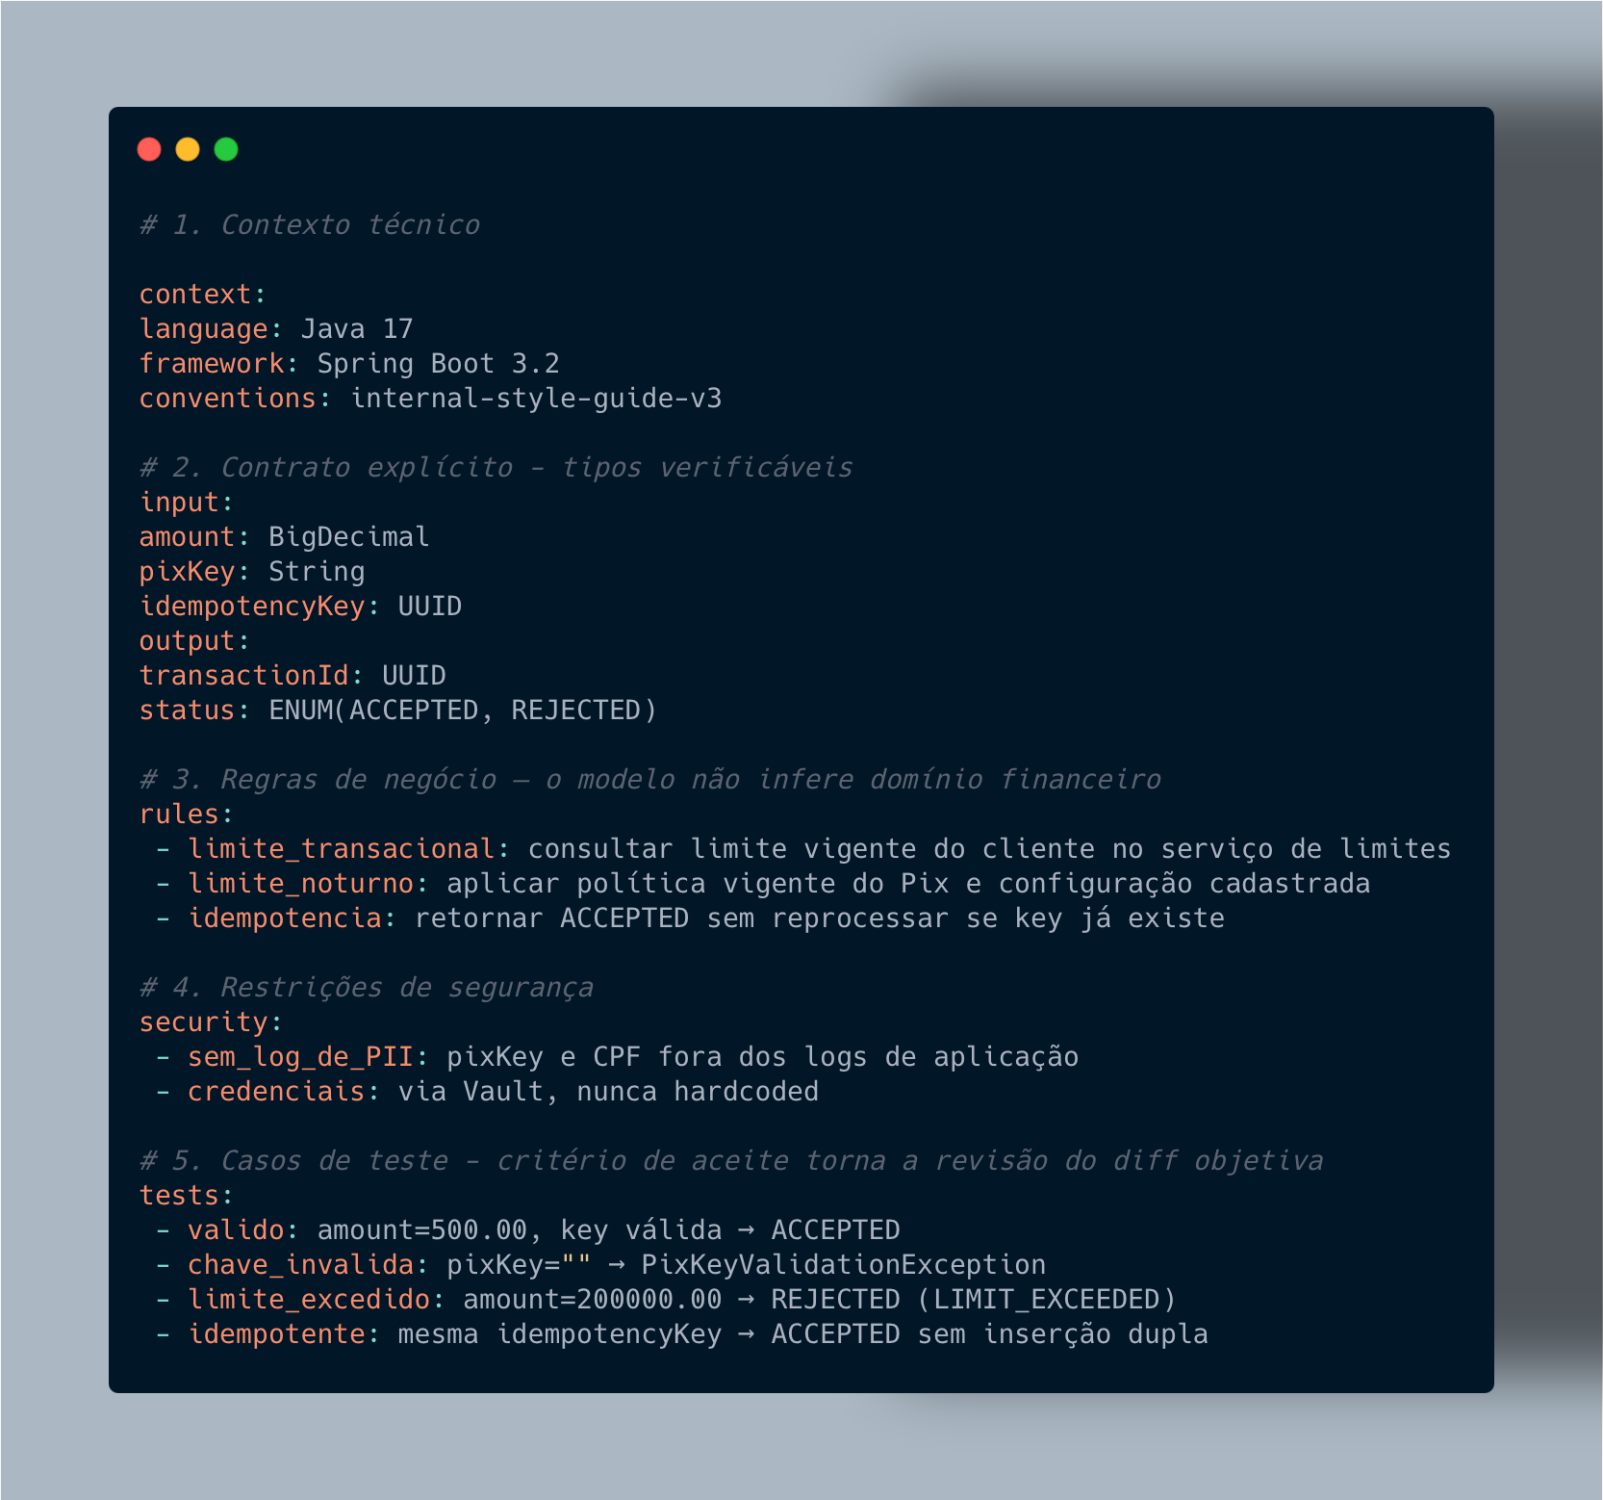
Neste modelo, a spec possui cinco componentes essenciais:
1. Contexto técnico#
Linguagem, framework, versões, bibliotecas autorizadas e convenções do projeto: sem essas informações, o modelo tende a assumir padrões genéricos, que podem divergir da arquitetura, das versões suportadas ou das práticas de segurança adotadas pela instituição.
2. Contrato explícito#
Entradas, saídas, tipos, erros possíveis e comportamento esperado: em Java, por exemplo, valores monetários devem utilizar , com escala e modo de arredondamento definidos, em vez de tipos de ponto flutuante como . Uma intenção pode ser interpretada; um contrato pode ser verificado.
3. Regras de negócio enumeradas#
Taxas, limites, arredondamento, idempotência, prioridades e condições de exceção precisam aparecer de forma explícita: o modelo não conhece automaticamente as regras proprietárias de um produto financeiro e quando elas não estão na spec, pode substituí-las por comportamentos plausíveis, mas inexistentes no negócio.
4. Restrições de segurança#
A spec também deve registrar o que o código não pode fazer: gravar dados pessoais em logs, incluir credenciais no código, ignorar validações de entrada ou utilizar tratamentos de erro fora do padrão definido. Esses controles se relacionam ao risco de LLM02 Sensitive Information Disclosure, do OWASP Top 10 para aplicações com LLMs, e aos requisitos de desenvolvimento seguro e adoção de novas tecnologias reforçados pela Resolução CMN nº 5.274/2025.
5. Casos de teste e critérios de aceite#
A spec deve cobrir o caminho de sucesso, entradas nulas ou inválidas, valores de borda, exceções e comportamentos fora do domínio: o estudo “Tests as Prompt: A Test-Driven-Development Benchmark for LLM Code Generation” explora testes como parte da especificação fornecida ao modelo e, ao mesmo tempo, como mecanismo de verificação do código gerado. Há também um ganho prático para a revisão do diff: quando os resultados esperados estão definidos antes da geração, o desenvolvedor sabe o que precisa verificar. A análise deixa de depender apenas da aparência do código e passa a compará-lo com critérios previamente documentados.
Exemplo de spec com os cinco componentes:
 Ampliar ↗
A spec não é documento de arquitetura de sistema, é granular, cobre uma tarefa. A cada iteração, começa nova spec, o que impede que contexto inventado numa sessão contamine a próxima.
Os artefatos do processo como evidência de controle#
As Partes 2 e 3 desta série mapearam as normas e os frameworks aplicáveis. Aqui, a pergunta é mais prática: quais artefatos ajudam a demonstrar que o desenvolvimento assistido por IA seguiu os controles definidos pela instituição?
A Resolução CMN nº 4.893/2021, alterada pela Resolução CMN nº 5.274/2025, determina que os procedimentos e controles de segurança também alcancem o desenvolvimento de sistemas de informação e a adoção de novas tecnologias. Quando uma ferramenta externa passa a participar desse ciclo, a instituição precisa avaliar, conforme a arquitetura e a modalidade de prestação do serviço, controles relacionados à contratação, à identidade e ao acesso, à proteção de dados, à rastreabilidade e à gestão de terceiros. Nesse processo, a spec registra as regras, as restrições e os critérios de aceite que deveriam orientar a geração, mas ela não satisfaz uma obrigação regulatória isoladamente nem prova, sozinha, que aquelas instruções foram efetivamente enviadas ao modelo. Para funcionar como evidência, precisa estar correlacionada à sessão de geração, ao diff, ao PR, ao commit e aos registros produzidos pelo gateway e pelas ferramentas de engenharia.
Em 2025, a ANBIMA publicou um modelo não vinculante de Política de Desenvolvimento Seguro de Aplicações, orientado pelo NIST Secure Software Development Framework SSDF v1.1, reforçando que os controles de segurança precisam acompanhar todo o ciclo de vida do software. Código produzido com auxílio de IA também faz parte desse ciclo. Spec, identificador da sessão, atribuição no commit, resultados dos scanners, aprovação do PR, regras de proteção da branch e logs do gateway são evidências complementares. Nenhuma delas, isoladamente, comprova que todo o processo foi executado de maneira adequada. É a correlação entre esses registros que permite reconstruir o que foi solicitado, gerado, alterado, verificado e aprovado.
Há também uma distinção importante em relação à LGPD. Quando o software colocado em produção realiza decisões tomadas unicamente com base em tratamento automatizado de dados pessoais que afetem os interesses do titular, o artigo 20 assegura o direito de solicitar a revisão da decisão. A revisão de código é outro controle, contribui para a qualidade e a governança do software, mas não substitui o processo de revisão da decisão automatizada previsto na lei.
A ISO/IEC 42001, por sua vez, estrutura um sistema de gestão para estabelecer, implementar, manter e melhorar continuamente os processos relacionados à IA. No desenvolvimento de software, isso significa que uma não conformidade não deveria resultar apenas em uma correção pontual, mas ela também pode alimentar novos testes, regras, políticas ou controles capazes de evitar a repetição do problema.
O prazo de retenção deve ser definido por categoria de evidência. Specs, aprovações de PR, logs de gateway, resultados de scanners e registros de incidentes podem ter prazos diferentes, conforme sua finalidade, criticidade, política interna e obrigação aplicável.
Sem spec, fica mais difícil demonstrar quais instruções, restrições e critérios orientaram a geração. Sem revisão do diff, falta evidência de que o output foi verificado e sem code review registrado, não há evidência de uma avaliação independente quando ela é exigida pelo risco.
Os artefatos não comprovam conformidade individualmente. Em conjunto, ajudam a demonstrar que o processo de engenharia foi definido, executado, revisado e controlado.
A spec não substitui a trilha que o auditor pode pedir. Ela organiza a intenção, os critérios e as restrições que dão sentido a essa trilha.
O fluxo de sete etapas nomeia cada componente pela sua função imediata: CLAUDE.md do projeto, hooks, CI/CD, gateway. Em 2026, o mercado ganhou termos mais precisos para o que cada um desses componentes faz no contexto de um agente de IA em produção: o CLAUDE.md é um guide, os hooks são sensores, o CI/CD é orquestração. A disciplina que sistematiza esses componentes em uma arquitetura coerente tem um nome. É o que fecha a série.
Esta é a Parte 5 de 6 da série IA Generativa em Instituição Financeira Regulada. A Parte 4 - Arquitetura com gateway on-premises, fail-closed e trilha de auditoria está em aqui. A Parte 6 fecha com harness engineering.
Links e referências#
Normas, padrões e documentos institucionais#
Resolução CMN nº 4.893/2021 - Política de segurança cibernética
Resolução CMN nº 5.274/2025 - Alterações nos requisitos de segurança cibernética
Lei Complementar nº 105/2001 - Sigilo das operações de instituições financeiras
ISO/IEC 42001:2023 - Artificial intelligence management systems
NIST SP 800-218 - Secure Software Development Framework, versão 1.1
ANBIMA - Modelo de Política de Desenvolvimento Seguro de Aplicações
Segurança de aplicações com IA#
Veracode - Insights from the 2025 GenAI Code Security Report
Cloud Security Alliance - Vibe Coding Security Debt: AI-Generated Vulnerabilities at Scale
Estudos e pesquisas#
METR - Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity
METR - Atualização do experimento de produtividade, fevereiro de 2026
Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants - arXiv 2602.00180
Context Engineering for Multi-Agent LLM Code Assistants - arXiv 2508.08322
Tests as Prompt: A Test-Driven-Development Benchmark for LLM Code Generation - arXiv 2505.09027