Uma análise de governança sobre resiliência, redundância e o custo da diversificação em provedores de IA.
A dependência de um único provedor de IA generativa deixou de ser apenas uma decisão de arquitetura e passou a representar um risco corporativo e de governança. Os últimos dezoito meses mostraram, de forma recorrente, que até os operadores de infraestrutura mais sofisticados falham. Para organizações que incorporaram IA a processos críticos, isso cria um risco de concentração: um único ponto de falha com potencial de impacto material.
A reação mais imediata costuma ser adotar mais de um provedor, o que reduz parte da exposição, mas também traz novos custos e dependências. Na prática, é uma decisão de transferência de risco: aumenta a superfície de governança, amplia a complexidade operacional e, quando a redundância existe apenas no diagrama, pode criar uma falsa sensação de segurança.
O ponto central deste artigo é que essa escolha deve ser feita com base em proporcionalidade, e não como uma decisão binária entre um ou múltiplos provedores: dimensionar a arquitetura à criticidade da função, verificar se a redundância se sustenta na infraestrutura e não apenas nos logotipos, tratar a degradação silenciosa de qualidade como um problema diferente do failover e considerar reversibilidade e estratégia de saída como requisitos de governança.
O histórico recente#
A ideia de que provedores de IA devem ser tratados como infraestrutura confiável por padrão não se sustenta diante dos incidentes recentes. As falhas observadas podem ser agrupadas em três classes, e cada uma exige uma resposta diferente.
Indisponibilidade no nível do provedor é a classe mais visível: a OpenAI sofreu uma interrupção global em abril de 2026, afetando simultaneamente o ChatGPT, o Codex e a plataforma de API, e um evento ainda mais amplo em junho de 2025, no qual a própria página de status reportou mais de vinte componentes degradados simultaneamente, o que sugere falha de arquitetura e não de um componente isolado. Do lado da Anthropic, junho de 2026 concentrou dezenas de incidentes num único mês, somando horas em estado de incidente, com episódios individuais que passaram de seis horas.
Falha na infraestrutura de nuvem que sustenta o serviço é o menos visível e frequentemente subestimado: em outubro de 2025, um race condition no sistema de DNS do DynamoDB derrubou a região us-east-1 da AWS por cerca de quinze horas; a falha atingiu cerca de 140 serviços da própria AWS, incluindo o Amazon Bedrock, e cerca de mil empresas e aplicações clientes reportaram interrupção. O caso não foi único no período: a AWS sofreu eventos físicos de data center (um incêndio numa instalação no Oriente Médio em março de 2026 e um evento térmico em maio do mesmo ano), e o Azure OpenAI Service teve degradação multirregional de cerca de sete horas em maio de 2026, originada na amplificação de retries de uma carga interna. Para quem projeta resiliência, a implicação é importante: o provedor do modelo e a nuvem usada para servi-lo podem fazer parte da mesma fronteira de falha.
Degradação silenciosa de qualidade é a classe mais difícil de detectar, porque o serviço continua disponível e não dispara alarme de disponibilidade: entre agosto e setembro de 2025, três bugs sobrepostos comprometeram as respostas do Claude sem que o serviço caísse; no pico, cerca de 16% das requisições de um modelo foram roteadas incorretamente, com sintomas diferentes conforme a plataforma. Problemas semelhantes de comportamento também atingiram ferramentas de desenvolvimento no início de 2026. Em situações como essas, a API continua respondendo e os indicadores tradicionais permanecem verdes, mas a qualidade do resultado já foi comprometida. Um painel de disponibilidade, sozinho, não identifica esse tipo de falha.
Esses episódios não ocorreram em operadores iniciantes ou em plataformas experimentais, envolveram alguns dos provedores de modelos e infraestrutura mais maduros do mercado. Assumir que não haverá falhas recorrentes, portanto, não é uma conclusão técnica, mas uma decisão de gestão.
Uma taxonomia de cinco riscos#
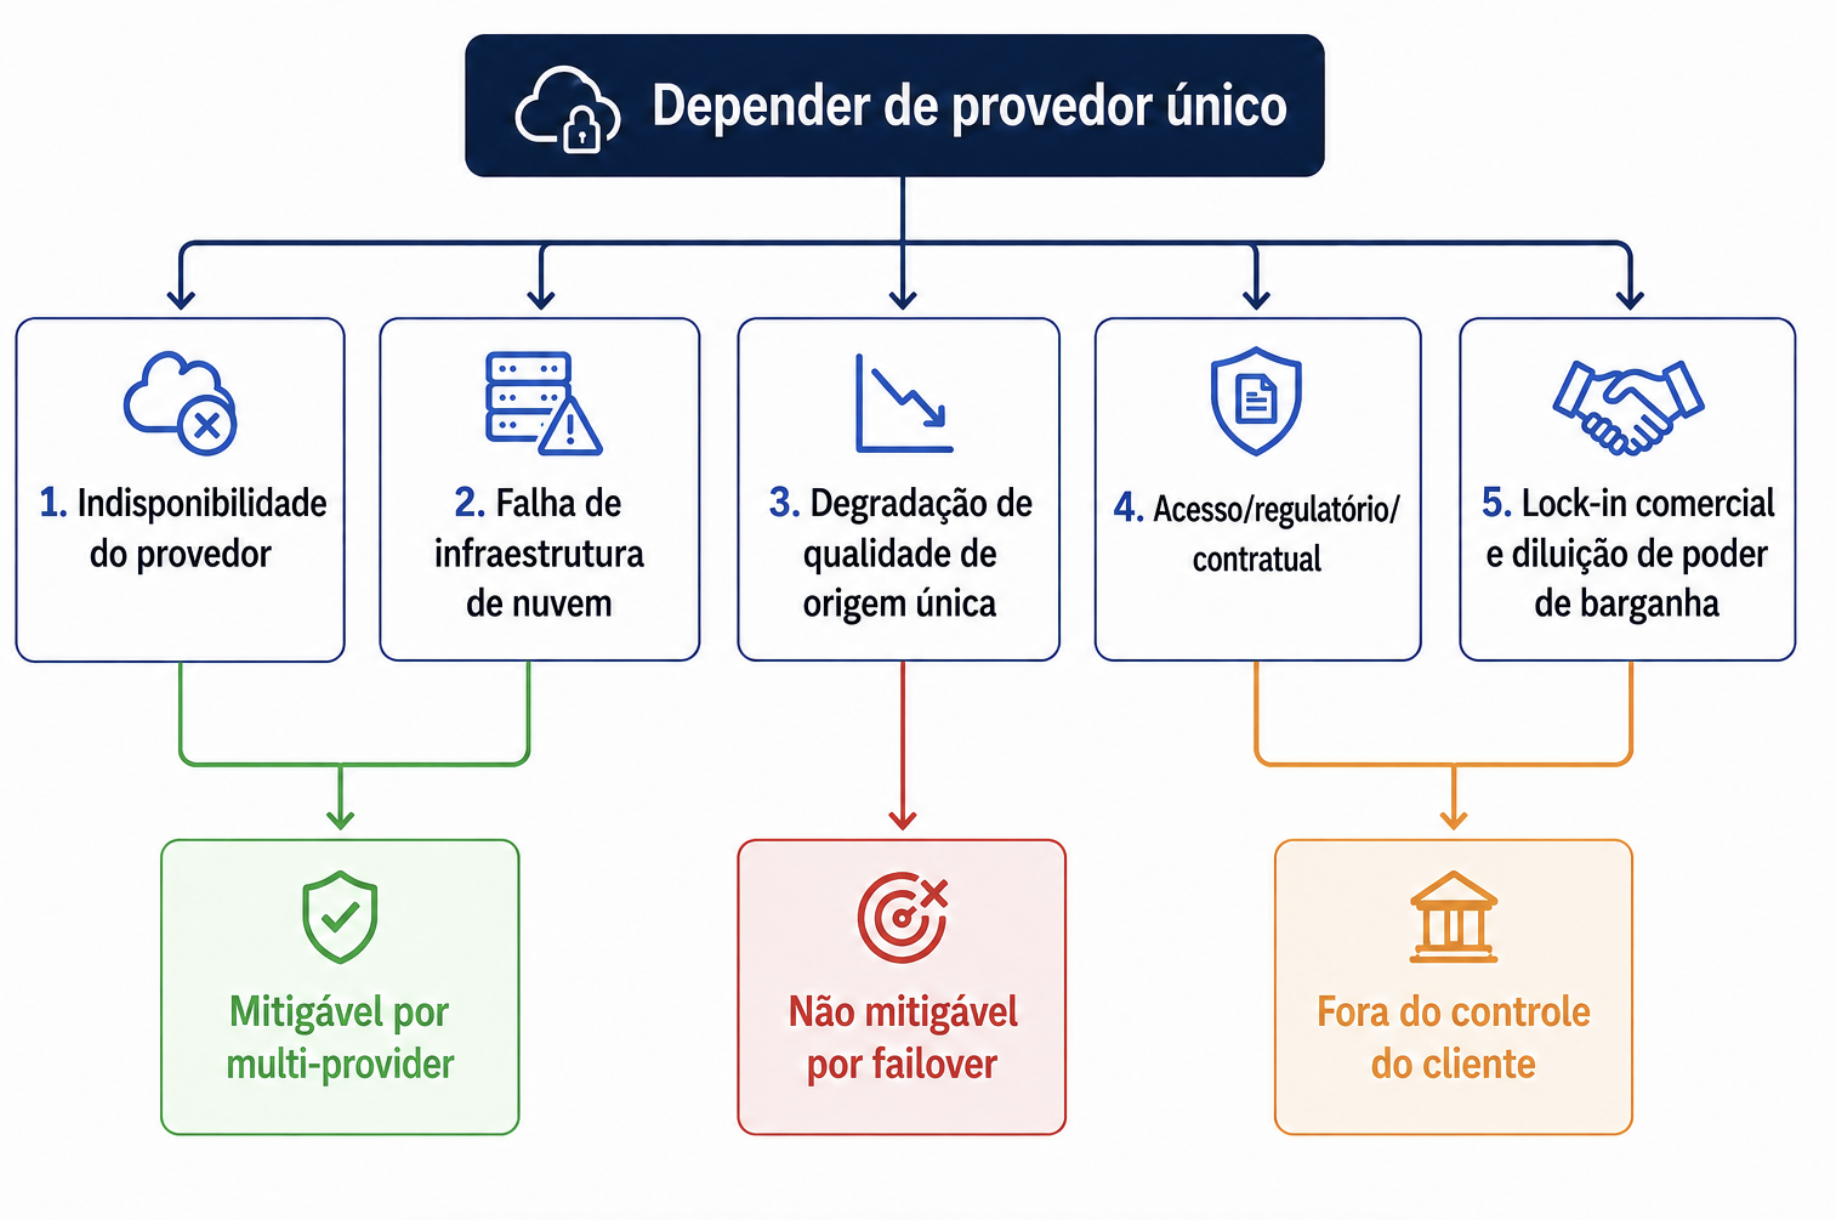
Para tomar uma decisão adequada, é preciso reconhecer que a dependência de um único provedor concentra cinco riscos diferentes:
Indisponibilidade do provedor: o serviço ou a API ficam fora do ar. É o risco mais visível e o mais fácil de mitigar com redundância.
Falha da infraestrutura de nuvem: a região ou a camada de infraestrutura que hospeda o serviço falha, derrubando os sistemas e modelos que dependem dela. Quando o modelo e a nuvem estão na mesma fronteira de falha, a redundância de modelo deixa de proteger.
Degradação de qualidade de origem única: o modelo passa a responder pior por um defeito na sua própria camada de serviço. Por ser de origem única, propaga-se a todas as nuvens que o servem ao mesmo tempo e escapa à mitigação por failover.
Risco de acesso, regulatório ou contratual: o provedor suspende ou restringe um modelo (por controles de exportação ou mudança de política, por exemplo), deprecia uma versão, altera termos ou preços. A decisão é dele.
Lock-in comercial e perda de poder de negociação: quanto mais profunda a dependência, menor a alavancagem em negociação, suporte e roadmap. Um risco de natureza mais financeira e estratégica do que operacional.
Cada risco exige uma resposta diferente. O erro mais comum, e muitas vezes o mais caro, é tentar resolver todos da mesma forma: adicionando um segundo provedor.
O alcance real do multi-provedor#
Adotar mais de um provedor é uma resposta eficaz aos dois primeiros riscos da taxonomia: indisponibilidade do fornecedor e falha da infraestrutura de nuvem. Essa estratégia também se tornou mais viável ao longo de 2026, com um movimento de convergência nas duas direções. Em junho, os modelos de ponta da OpenAI chegaram ao Amazon Bedrock, o que permite operar modelos de fronteira da OpenAI e da Anthropic lado a lado, dentro da mesma camada de identidade, faturamento e governança. No mesmo mês, os modelos Claude ficaram disponíveis de forma geral no Microsoft Foundry, hospedados na própria infraestrutura da Azure. Com isso, perdeu força a associação histórica entre escolher um laboratório e, necessariamente, depender de uma nuvem específica. O Claude, em particular, passou a ser servido nas três grandes nuvens, além da API direta.
 Ampliar ↗
Essa possibilidade, no entanto, não deve ser confundida com uma solução completa. Uma arquitetura multi-provedor pode reduzir o impacto da indisponibilidade de um fornecedor, mas não elimina degradações de qualidade nem falhas em infraestruturas compartilhadas. Além disso, introduz novos custos, dependências e riscos operacionais, discutidos na seção seguinte.
As armadilhas da diversificação#
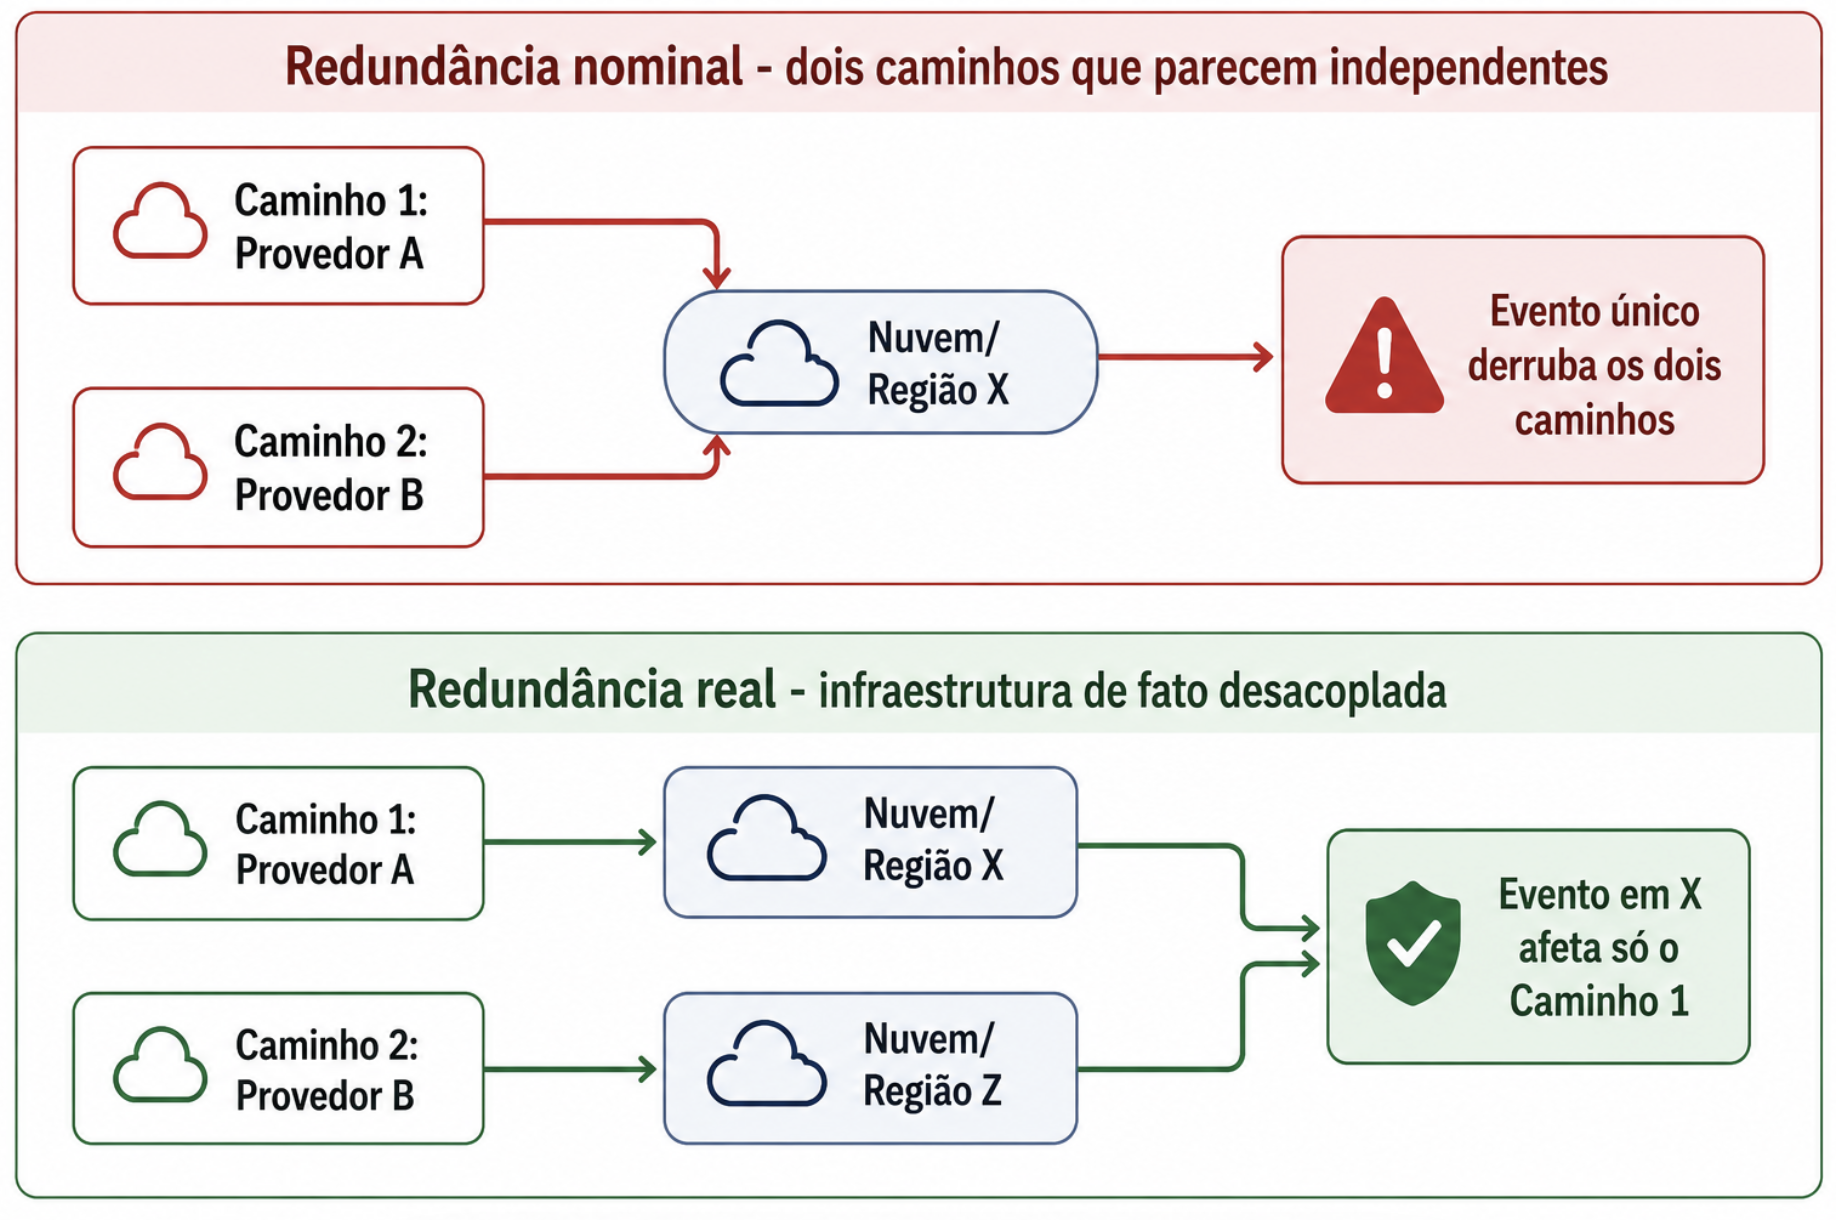
Diversificar tem um custo, e parte dele só aparece quando o caminho alternativo precisa ser acionado. A principal armadilha está na diferença entre a redundância desenhada e a que realmente existe na infraestrutura. Quando dois provedores compartilham a mesma nuvem, região ou backend, um único incidente pode afetar ambos. Por isso, o mapeamento relevante deve considerar o provedor, a nuvem, a região e a origem do modelo; a quantidade de logotipos no diagrama diz pouco sobre a fronteira real de falha. Essa é a lógica por trás da matriz apresentada no Anexo A.
Um lançamento recente torna a armadilha concreta. O Claude Platform on AWS, disponível de forma geral desde maio de 2026, oferece entrada por credenciais IAM, billing consolidado e logs no CloudTrail, mas a inferência roda na plataforma first-party da Anthropic, com os dados processados fora da fronteira da AWS. A própria AWS o classifica como oferta de terceiro, fora de seus programas de compliance (SOC, ISO, elegibilidade HIPAA). No diagrama, o serviço aparece como um segundo caminho dentro da AWS, enquanto a fronteira de falha continua sendo a da API direta da Anthropic, com outra porta de entrada.
 Ampliar ↗
A diversificação também não resolve falhas de origem única. Quando o problema está no próprio modelo ou em uma camada compartilhada do serviço, ele pode se manifestar simultaneamente em todas as plataformas que o oferecem. Nesse cenário, o failover apenas direciona o tráfego para outra instância do mesmo modelo degradado.
Cada provedor adicional também amplia a superfície de governança. Isso significa incluir mais um operador de dados, contratos e acordos de tratamento, escopo de auditoria, avaliação de risco de terceiros e pontos potenciais de ataque. Em uma instituição regulada, essa sobrecarga precisa ser prevista, financiada e acompanhada como qualquer outro custo operacional. A complexidade técnica cresce na mesma proporção. Os provedores adotam SDKs, mecanismos de autenticação, limites e comportamentos de erro diferentes. Há ainda uma diferença menos evidente: a sensibilidade aos prompts. Uma instrução que funciona bem em um modelo pode produzir resultados distintos em outro, o que exige observabilidade, avaliações e guardrails específicos para cada rota. A equivalência entre plataformas precisa ser demonstrada; raramente pode ser presumida.
Outro efeito da diversificação é a possível perda de acesso às capacidades mais recentes. Construir a solução com base apenas nos recursos comuns a todos os provedores tende a limitar a arquitetura ao menor denominador comum. Além disso, modelos oferecidos por plataformas de nuvem podem expor apenas parte das funcionalidades disponíveis na API nativa. Em alguns casos, portanto, diversificar também significa abrir mão de velocidade de inovação. Há ainda os custos diretos: capacidade redundante, gateways, integração, testes duplicados e a necessidade de manter conhecimento técnico em múltiplas plataformas. A redundância funciona como uma apólice de seguro e só faz sentido quando seu custo é proporcional ao risco que pretende cobrir.
Residência de dados e jurisdição também se tornam mais complexas. A região física da nuvem não corresponde necessariamente à jurisdição adotada pelo provedor do modelo para armazenamento, processamento ou suporte. Quando há dados regulados, cada novo caminho exige uma análise própria.
O risco mais grave, no entanto, é a falsa sensação de segurança. Uma arquitetura pode parecer resiliente no papel e continuar sujeita às mesmas falhas correlacionadas. Quando isso acontece, a organização tende a investir menos justamente nos riscos que permanecem abertos, como degradação de qualidade e infraestrutura compartilhada. A redundância tranquiliza a gestão, mas não reduz de fato a exposição.
O mesmo modelo, comportamentos diferentes#
A seção anterior apresentou as diferenças de comportamento entre canais como um dos custos de uma estratégia multi-provedor. O tema merece atenção especial porque questiona uma premissa comum em projetos de redundância: a ideia de que o mesmo modelo se comportará da mesma forma, independentemente do canal usado para acessá-lo. Essa premissa é verdadeira em um nível, mas não em todos. No nível dos pesos, a equivalência tende a ser alta. Ao chamar a mesma versão de um modelo pela API direta do fornecedor ou por um hyperscaler, usando os mesmos parâmetros, espera-se um comportamento muito próximo. Em geral, são preservados o identificador do modelo, o tamanho da janela de contexto e a semântica das ferramentas suportadas.
Se a análise terminasse aí, os canais poderiam ser tratados como intercambiáveis. Na prática, porém, o comportamento observado depende de tudo o que existe ao redor do modelo: versão disponível, filtros, guardrails, capacidade computacional, ferramentas carregadas, políticas da plataforma e forma de orquestração.
Skew de versão: um modelo com o mesmo nome pode não corresponder à mesma versão em todos os canais ao mesmo tempo. Novas versões normalmente chegam primeiro à API direta e depois são disponibilizadas nos hyperscalers, muitas vezes por meio de uma implantação gradual por região. Durante esse intervalo, dois canais podem atender versões diferentes do que o cliente entende como sendo o mesmo modelo. Para uma arquitetura de contingência, essa diferença pode produzir mudanças inesperadas de qualidade e comportamento no momento do failover.
Camadas injetadas pela plataforma: filtros de conteúdo e guardrails também variam entre canais. Uma resposta permitida pela API direta pode ser alterada, bloqueada ou recusada em outro caminho. Nesses casos, a diferença não está nos pesos do modelo, mas nas políticas e nos controles aplicados pela plataforma que o hospeda.
Preview versus disponibilidade geral: o estágio de maturidade também influencia a confiabilidade. Uma versão em preview pode operar com capacidade mais limitada, restrições adicionais ou taxas de erro superiores às observadas depois da disponibilidade geral. Em um caso registrado em 2026, a versão preview de um modelo de geração de imagens chegou a apresentar aproximadamente 45% de erros no pico. O modelo era o mesmo, mas sua confiabilidade operacional variava de acordo com o estágio de disponibilização em cada canal.
Harness e orquestração: o harness pode alterar o comportamento mesmo quando o modelo, o código e a máquina permanecem os mesmos. Em um caso público envolvendo um agente de codificação, a execução pela API direta carregava 26 ferramentas, enquanto o caminho pelo hyperscaler disponibilizava 45. Com menos ferramentas, o agente passou a executar etapas menores e mais cautelosas, triplicando o número de chamadas e o tempo total da tarefa. A velocidade de geração de tokens era praticamente a mesma. O que mudou foi o ambiente oferecido ao modelo. Esse exemplo mostra que o comportamento de uma aplicação não depende apenas do modelo selecionado. Depende também das ferramentas, instruções, políticas e mecanismos de orquestração que compõem o seu harness.
Política de dados e jurisdição por canal: as políticas de tratamento de dados também podem variar dentro do mesmo ecossistema. Um canal voltado à prototipagem pode utilizar prompts e respostas para melhoria do serviço, enquanto uma oferta empresarial pode excluir contratualmente esse uso. Da mesma forma, selecionar uma região local não elimina automaticamente todas as questões jurisdicionais. Em algumas plataformas, a legislação do país de origem do fornecedor pode continuar relevante, independentemente da região de processamento escolhida. Por isso, região de nuvem, residência de dados e jurisdição aplicável não devem ser tratadas como conceitos equivalentes.
O exemplo mais nítido até aqui vem do mesmo fornecedor, no mesmo ponto de entrada. Na AWS, o Claude pelo Amazon Bedrock mantém os dados dentro da fronteira da AWS, com a AWS como operadora e cobertura dos programas de compliance da própria nuvem; o Claude Platform on AWS, acessado pelas mesmas credenciais IAM e pelo mesmo billing, tem os dados processados pela Anthropic, fora dessa fronteira, sem a cobertura desses programas. Duas ofertas acessadas pela mesma conta AWS podem, portanto, ter regimes de dados opostos.
Mesmo quando os caminhos usam infraestruturas realmente independentes, a equivalência comportamental precisa ser testada antes que o canal alternativo seja incorporado ao plano de continuidade. A matriz do Anexo A também evidencia uma diferença estrutural entre os fornecedores. Alguns distribuem seus modelos por várias nuvens independentes, chegando hoje a quatro pilhas de inferência distintas para o mesmo modelo, o que permite redundância real, embora exija validar o comportamento em cada caminho. Outros concentraram historicamente seus modelos mais avançados em uma única nuvem, o que tornou boa parte da redundância entre canais mais aparente do que efetiva. Há ainda fornecedores cujos modelos estão disponíveis apenas na própria infraestrutura. Nesse caso, os diferentes canais continuam apoiados na mesma camada de processamento e serving.
Para uma função crítica dependente desse tipo de fornecedor, a única redundância realmente externa pode exigir a troca de modelo, e não apenas a troca de canal. Desse cenário surgem quatro controles de governança:
Fixar explicitamente a versão por canal: a organização deve registrar a versão utilizada em cada caminho e monitorar eventuais diferenças entre elas.
Normalizar parâmetros e guardrails: configurações equivalentes devem ser aplicadas sempre que possível. As diferenças que não puderem ser eliminadas precisam ser documentadas.
Avaliar cada combinação de modelo e canal separadamente: um conjunto de testes aprovado em um canal não deve ser considerado automaticamente válido para outro.
Mapear política de dados e jurisdição por caminho: as condições de tratamento, retenção, processamento e acesso aos dados podem mudar mesmo dentro do mesmo provedor.
Em uma arquitetura resiliente, portanto, mesmo modelo não significa necessariamente mesmo comportamento. O canal também faz parte da unidade que precisa ser testada, monitorada e governada.
A leitura regulatória#
O tema se encaixa melhor no campo do risco de concentração de terceiros e da resiliência operacional, que passou a receber atenção crescente dos reguladores financeiros.
No cenário internacional, o DORA, regime europeu de resiliência operacional digital para o setor financeiro, trata de forma explícita o risco de concentração em terceiros de TIC. Entre outros requisitos, exige estratégias de saída, capacidade de substituição e testes para funções críticas. O arcabouço europeu de IA também estabelece obrigações para sistemas classificados como de alto risco. Já referenciais como o NIST AI Risk Management Framework ajudam a transformar confiabilidade, robustez e continuidade em controles estruturados, mensuráveis e auditáveis.
No Brasil, a lógica é semelhante. A Resolução CMN nº 4.893/2021, atualizada pela Resolução CMN nº 5.274/2025, trata da segurança cibernética e da contratação de serviços de processamento, armazenamento de dados e computação em nuvem por instituições financeiras. Embora não use a expressão “risco de concentração” com a mesma clareza do DORA, incorpora princípios de continuidade, reversibilidade e gestão de terceiros. A LGPD também entra nessa análise. Uma arquitetura multi-provedor pode ampliar o número de operadores envolvidos no tratamento de dados, os fluxos de transferência e as responsabilidades contratuais e operacionais. Cada novo caminho, portanto, adiciona obrigações que precisam ser avaliadas e governadas.
As referências normativas devem sempre ser confrontadas com o texto vigente e com a interpretação das áreas jurídica, regulatória e de compliance. Para este artigo, o ponto principal é o princípio de governança que atravessa esses diferentes regimes. A mensagem comum é clara: concentrar uma função crítica em um único terceiro representa risco relevante, e espera-se que a organização tenha uma estratégia de saída documentada e uma capacidade de substituição efetivamente testada.
Uma dependência excessiva de um único provedor pode se tornar um achado de governança. A proliferação descontrolada de fornecedores também. Maturidade está em evitar os dois extremos.
Um framework de decisão#
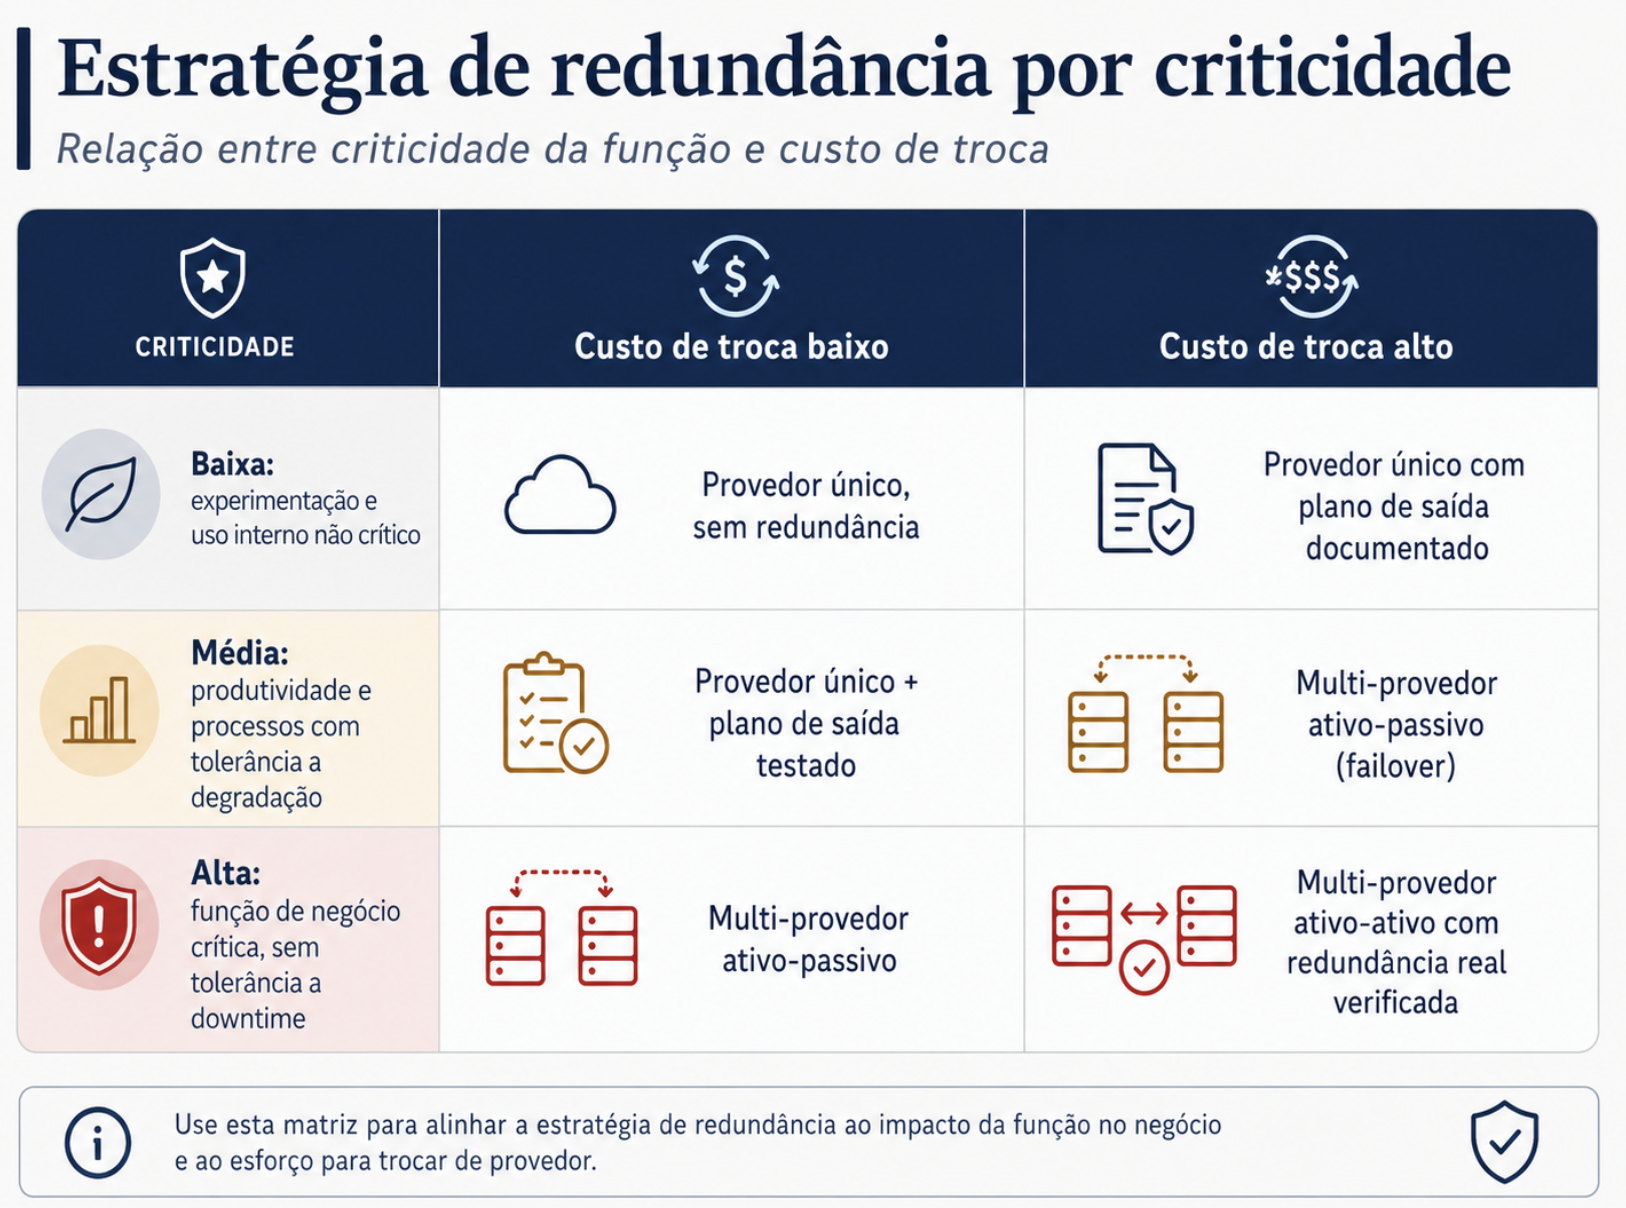
A escolha entre provedor único e arquitetura multi-provedor deve considerar duas variáveis: a criticidade da função e o custo de troca, ou seja, o grau de reversibilidade da solução.
 Ampliar ↗
A matriz também ajuda a responder quando o multi-provedor não se justifica. Em funções de baixa criticidade e com baixo custo de troca, a redundância tende a adicionar despesas, complexidade e obrigações de governança sem reduzir um risco material. Nesse cenário, um único provedor pode ser a decisão mais adequada.
Seis princípios orientam a aplicação da matriz:
Estratifique por criticidade: reserve a redundância para funções em que indisponibilidade, degradação ou dependência excessiva possam causar impacto material ao negócio.
Adote uma camada de abstração: um gateway desacopla a aplicação dos provedores por meio de uma interface comum. Com essa camada, trocar ou redirecionar o tráfego pode se tornar uma decisão de configuração. Sem ela, cada novo provedor aumenta o acoplamento e a dívida técnica.
Exija independência real da infraestrutura: os caminhos alternativos devem ser avaliados pela nuvem, região, origem do modelo e demais dependências compartilhadas. Quando dois caminhos estão dentro da mesma fronteira de falha, devem ser tratados como um só para fins de resiliência.
Trate a degradação separadamente: failover resolve indisponibilidade, mas não garante qualidade. Degradações exigem outro conjunto de controles: avaliações contínuas em produção, fixação de versão, rollback e implantação canário.
Trate reversibilidade e saída como requisitos de primeira classe: a estratégia de saída precisa ser documentada, testada e viabilizada contratualmente. A pergunta “em quanto tempo conseguimos migrar?” deve ter uma resposta ensaiada, não apenas estimada.
Dimensione a governança: cada novo provedor amplia o escopo de gestão de terceiros, acordos de tratamento de dados, segurança, monitoramento e auditoria. A diversificação só é sustentável enquanto a organização consegue governar essa complexidade.
Perguntas para a alta administração#
Para cada função crítica apoiada em IA, a alta administração deveria ser capaz de responder:
Qual é o blast radius real, considerando provedor, nuvem, região e origem do modelo?
Onde estão as dependências e fronteiras de falha compartilhadas?
A redundância declarada usa uma infraestrutura realmente independente ou protege apenas contra a indisponibilidade de um fornecedor?
Existe uma estratégia de saída documentada e testada? Em quanto tempo a organização consegue migrar, na prática?
Como a empresa identifica degradações silenciosas de qualidade, e não apenas indisponibilidade?
Cada provedor adicional passou por avaliação de risco de terceiros, acordo de tratamento de dados e definição de escopo de auditoria?
O custo da redundância é proporcional à criticidade da função que ela protege?
Quem responde por esse risco no nível executivo?
A incapacidade de responder a qualquer uma dessas perguntas já representa, por si só, um achado de governança.
Conclusão#
A decisão não se resume a escolher entre um ou vários provedores. O ponto central é entender a quais modos de falha a organização está exposta, quais deles podem gerar impacto material e qual resposta é proporcional ao risco e viável de governar.
A dependência de um único fornecedor representa um risco de concentração real e recorrente. Uma estratégia multi-provedor pode reduzir parte dessa exposição, mas também transfere o risco para novas camadas de custo, complexidade e governança. Quando mal implementada, cria apenas uma aparência de resiliência e pode esconder dependências que continuam intactas.
A maturidade passa por três movimentos: alinhar a arquitetura à criticidade de cada função, verificar se a redundância existe de fato na infraestrutura e tratar degradação de qualidade e reversibilidade como requisitos centrais. Diversificação é um controle e, como qualquer controle, precisa ser justificada, dimensionada, testada e governada.
Anexo A - Matriz de exposição por provedor e caminho de acesso#
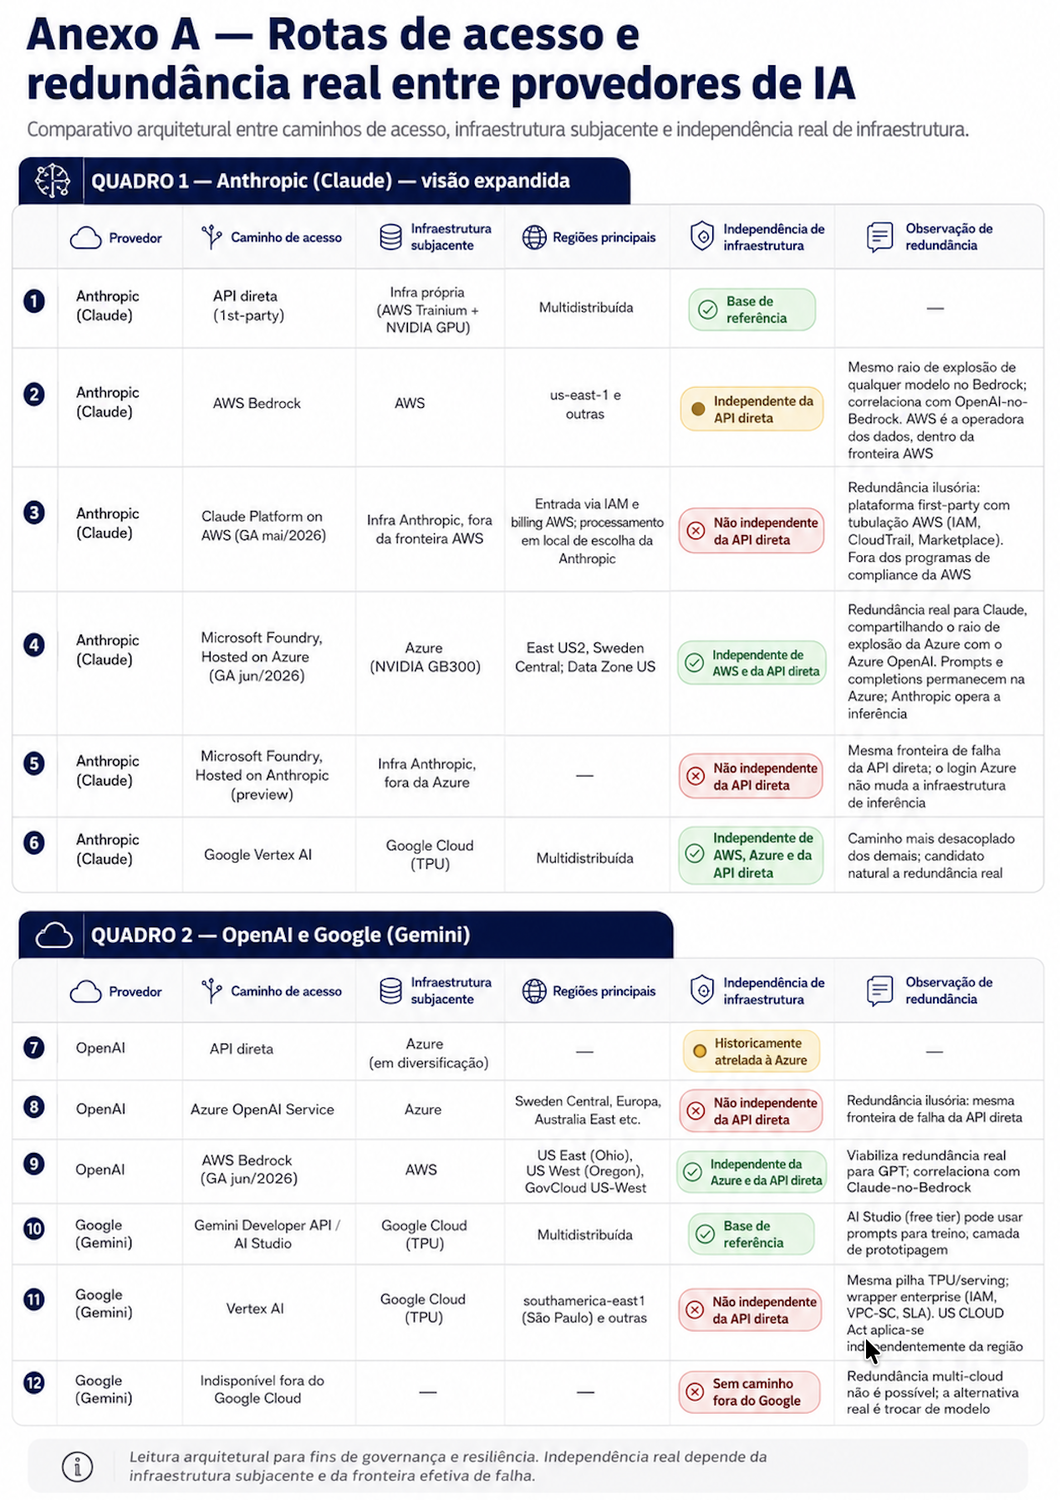
A matriz abaixo traduz em termos práticos a tese central do artigo: um caminho alternativo só aumenta a resiliência quando sua infraestrutura é realmente independente da rota principal. As duas últimas colunas concentram a leitura mais importante. Se os caminhos compartilham nuvem, região, backend ou origem do modelo, pertencem à mesma fronteira de falha. Nesse caso, devem ser tratados como um único caminho para fins de continuidade, mesmo que apareçam como provedores diferentes no diagrama.
 Ampliar ↗
Como usar a matriz na decisão de roteamento#
Combinações como Claude pela API direta e pelo Vertex AI, Claude pelo Bedrock e pelo Foundry hospedado na Azure, ou GPT pelo Azure OpenAI e pelo Amazon Bedrock oferecem redundância real, porque se apoiam em infraestruturas distintas. O Claude é hoje o único caso em que o mesmo modelo corre sobre quatro pilhas de inferência independentes: a infraestrutura própria da Anthropic, a AWS, a Azure e o Google Cloud.
As combinações que apenas parecem redundantes também aumentaram. API direta da OpenAI e Azure OpenAI continuam dentro da mesma fronteira de falha, assim como Claude e GPT executados no Bedrock na mesma região continuam expostos ao mesmo evento de nuvem. O caso novo está do lado da Anthropic: API direta, Claude Platform on AWS e Foundry hospedado na Anthropic são três portas de entrada para a mesma pilha first-party e contam como um único caminho para fins de resiliência, ainda que duas delas usem credenciais e billing de hyperscaler. Na direção inversa, o Claude pelo Foundry hospedado na Azure passa a compartilhar a fronteira de falha da Azure com o Azure OpenAI.
O Gemini permanece como o caso mais restritivo. Como seus canais ficam dentro do ecossistema do Google Cloud, alternar entre API direta, AI Studio e Vertex AI não cria redundância multi-cloud; todos continuam apoiados na mesma pilha de infraestrutura. Para uma função crítica baseada em Gemini, a redundância realmente independente exige a adoção de outro modelo, e não apenas a troca de canal.
Anexo B - Registro de incidentes de referência (2023–2026)#
Este anexo reúne as evidências que sustentam a análise apresentada na Seção "O histórico recente". As durações são aproximadas e, no caso dos incidentes do Claude em junho de 2026, os eventos foram consolidados por envolverem múltiplas ocorrências ao longo do mês. A coluna Classe segue a taxonomia apresentada na Seção "Uma taxonomia de cinco riscos".
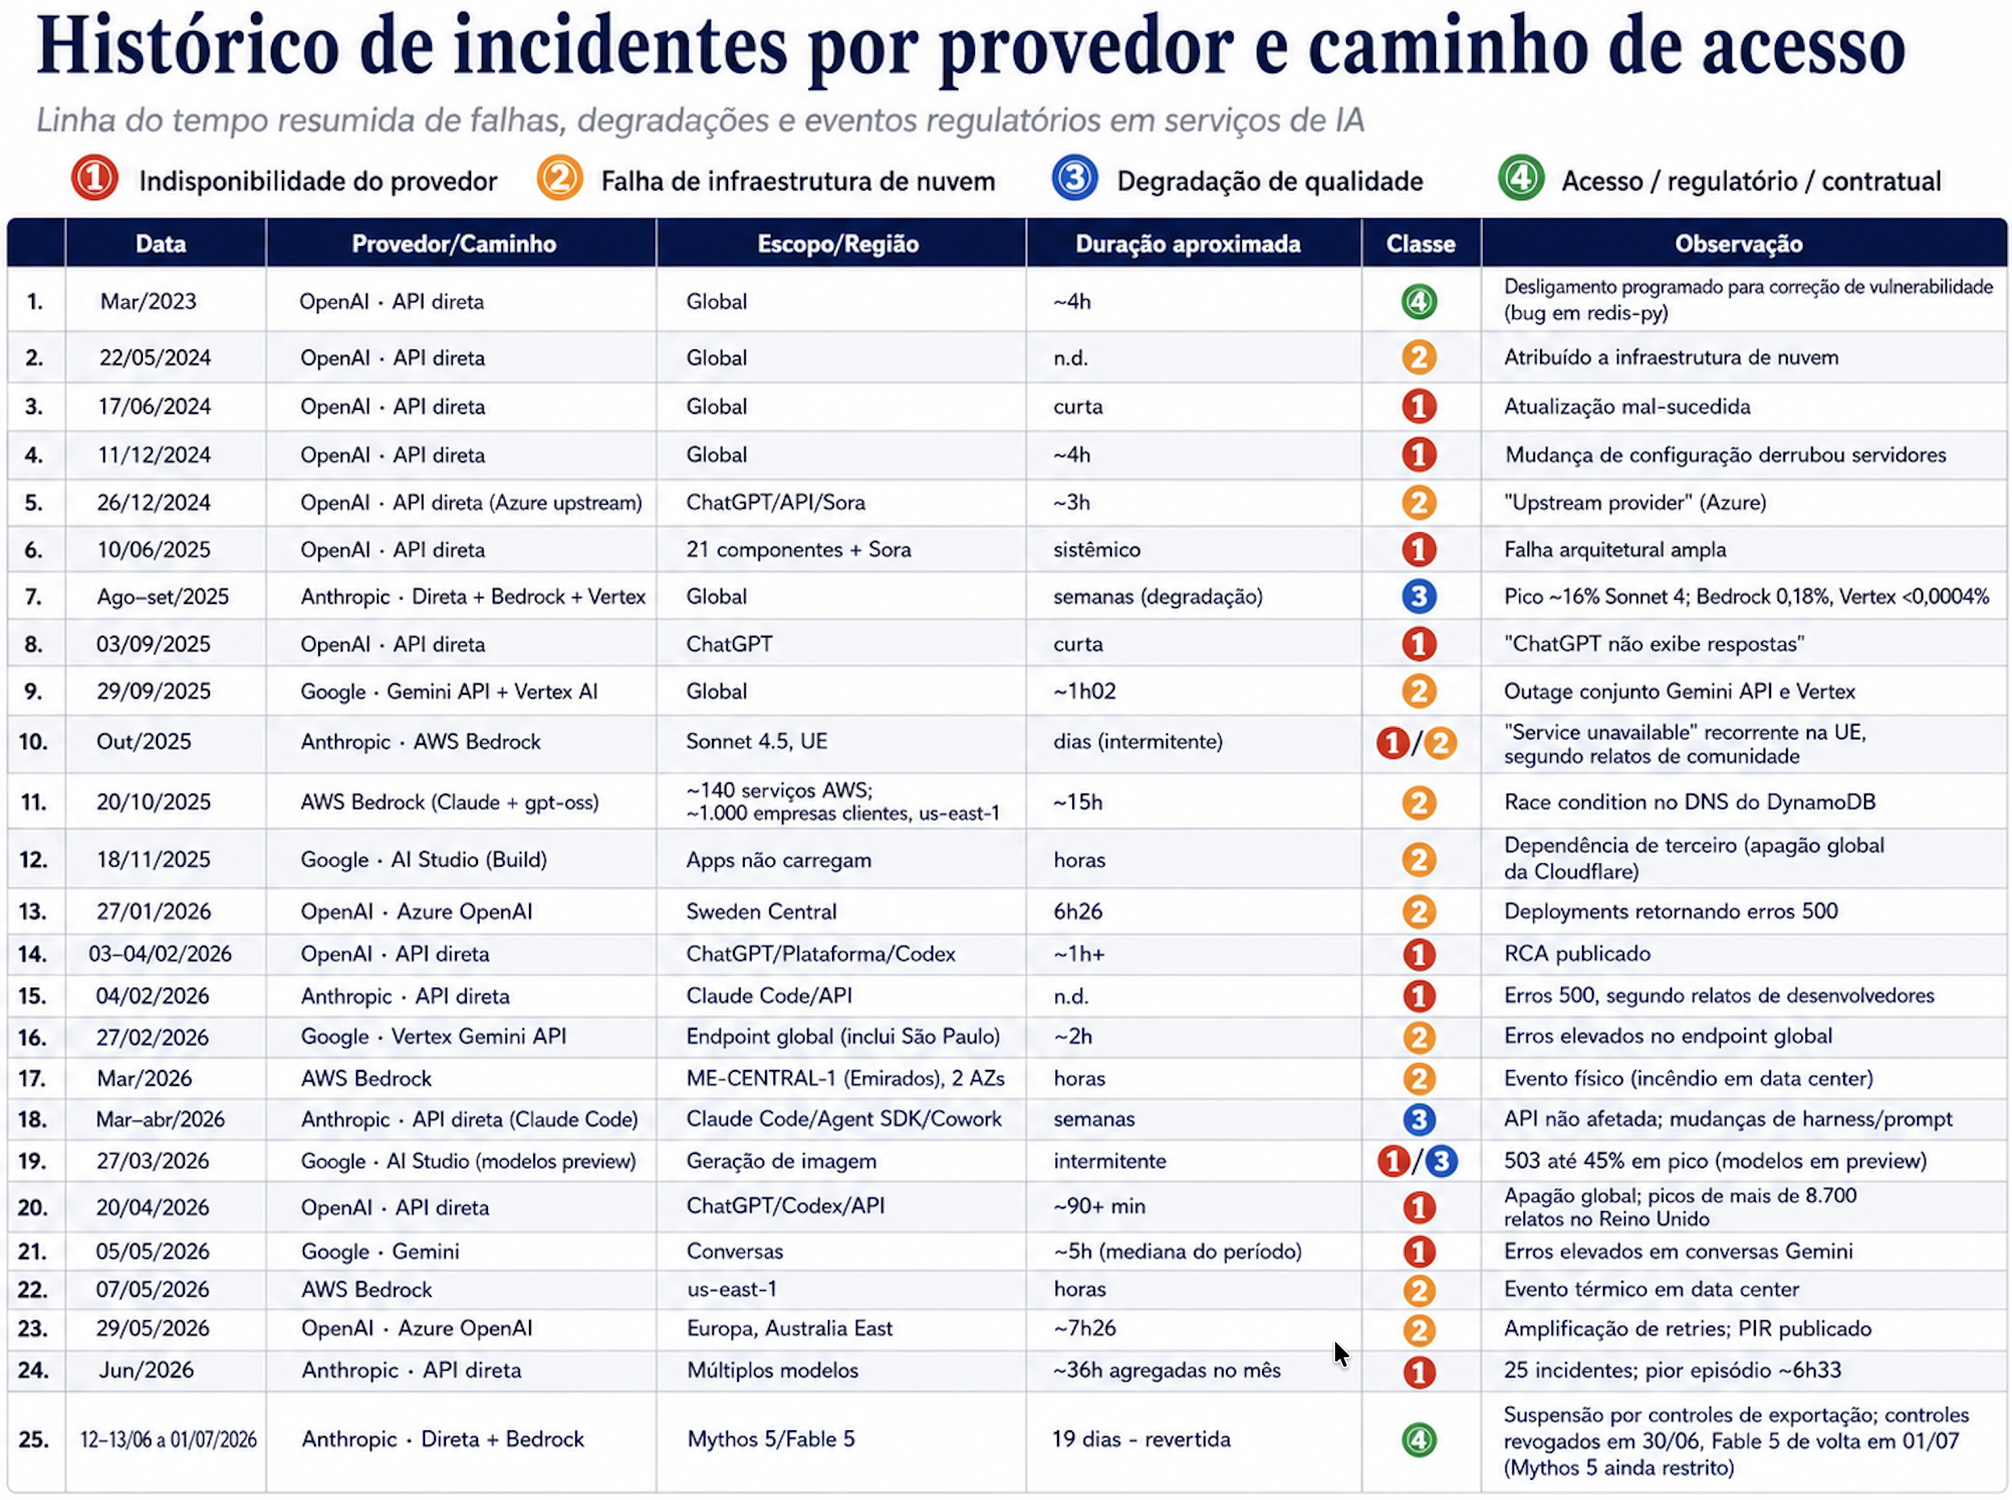 Ampliar ↗
A leitura do histórico mostra que as classes ① indisponibilidade do provedor e ② falha de infraestrutura de nuvem são as mais frequentes e também as que podem ser mitigadas por uma estratégia de redundância real. A classe ③ degradação de qualidade aparece com menor visibilidade, mas de forma recorrente. Como pode atingir simultaneamente diferentes canais de acesso ao mesmo modelo, não é resolvida apenas com failover. Nesses casos, a API continua disponível, mas a qualidade do resultado já foi comprometida. A classe ④ acesso, regulatório ou contratual ocorre com menos frequência, porém pode gerar impactos mais longos e está fora do controle direto do cliente. O episódio envolvendo Mythos 5 e Fable 5 mostra que esse tipo de restrição também pode ser revertido, mas não necessariamente dentro do prazo esperado pela organização. Os incidentes mais severos de classe ② no período (us-east-1, em outubro de 2025, e Azure OpenAI, em maio de 2026) afetaram caminhos de nuvem, e não apenas as APIs diretas dos fornecedores. Isso reforça um ponto central do artigo: muitas vezes, a fronteira de falha mais relevante está na infraestrutura que serve o modelo, e não no laboratório que o desenvolveu.
A inclusão do Gemini adiciona duas evidências importantes ao argumento da Seção "O mesmo modelo, comportamentos diferentes": a primeira é que, por permanecer concentrado no ecossistema do Google, o modelo não dispõe de um caminho de contingência verdadeiramente multi-cloud. O incidente de 27 de fevereiro de 2026 atingiu inclusive a região de São Paulo, o que é especialmente relevante para operações que dependem de processamento local; a segunda é que canais diferentes do mesmo provedor podem apresentar superfícies de falha próprias. Os problemas observados no AI Studio Build, relacionados a dependências como Cloudflare e esm.sh, mostram que mudar de canal não elimina necessariamente o risco; em alguns casos, apenas desloca a dependência para outra camada da arquitetura.
Fontes e referências#
Postmortems e write-ups oficiais#
Anthropic - A postmortem of three recent issues (set/2025, degradação ago–set/2025): anthropic.com/engineering/a-postmortem-of-three-recent-issues
Anthropic - An update on recent Claude Code quality reports (abr/2026, degradação mar–abr/2026): anthropic.com/engineering/april-23-postmortem
OpenAI - March 20 ChatGPT outage: Here's what happened (incidente redis-py, mar/2023): openai.com/index/march-20-chatgpt-outage
OpenAI - write-up do incidente de 09–10/06/2024 (systemd-networkd): status.openai.com
OpenAI - write-up do incidente de 03–04/02/2026, relacionado ao cache de feature gate: status.openai.com
AWS - Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region(19–20/10/2025): aws.amazon.com/message/101925
Microsoft Azure - Post Incident Review LYXT-C1Z, Azure OpenAI Service (29/05/2026), disponível no histórico oficial de status: azure.status.microsoft/en-us/status/history
Páginas de status e históricos oficiais#
Fontes utilizadas para incidentes sem write-up dedicado, incluindo 22/05/2024, 26/12/2024, 03/09/2025, Sweden Central em 27/01/2026, o evento térmico de us-east-1 em 07/05/2026 e a série de incidentes da Anthropic em junho de 2026:
Anthropic: status.claude.com, histórico consultado em 03/07/2026
OpenAI: status.openai.com
Microsoft Azure: azure.status.microsoft/en-us/status/history
AWS Health Dashboard: health.aws.amazon.com/health/status
AWS Post-Event Summaries: aws.amazon.com/premiumsupport/technology/pes
Suspensão do Fable 5 e do Mythos 5#
Anthropic - Statement on the US government directive to suspend access to Fable 5 and Mythos 5 (12/06/2026): anthropic.com/news/fable-mythos-access
Fortune - cobertura da suspensão (13/06/2026): fortune.com
CNBC - revogação dos controles e retorno do Fable 5 (30/06/2026): cnbc.com
Cobertura de imprensa técnica#
Bloomberg - queda do Claude em 02/03/2026 e atribuição a “unprecedented demand”: bloomberg.com
Data Center Dynamics - incêndio em data center AWS no ME-CENTRAL-1 em 01/03/2026: datacenterdynamics.com
TechRadar - apagão global de ChatGPT, Codex e API em 20/04/2026: techradar.com
ThousandEyes - análise do incidente sistêmico da OpenAI em 10/06/2025: thousandeyes.com
Fortune - cobertura do postmortem do Claude Code em 24/04/2026: fortune.com
Simon Willison - nota sobre o postmortem do incidente da OpenAI em 11/12/2024, com referência ao write-up oficial: simonwillison.net
InfoQ - análise do postmortem da AWS para o incidente de us-east-1, em outubro de 2025: infoq.com
Disponibilidade multi-nuvem#
AWS - OpenAI models and Codex on Amazon Bedrock are now generally available (01/06/2026): aws.amazon.com/blogs
InfoQ - cobertura da disponibilidade geral no Bedrock após o fim do arranjo de exclusividade com a Azure: infoq.com
Microsoft Azure - Claude in Microsoft Foundry is now generally available (jun/2026): azure.microsoft.com/en-us/blog/claude-in-microsoft-foundry-is-now-generally-available/
Anthropic - Claude in Microsoft Foundry (jun/2026): claude.com/blog/claude-in-microsoft-foundry
Microsoft Learn - Claude models in Microsoft Foundry (modalidades Hosted on Azure e Hosted on Anthropic, regiões e deployment types): learn.microsoft.com/en-us/azure/foundry/foundry-models/concepts/claude-models
AWS - Claude Platform on AWS (página oficial do serviço, incluindo a descrição de processamento fora da fronteira AWS): aws.amazon.com/claude-platform/
AWS Docs - Claude Platform on AWS vs Amazon Bedrock (classificação como oferta de terceiro, fora dos programas de compliance da AWS): docs.aws.amazon.com/claude-platform/latest/userguide/cpa-vs-bedrock.html
Referências regulatórias e frameworks#
DORA - Regulamento (UE) 2022/2554: eur-lex.europa.eu
EU AI Act - Regulamento (UE) 2024/1689: eur-lex.europa.eu
NIST AI Risk Management Framework: nist.gov
Resolução CMN nº 4.893/2021: bcb.gov.br
Resolução CMN nº 5.274/2025: bcb.gov.br
LGPD - Lei nº 13.709/2018: planalto.gov.br
Nota de transparência: os registros de instabilidade do Sonnet 4.5 pelo Bedrock na Europa, em outubro de 2025, e os erros 500 do Claude Code, em 4 de fevereiro de 2026, baseiam-se em relatos de comunidade e discussões de desenvolvedores no GitHub. Não foi localizado um write-up oficial para esses eventos e, por esse motivo, eles não recebem link para uma fonte primária nesta lista.
As referências a incidentes baseiam-se em dados públicos de status e de imprensa do período 2023–2026; as referências regulatórias são ilustrativas e devem ser confrontadas com o texto normativo vigente antes de qualquer aplicação formal.