Roteamento, throughput e governança
O custo da inteligência artificial não é uma despesa que se reduz por decreto. É uma decisão de arquitetura e, quando envolve dados sensíveis e operações que precisam ser auditáveis, também de governança. A seleção do modelo adequado para cada tarefa e o uso de modelos self-hosted e open source são duas alavancas estratégicas.
A conta chegou#
Empresas que passaram dois anos incentivando o uso massivo de IA generativa começaram a frear. Reportagem do New York Times [1], assinada por Eli Tan e republicada pela InfoMoney em junho de 2026, mostra Amazon, Walmart, Uber, Cisco e Meta adotando mecanismos para conter um gasto que cresceu mais rápido do que o previsto. A Uber gastou nos primeiros quatro meses de 2026 o orçamento que havia reservado para o ano inteiro e passou a impor limites mensais às ferramentas de programação com IA. A Meta limitou o uso depois de um aumento "exponencial" de custos e desligou os rankings internos de "tokenmaxxing", uma disputa que estava gerando consumo artificial. A Amazon derrubou seu dashboard de consumo e passou a direcionar para o uso de uma ferramenta interna. O recado, em todas, é o mesmo: usem menos.
Mas essa é a resposta certa? Racionar trata o sintoma e ignora a causa.
O custo de IA não é um vazamento de caixa que se estanca por decreto. É consequência de decisões de arquitetura que, muitas vezes, ninguém tomou de forma deliberada. E, quando envolve dados sensíveis, é uma questão de governança antes de ser uma questão financeira.
Duas alavancas produzem mais resultado do que qualquer teto de gastos por funcionário e ainda recebem pouca atenção: definir qual modelo executa cada tarefa e decidir onde cada modelo será executado.
O gatilho é técnico antes de ser financeiro#
A virada não começou no financeiro, mas sim quando as empresas trocaram chatbots por agentes.
Enquanto um assistente apenas responde, um agente planeja, aciona ferramentas, avalia o resultado e repete o ciclo até concluir a tarefa. Cada etapa desse loop consome tokens, o que faz uma interação agentica custar significativamente mais do que uma resposta convencional de chatbot. Segundo o relatório Decoding the Agentic Economy do Goldman Sachs [2], conforme noticiado, um agente always-on pode consumir mais de 100 mil tokens por dia, ante cerca de mil tokens de um chatbot. Por tarefa, o consumo pode ser aproximadamente quatro vezes maior e, em arquiteturas multiagente, esse custo volta a se multiplicar.
Ao mesmo tempo, a cobrança migrou da assinatura fixa para o token. Cada fluxo automatizado virou uma linha visível na fatura, e diretores financeiros e conselhos passaram a enxergar o gasto pela primeira vez. O mercado foi ensinado a tratar IA como algo barato ou gratuito, mas a conta por token mostrou que não é.
Daí o problema do teto por pessoa. Limitar o funcionário trata uma capacidade estratégica como vazamento de caixa: corta custo e, junto, corta valor. Em qualquer organização onde a IA já decide rota de atendimento, apoia classificação de risco ou sustenta produtos, esse é o instrumento mais grosseiro disponível, e, em um ambiente regulado, onde a IA opera dentro de processos auditáveis, é também o mais arriscado. A pergunta certa não é quanto cada funcionário pode gastar, mas qual modelo executa qual tarefa, e onde cada um roda.
Primeira alavanca: roteamento de modelo#
O maior desperdício em IA generativa normalmente não está no volume, mas sim em rodar o modelo mais caro em toda tarefa.
Os principais laboratórios de IA organizam seus modelos em camadas. No topo, os modelos de fronteira (Claude Opus, GPT-5.5 e Gemini 3.1 Pro) entregam maior capacidade de raciocínio sob ambiguidade, planejamento e execução de tarefas complexas. Na camada intermediária, modelos como Claude Sonnet, GPT-5.4 mini e Gemini 3.5 Flash oferecem melhor equilíbrio entre capacidade, latência e custo para a maior parte da operação. Na base, Claude Haiku, GPT-5.4 nano e Gemini 3.1 Flash-Lite atendem tarefas estreitas e de alto volume: classificar, extrair, rotear e responder ao trivial. A diferença de preço é o que torna a escolha consequente. Na tabela atual da Anthropic [3], o Opus custa US$ 25 por milhão de tokens de saída, contra US$ 5 do Haiku, cerca de cinco vezes. A distância chega a uma ordem de grandeza (dez vezes ou mais) quando se compara o topo de mercado com modelos abertos econômicos como DeepSeek e Qwen. Em qualquer um dos recortes, a conclusão é a mesma: pagar preço de fronteira por trabalho trivial é desperdício puro.
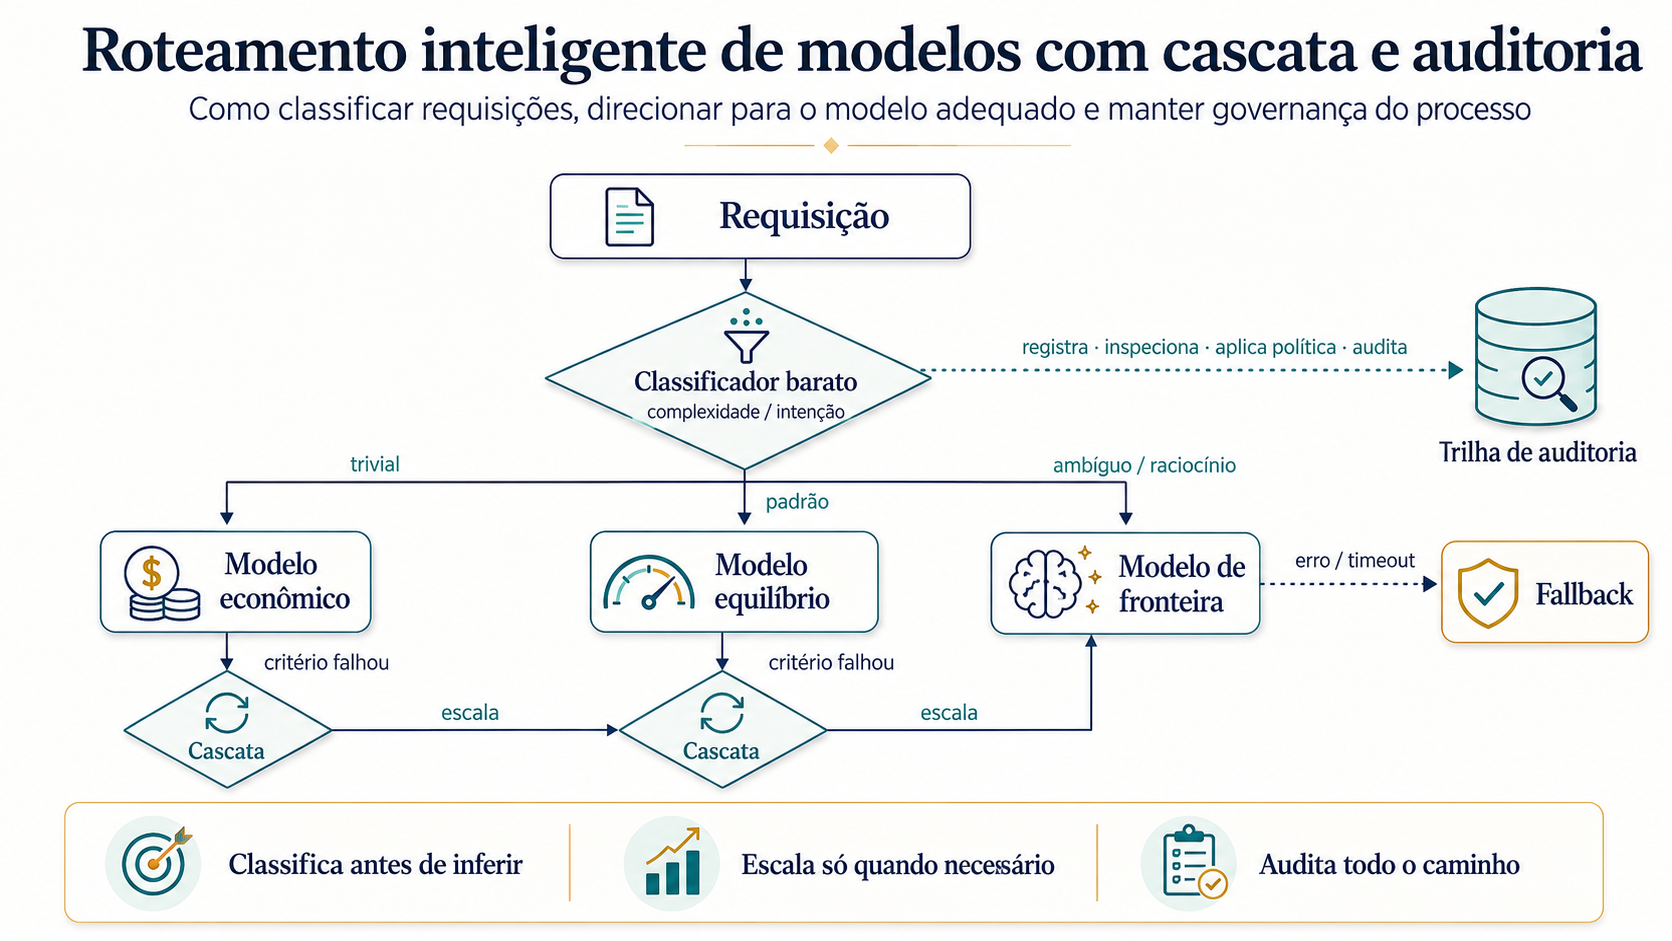
A disciplina que separa operação enxuta de fatura inflada tem nome: roteamento. Consiste em decidir, tarefa a tarefa, qual camada cada uma merece. Um classificador de intenção não precisa de um modelo de fronteira; uma análise de texto jurídico ambíguo talvez precise. Quando tudo cai por padrão no modelo mais capaz, a organização paga preço de raciocínio por trabalho que um modelo cinco vezes mais barato faria igual.
Como um router é construído na prática#
Uma revisão abrangente da literatura sobre roteamento dinâmico e cascata de modelos [4] organiza o problema em três eixos:
Quando a decisão é tomada: antes da geração, depois de uma primeira resposta ou em um processo de múltiplas etapas, como nas cascatas, que começam com um modelo mais barato e escalam para outro mais capaz quando a resposta inicial não atende aos critérios definidos.
Quais informações são utilizadas: características da consulta, metadados dos modelos, sinais extraídos da resposta e feedback acumulado.
Como a decisão é calculada: por heurísticas e regras fixas, classificadores supervisionados, algoritmos de bandit ou aprendizado por reforço.
O padrão concreto mais comum é simples. Um classificador barato lê a query e estima complexidade ou intenção; conforme o resultado, despacha para a camada econômica, equilibrada ou de fronteira; e um fallback cobre o que escapa. O vLLM Semantic Router [5] faz isso com um classificador ModernBERT, mandando consultas que exigem raciocínio para modelos com cadeia de pensamento e as triviais para inferência padrão. As implementações de referência existem: RouteLLM, da LMSYS [6], é a canônica em código aberto; o GPT-5 da OpenAI carrega um router interno entre tiers; a Azure vende roteamento de modelo como serviço.
Já detalhei três arquiteturas de router em "Três routers, três problemas" falando sobre DSPy, semantic router customizado e biblioteca pronta. Lá o roteamento é de intenção, dentro de um único assistente: decidir se a mensagem é busca de catálogo ou suporte. Aqui o roteamento é de modelo, por custo e capacidade. O objeto da decisão muda, mas a mecânica do classificador barato como porta de entrada é a mesma.
 Ampliar ↗
Roteamento bem-feito não reduz o que a IA entrega: reduz o que ela cobra para entregar o mesmo.
Segunda alavanca: código aberto auto-hospedado#
A camada seguinte de economia substitui o consumo via fornecedor pela execução em infraestrutura própria. Modelos opensource self hosted, como Llama, Mistral e, cada vez mais, os chineses DeepSeek e Qwen, rodam dentro do ambiente da empresa, sem cobrança por token pelo provedor.
A adoção desses modelos deixou de ser marginal, e vale ser preciso sobre o tamanho do salto. Dados da plataforma OpenRouter [7], que roteia chamadas de milhares de desenvolvedores, mostram os modelos chineses opensource saindo de cerca de 1% no fim de 2024 para a maior fatia entre os modelos abertos mais usados. Em alguns recortes de 2026, quando se olha o volume entre os dez modelos mais consumidos, eles chegam a 46% a 61% do total identificado. Isso não significa que já respondam pela maior parte do consumo global: os modelos proprietários ainda dominam o agregado. Entre os modelos opensource, porém, a liderança mudou de lado, impulsionada por preços agressivos, arquiteturas eficientes e pela flexibilidade de executar modelos self hosted com acesso aos seus pesos.
A troca não é mágica. Ao adotar modelos self hosted, a empresa substitui o custo por token por custos de infraestrutura, engenharia e operação: GPUs, MLOps, segurança, observabilidade e equipes capazes de responder quando algo falha - sem o SLA de um fornecedor externo a quem recorrer. E há um detalhe que determina se essa conta realmente fecha: a economia dos modelos self hosted é, em essência, uma equação de throughput.
A economia da auto-hospedagem é uma equação de throughput#
O custo unitário do token em uma operação self hosted é, de forma simplificada, o custo total da infraestrutura dividido pelo volume de tokens que ela consegue servir no mesmo período:
custo por token = custo total da infraestrutura ÷ total de tokens servidos
Quanto mais requisições simultâneas uma GPU consegue processar, mantendo latência e qualidade aceitáveis, maior é o denominador e menor é o custo de cada token. Em essência, toda a engenharia dos servidores de inferência (batching, quantização, paralelismo, gerenciamento de memória e otimização do cache de atenção) existe para elevar esse throughput.
Isso torna o break-even calculável. Análises publicadas em 2026 sobre self hosted versus API [8] estimam que o ponto de equilíbrio em relação a APIs premium, da classe Claude Sonnet ou GPT-4o, fique entre 5 e 10 milhões de tokens por mês. Na comparação com APIs de menor custo, como DeepSeek e modelos mini, o break-even sobe para algo entre 50 e 100 milhões de tokens mensais: nesses casos, o token via API já é barato demais para justificar facilmente a infraestrutura própria.
Para dimensionar o limite superior, uma GPU A100 servindo um modelo de aproximadamente 70 bilhões de parâmetros com vLLM pode alcançar entre 1.000 e 3.000 tokens por segundo, dependendo do modelo, da quantização, do tamanho do contexto, do batching e do perfil da carga. A uma média sustentada de 1.500 tokens por segundo, a capacidade teórica chega a aproximadamente 3,9 bilhões de tokens por mês.
Mas o custo real não se limita à GPU. O hardware de aceleração pode representar apenas 30% a 40% do custo total de propriedade. O restante envolve rede, armazenamento, redundância, energia, segurança, observabilidade, MLOps e operação. Por isso, uma estimativa realista pode exigir um multiplicador de 2,5 a 3 vezes sobre o custo isolado do hardware, além de 10 a 20 horas mensais de engenharia.
A conclusão é direta: abaixo do break-even, manter modelos self hosted costuma se justificar por controle de dados, residência, segurança ou requisitos regulatórios, não necessariamente por preço. Acima dele, com utilização consistente da infraestrutura, o custo por token pode cair rapidamente.
O motor que define a inclinação da curva#
Modelos de pesos abertos não entram em produção sozinhos. Entre o modelo e a aplicação, é necessário um motor de inferência capaz de administrar memória, concorrência e geração de tokens. O vLLM tornou-se o padrão de fato opensource para essa camada. Dois de seus mecanismos ajudam a explicar como ele amplia (muitas vezes em duas a quatro vezes) o denominador da equação de custo.
O primeiro é o PagedAttention. Um dos principais gargalos de memória na inferência de LLMs é o KV cache, o cache de atenção que cresce a cada token processado ou gerado para cada sequência ativa. Os sistemas anteriores reservavam blocos contíguos de memória com base no tamanho máximo previsto para cada sequência. Como poucas requisições utilizavam toda a capacidade reservada, grande parte da memória permanecia ociosa ou era perdida por fragmentação. O artigo original do vLLM [9] aponta que esse modelo de alocação podia desperdiçar entre 60% e 80% da memória reservada. O PagedAttention reorganiza o KV cache em blocos não contíguos, de forma semelhante ao gerenciamento de páginas da memória virtual de um sistema operacional. Com isso, o desperdício pode cair para cerca de 4% [10]: usando blocos de 16 tokens, a perda fica praticamente limitada ao último bloco parcialmente ocupado de cada sequência. Na prática, memória que antes permanecia reservada e ociosa passa a acomodar mais requisições simultâneas na mesma GPU. O resultado é maior throughput e menor custo por token servido.
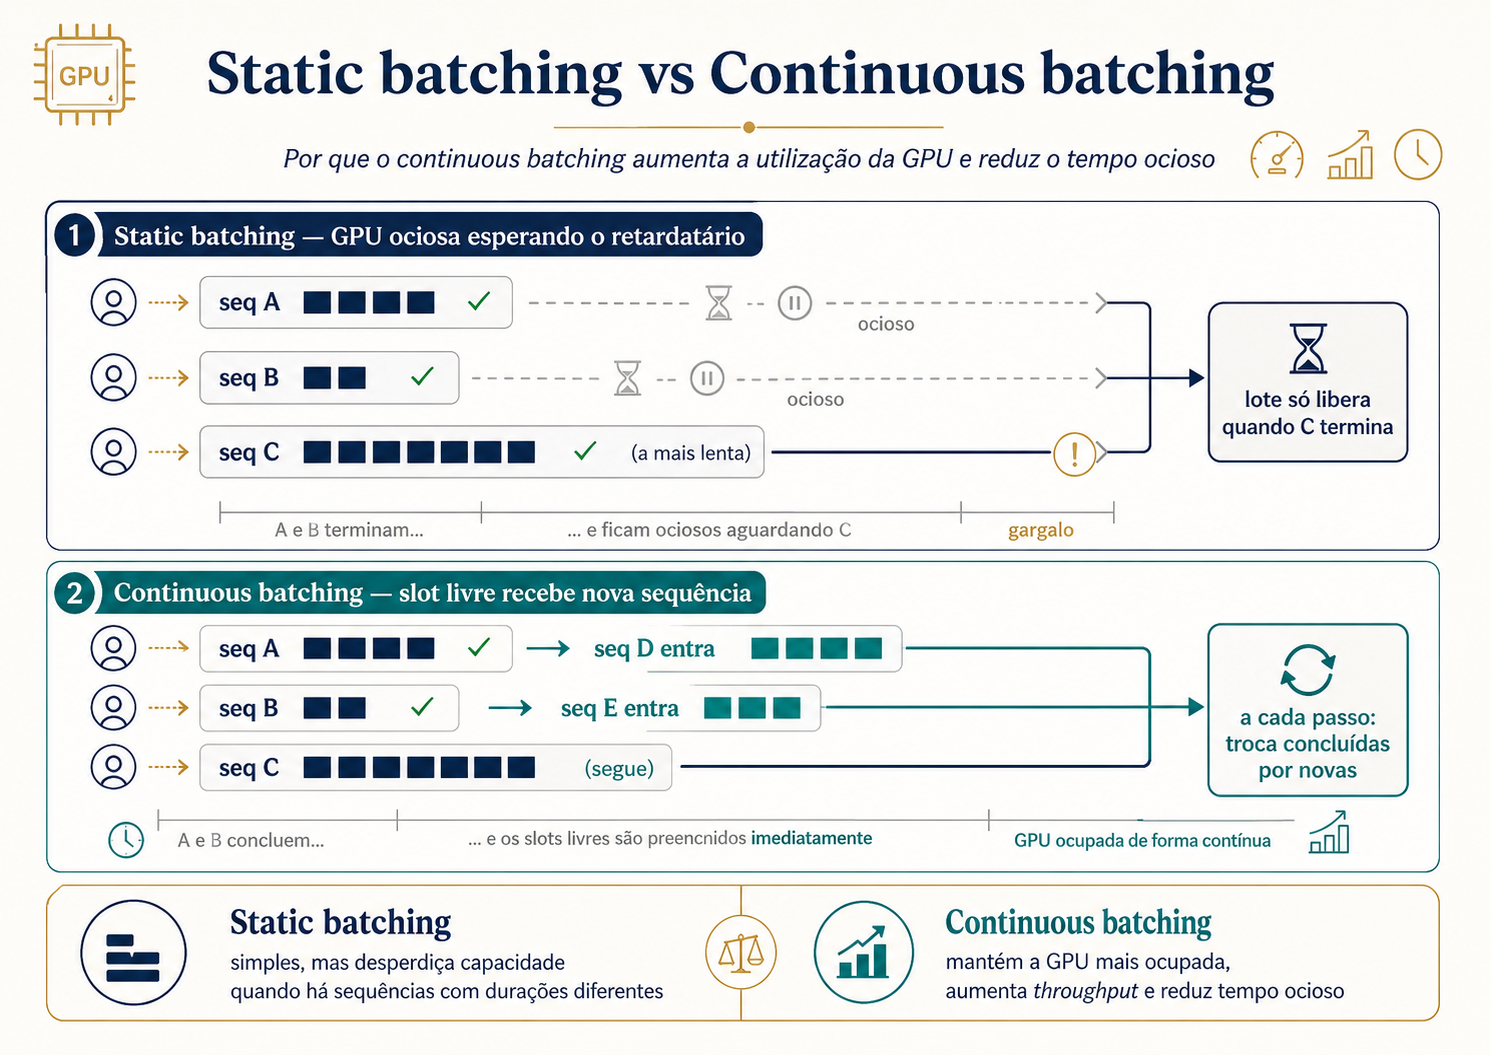
O segundo mecanismo é o continuous batching. Em um lote estático, novas requisições só entram quando todas as sequências do grupo terminam. Como cada resposta pode ter um comprimento diferente, a GPU acaba aguardando as sequências mais lentas enquanto parte da capacidade permanece ociosa. Ele opera no nível de cada etapa de geração: a cada iteração, sequências concluídas deixam o lote e são substituídas por novas requisições, mantendo a GPU ocupada e aproveitando melhor a capacidade disponível.
 Ampliar ↗
Na avaliação original, o conjunto de otimizações do vLLM elevou o throughput entre duas e quatro vezes em comparação com sistemas de inferência então considerados estado da arte, mantendo latência semelhante. O mesmo hardware consegue servir mais tráfego e, pela equação de throughput, o custo médio por token diminui na mesma direção. O ganho real, porém, depende do modelo, do tamanho dos prompts e das respostas, da concorrência e da meta de latência.
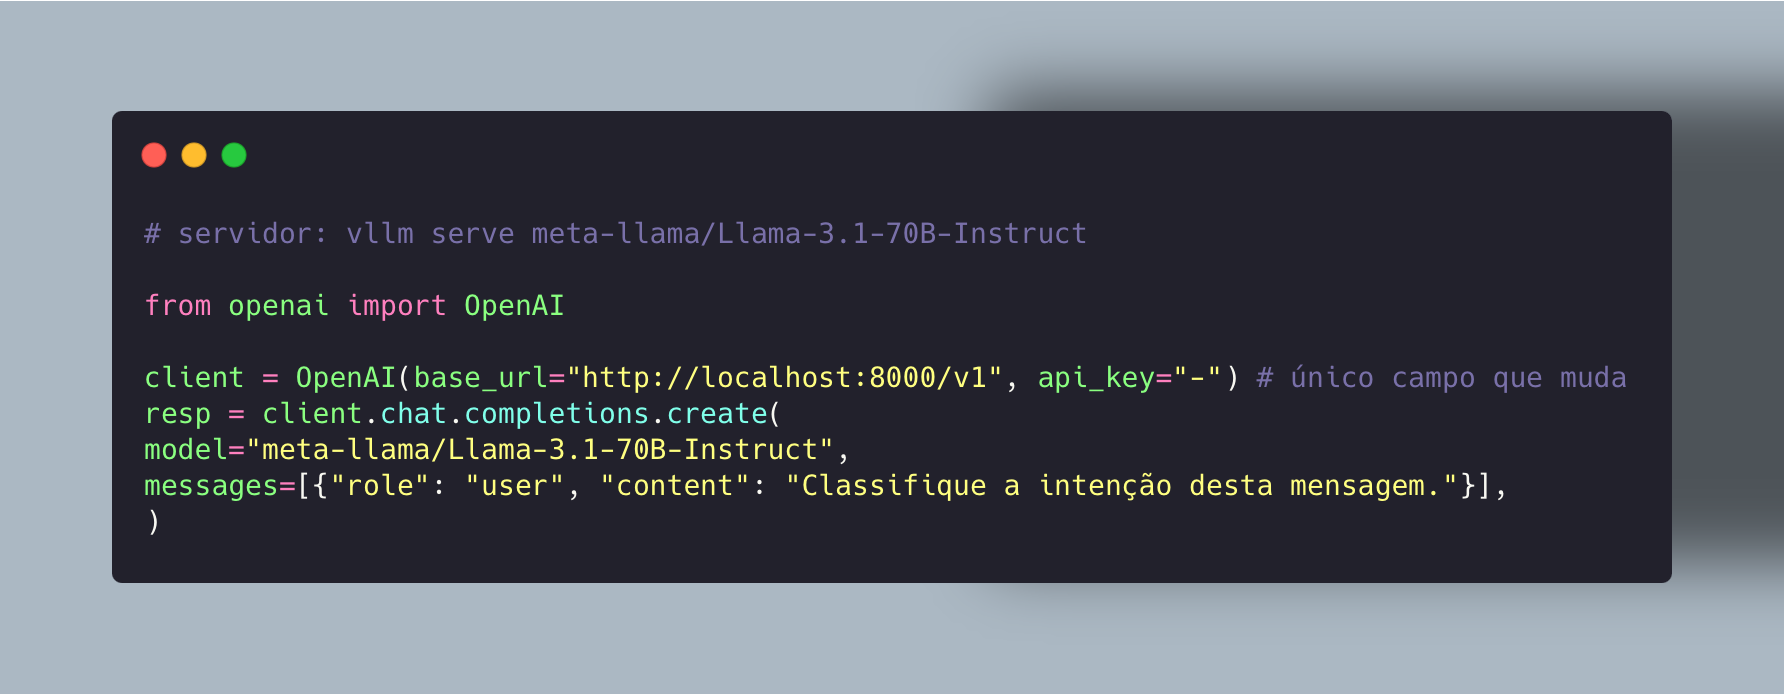
O vLLM também reduz o atrito da adoção de modelos opensource self hosted. Ele disponibiliza um servidor com APIs compatíveis com o padrão da OpenAI, distribui modelos grandes entre várias GPUs por meio de tensor parallelism e suporta diferentes técnicas de quantização, como FP8, INT8, AWQ e GPTQ, para reduzir o consumo de memória e ampliar o throughput.
Em uma integração simples, o mesmo cliente utilizado para acessar a API da OpenAI pode ser apontado para um servidor local:
 Ampliar ↗
O vLLM não está sozinho. O NVIDIA TensorRT-LLM é uma alternativa orientada à extração de desempenho em GPUs NVIDIA, com ampla capacidade de otimização, mas maior dependência do ecossistema e do hardware do fabricante. O SGLang se destaca em cargas com prefixos ou contextos compartilhados entre requisições: sua RadixAttention identifica trechos comuns e reutiliza o KV cache correspondente, evitando processamento repetido.O Hugging Face TGI, que durante anos foi uma opção natural nessa comparação, entrou em modo de manutenção em março de 2026. A própria Hugging Face passou a recomendar, para novas implementações, motores como vLLM, SGLang, llama.cpp e MLX.
Do ponto de vista econômico, a consequência é direta: o servidor de inferência deixa de ser um detalhe de implementação. Ele passa a determinar quantos tokens cada GPU consegue entregar dentro da meta de latência e, portanto, se uma arquitetura self hosted fecha ou não a conta.
O trade-off é multidimensional#
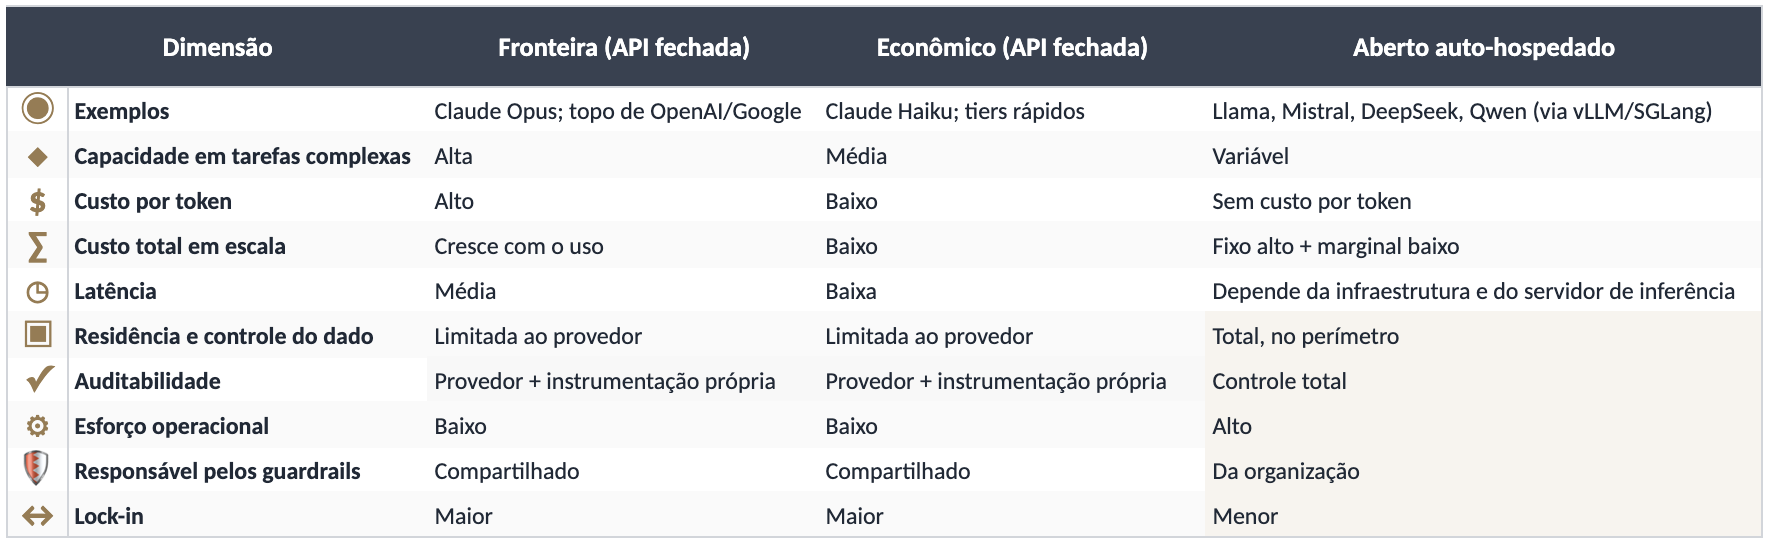
Comparar alternativas apenas pelo preço por token é o erro que produz tanto a fatura inesperada quanto a migração precipitada para infraestrutura própria. A decisão envolve múltiplas dimensões e, quando há dados sensíveis, requisitos regulatórios ou necessidade de auditoria, várias delas pesam mais do que o custo unitário.
As avaliações da tabela são qualitativas. O peso de cada dimensão varia conforme a carga de trabalho, o volume, a criticidade e os requisitos de conformidade.
 Ampliar ↗
Nenhuma alternativa vence em todos os eixos. Os modelos de fronteira oferecem maior capacidade para tarefas complexas e exigem pouco esforço operacional, mas apresentam custo unitário mais alto e menor controle direto sobre o ambiente de processamento. Os modelos econômicos equilibram custo, velocidade e simplicidade, embora possam não sustentar tarefas que exigem raciocínio mais profundo ou maior confiabilidade. Os modelos opensource self-hosted oferecem maior controle sobre dados, infraestrutura e operação. Em contrapartida, transferem integralmente para a organização a responsabilidade por capacidade, disponibilidade, segurança, guardrails, observabilidade e evolução da plataforma.
A arquitetura adequada raramente se limita a uma dessas opções. Ela combina diferentes camadas e atribui cada carga de trabalho ao modelo mais econômico que ainda satisfaça seus requisitos de capacidade, qualidade, latência, segurança e conformidade.
Onde o custo vira decisão de risco#
É aqui que a conversa muda de departamento. A escolha do modelo, do local de execução e da camada de roteamento determina três coisas ao mesmo tempo: por onde os dados trafegam, quais evidências permanecem disponíveis para auditoria e quem assume a responsabilidade pelos guardrails. Em setores regulados, como serviços financeiros, saúde, setor público e jurídico, essas variáveis são matéria de governança, segurança e risco operacional antes de serem matéria de finanças. O que em um e-commerce pode ser apenas boa prática, nesses ambientes pode se tornar um controle necessário, conforme a criticidade do processo e a sensibilidade dos dados envolvidos.
Comece pelo fluxo do dado, não apenas pelo rótulo self hosted. Uma inferência self hosted pode manter os dados dentro do perímetro da organização, mas isso só acontece quando toda a cadeia permanece sob seu controle: servidor de inferência, embeddings, logs, telemetria, guardrails, armazenamento e demais integrações. Se qualquer uma dessas camadas enviar informações a um serviço externo, parte do fluxo continua fora do perímetro. A LGPD [11] não determina que modelos sejam executados localmente nem proíbe o uso de nuvem, ela exige que o tratamento tenha fundamento jurídico e que sejam adotadas medidas técnicas e administrativas adequadas para proteger os dados pessoais. No setor financeiro, a Resolução CMN nº 4.893/2021, com as alterações da Resolução CMN nº 5.274/2025 [12], estabelece requisitos de segurança cibernética e de governança para a contratação de serviços de processamento, armazenamento de dados e computação em nuvem. Nenhuma dessas normas menciona expressamente a inferência de IA ou determina a adoção de modelos self hosted. Manter determinados dados e cargas de trabalho dentro do perímetro é uma decisão arquitetural que pode reduzir exposição a terceiros e facilitar o atendimento a requisitos de segurança, controle e auditabilidade, não uma ordem literal do regulador.
Há, porém, um ponto de convergência que o mercado ainda subutiliza: a mesma camada de roteamento que decide qual modelo recebe cada tarefa pode funcionar como ponto central de aplicação de políticas. Quando combinada a um gateway ou endpoint unificado de inferência, toda requisição passa por uma camada na qual é possível autenticar o usuário, classificar o dado, mascarar informações pessoais, aplicar regras de acesso, selecionar o modelo e registrar o caminho percorrido. Essa trilha não surge automaticamente. Ela precisa ser projetada: logs estruturados, correlação entre requisições, versionamento das políticas, registro do modelo selecionado, justificativa da decisão, métricas e retenção adequada das evidências. Sem essa instrumentação, centralizar o tráfego cria apenas um gargalo; com ela, cria-se um ponto verificável de controle.
Não é coincidência que o roteamento semântico esteja se aproximando do próprio ecossistema de inferência. O vLLM Semantic Router já combina seleção de modelos, detecção de PII, proteção contra prompts maliciosos, cache semântico, métricas e tracing. O componente criado para otimizar custo e desempenho começa também a assumir funções de segurança, observabilidade e governança. O mesmo princípio sustenta o guardrail de saída que descrevi em “Guardrails regulatórios em assistente de investimentos”: estabelecer pontos explícitos nos quais a política possa intervir. Naquele caso, o controle está na saída, no critique_node que avalia a resposta antes que ela chegue ao cliente. Aqui, está na entrada, no roteamento e no gateway de inferência.
São pontos diferentes do mesmo pipeline, guiados pela mesma lógica: decisões relevantes não podem ficar dispersas, implícitas ou impossíveis de reconstruir. Precisam ser centralizadas quando necessário, versionadas, testadas e registradas.
Sob esse enquadramento, otimização de custo deixa de ser apenas corte de despesa. Torna-se capacidade de governança: saber qual modelo processou cada requisição, com qual política, sobre quais dados e sob a responsabilidade de quem. O regulador não exige vLLM nem roteamento semântico, mas espera que a organização consiga demonstrar seus controles, suas decisões e a gestão dos riscos envolvidos.
Como decidir#
A pergunta operacional não deveria ser quanto a organização pode gastar, mas onde cada carga de trabalho deve ser executada. Alguns critérios resolvem a maior parte dos casos: qual é a sensibilidade do dado e se ele pode deixar o perímetro; qual é a complexidade real da tarefa e se ela exige um modelo de fronteira ou está bem especificada; qual é o volume e se ele é estável ou irregular; qual é a tolerância à latência; e qual é o nível de auditabilidade exigido. As respostas a essas perguntas apontam, quase naturalmente, para uma camada de modelo e um modo de hospedagem.
O resultado desse exercício não é usar menos IA. É construir um portfólio no qual cada fluxo seja executado pela opção mais econômica que ainda atenda aos requisitos de capacidade, qualidade, latência, segurança e conformidade.
Uma organização que faz isso não precisa começar por um teto de gastos por funcionário. O limite de custo torna-se consequência de uma arquitetura que já sabe o que vale a pena executar, em qual modelo e em qual ambiente, não uma premissa imposta de cima para baixo.
O que separa racionar de arquitetar
A reportagem que abre este texto descreve uma política de restrição. Ela contém o prejuízo, mas também limita o ganho. As organizações que vão liderar a próxima fase não tratarão a IA como um recurso a ser racionado. Vão arquitetá-la, transformando uma fatura opaca em um portfólio governado, mensurável e capaz de se sustentar sob auditoria.
O tempo joga contra quem escolhe apenas restringir. Segundo o relatório Decoding the Agentic Economy, do Goldman Sachs, conforme noticiado, o consumo global de tokens pode crescer 24 vezes até 2030, impulsionado pelo avanço dos agentes. Diante de uma expansão dessa magnitude, por quanto tempo um teto por funcionário consegue conter a conta sem também conter a adoção?
Racionar limita o sintoma. Arquitetar enfrenta a causa.
Este artigo apresenta uma análise técnica e arquitetural e não constitui parecer ou aconselhamento jurídico, regulatório ou de compliance. A interpretação e a aplicação da LGPD, da regulação do Banco Central e dos demais marcos aplicáveis a cada setor devem ser conduzidas em conjunto com as áreas jurídica, de compliance, de privacidade e de segurança da informação da organização.
Fontes
InfoMoney - “A conta chegou: por que as empresas de tecnologia agora freiam o uso de IA”, https://www.infomoney.com.br/business/global/a-conta-chegou-por-que-as-empresas-de-tecnologia-agora-freiam-uso-de-ia/
Goldman Sachs - “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars”, https://www.goldmansachs.com/insights/articles/ai-agents-forecast-to-boost-tech-cash-flow-as-usage-soars
Anthropic - Claude pricing, https://platform.claude.com/docs/en/about-claude/pricing
Dynamic Model Routing and Cascading: A Survey, https://arxiv.org/html/2603.04445v2
vLLM Semantic Router, https://vllm-semantic-router.com/
RouteLLM: Learning to Route LLMs with Preference Data - LMSYS. https://arxiv.org/abs/2406.18665
OpenRouter - State of AI. https://openrouter.ai/state-of-ai
TokenMix - Self-Host LLM vs. API: Break-Even Analysis (2026), https://tokenmix.ai/blog/self-host-llm-vs-api
Kwon et al. - Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023, https://arxiv.org/abs/2309.06180
Runpod - vLLM PagedAttention and Continuous Batching, https://www.runpod.io/articles/guides/vllm-pagedattention-continuous-batching
Lei nº 13.709/2018 - Lei Geral de Proteção de Dados Pessoais https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/L13709compilado.htm
Banco Central do Brasil - Resolução CMN nº 4.893, de 26 de fevereiro de 2021 https://www.bcb.gov.br/estabilidadefinanceira/exibenormativo?numero=4893&tipo=Resolu%C3%A7%C3%A3o+CMN
Banco Central do Brasil - Resolução CMN nº 5.274, de 18 de dezembro de 2025, https://www.bcb.gov.br/estabilidadefinanceira/exibenormativo?numero=5274&tipo=Resolu%C3%A7%C3%A3o+CMN
vLLM - documentação oficial, https://docs.vllm.ai/
Hugging Face - Text Generation Inference, https://github.com/huggingface/text-generation-inference
Artigos citados#
“Três routers, três problemas diferentes: DSPy, Semantic Router e RouteLLM” https://www.linkedin.com/pulse/tr%25C3%25AAs-routers-problemas-diferentes-dspy-semantic-router-bruno-vicco-dbi7f/
“Guardrails regulatórios em assistentes de investimentos: CVM, Anbima e IA” https://www.linkedin.com/pulse/guardrails-regulat%25C3%25B3rios-em-assistentes-de-cvm-anbima-e-bruno-vicco-rksff/