A ideia deste estudo surgiu enquanto eu fazia uma trilha da Anthropic, onde uma parte do conteúdo trata da escolha entre augmented LLMs, workflows e agents considerando dois aspectos que parecem simples, mas têm consequências importantes em produção: a previsibilidade do caminho de execução e o grau de autonomia entregue ao modelo.
Isso me levou a uma pergunta mais específica: o que muda quando a decisão sobre o próximo passo deixa de estar inteiramente no código da aplicação e passa, em alguma medida, para o modelo? Resolvi explorar essa questão construindo o Controlled Autonomy Lab, uma implementação que executa a mesma tarefa de análise de incidente de produção usando seis arquiteturas diferentes.
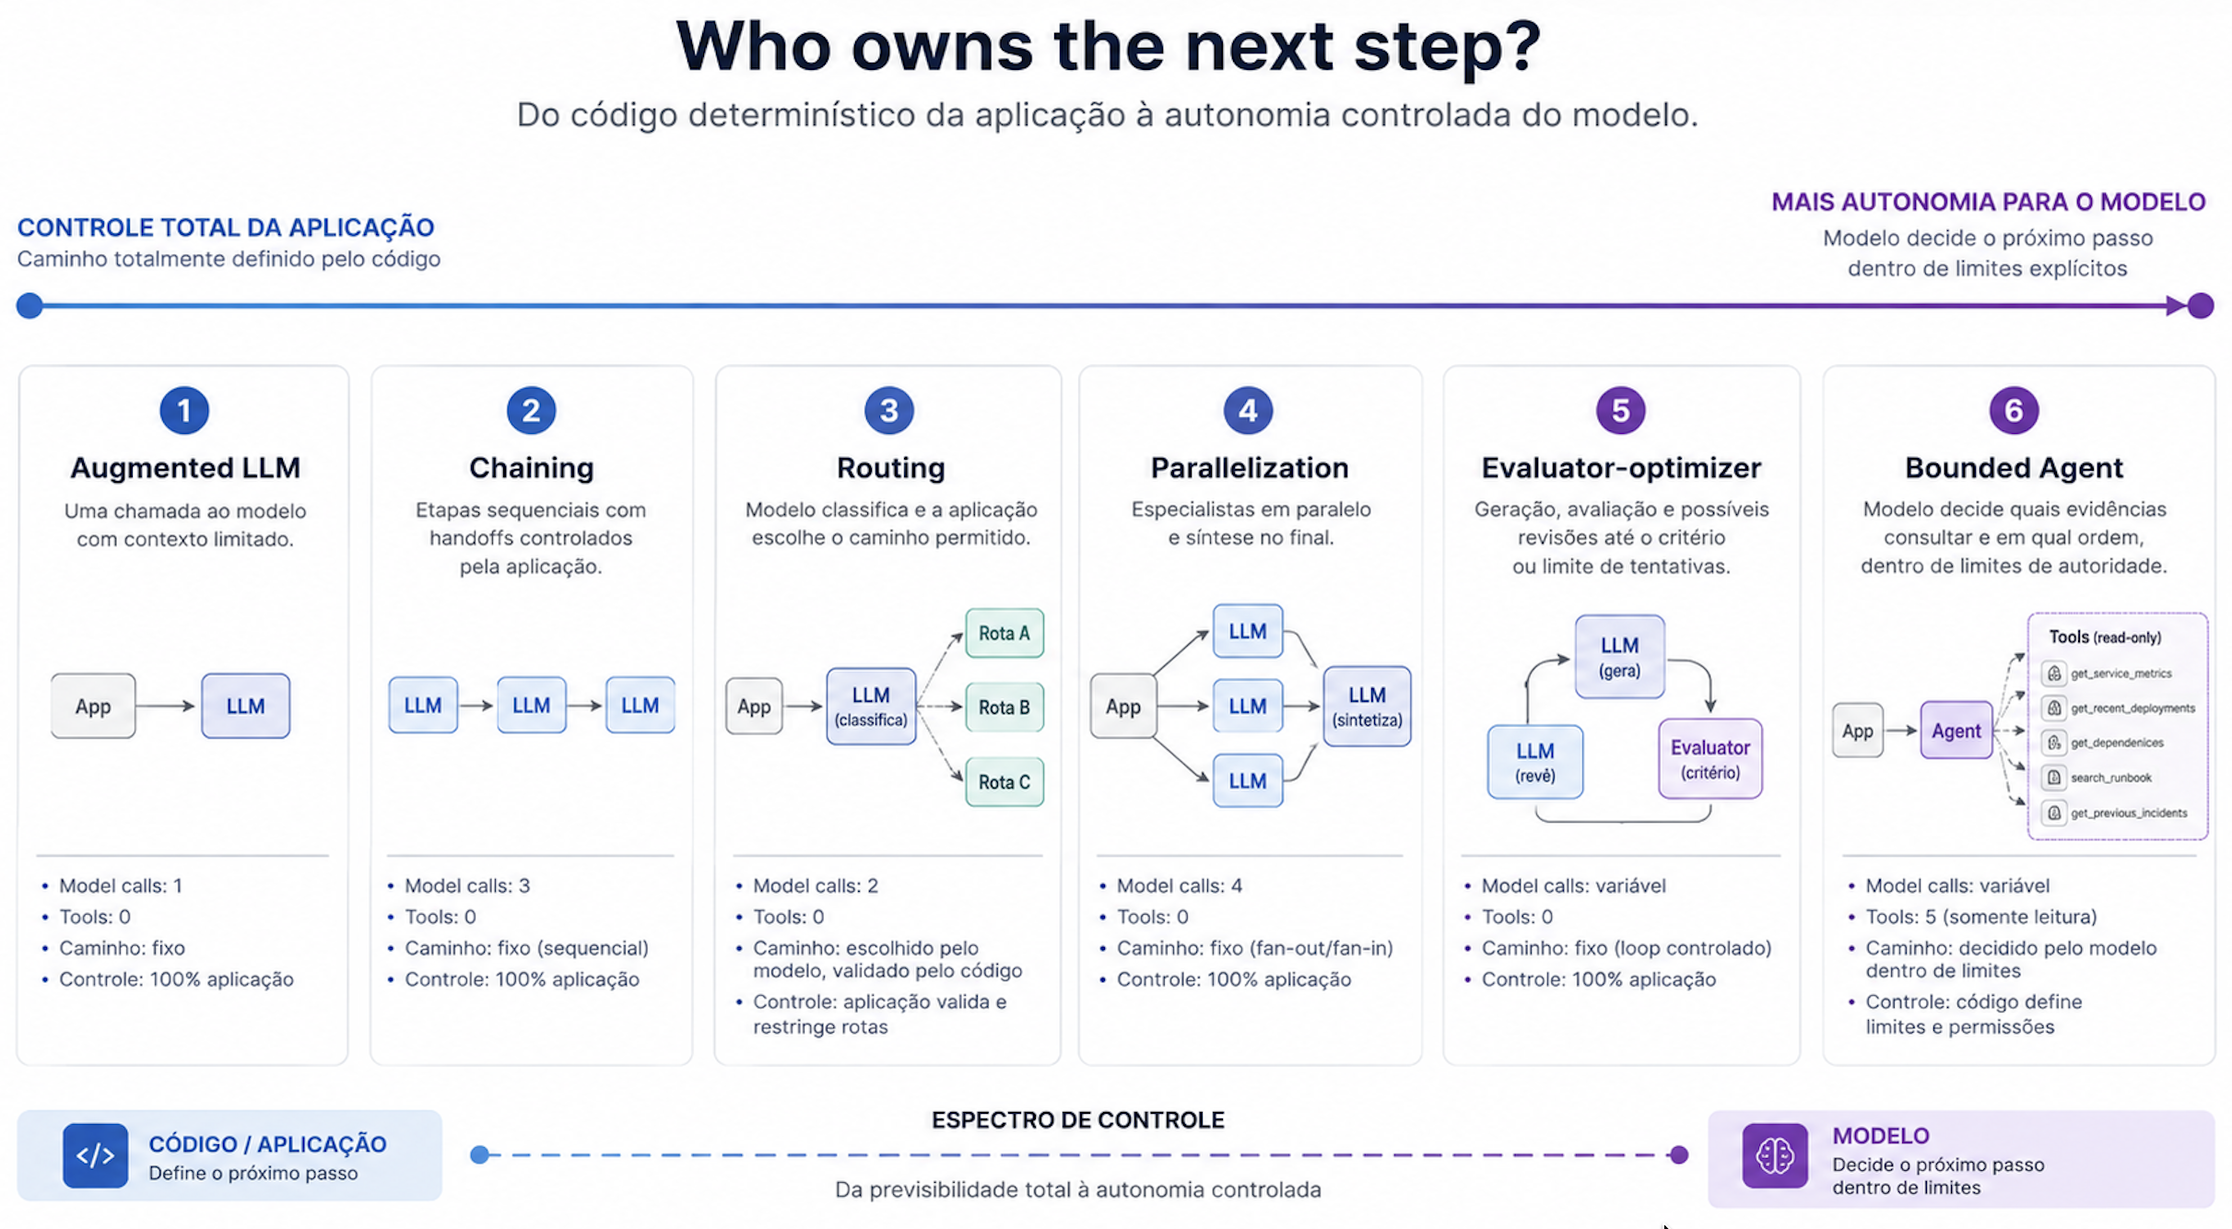
Ao longo do projeto, a pergunta acabou se consolidando em uma frase: Quem determina os próximos passos: código determinístico ou o modelo?
O laboratório compara comportamento, grounding, trajetória de execução, uso de ferramentas, latência, tokens e autoridade causal em diferentes combinações de OpenAI, Anthropic e Groq. Até agora, o registro experimental reúne 234 células distribuídas em três gerações separadas e congeladas.
 Ampliar ↗
Os seis padrões#
Todos os padrões recebem a mesma tarefa: analisar um incidente a partir de um conjunto controlado de evidências. O que muda é a forma como o trabalho é decomposto e quem controla a trajetória da execução.
 Ampliar ↗
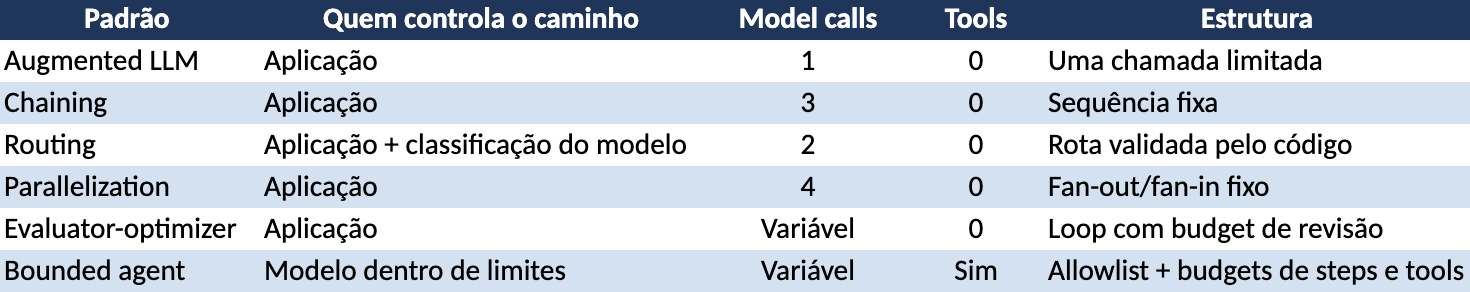
O augmented LLM concentra todo o trabalho em uma chamada.
No chaining, três chamadas executam etapas sequenciais: extração de fatos, avaliação de severidade e recomendação de ações.
O routing usa o modelo para classificar o incidente e selecionar um caminho, mas o código converte o resultado para uma enum conhecida e rejeita rotas fora do conjunto permitido.
Na parallelization, três especialistas analisam métricas, mudanças recentes e dependências simultaneamente. Depois, uma quarta chamada de modelo sintetiza os resultados. O conteúdo da síntese continua probabilístico; a topologia de fan-out e fan-in é definida pelo código.
O evaluator-optimizer trabalha com geração, avaliação e possíveis revisões até atingir um critério de qualidade ou esgotar um limite de tentativas.
Já o bounded agent recebe cinco ferramentas somente leitura e pode decidir quais delas consultar e em que ordem:
get_service_metrics,get_recent_deployments,get_dependencies,search_runbookeget_previous_incidents.
Essa autonomia possui limites explícitos: o código permite no máximo 6 steps e 8 tool calls, valida o nome de cada ferramenta contra uma allowlist e restringe o acesso ao incidente ativo. Não existem ferramentas para shell, restart, rollback, alteração de configuração ou escrita em produção. Se o agente ultrapassa o budget, a execução é interrompida e o estado parcial é preservado como evidência do benchmark.
Por que implementei sem frameworks#
O pyproject.toml do projeto declara dependencies = []. Os adapters para Anthropic Messages API, OpenAI Responses API e APIs compatíveis com OpenAI são implementados diretamente sobre a standard library do Python, usando principalmente http.client, json e urllib.parse. Não há LangChain, LangGraph ou SDK dos providers no runtime.
Essa decisão aumentou o volume de código necessário para serialização, parsing, tratamento de erros e tool calls. Para o objetivo do laboratório porém, essa transparência é útil: consigo acompanhar exatamente o payload enviado para cada provider, como uma chamada de ferramenta é representada e como a resposta volta para o domínio da aplicação.
A estrutura segue Clean Architecture, dividida entre domain, application e adapters. O CI verifica essas fronteiras e bloqueia as violações cobertas pelas regras do projeto. O mesmo quality gate executa Ruff, MyPy strict, testes com cobertura mínima de 80%, Bandit, pip-audit e a validação arquitetural.
Esse nível de controle foi particularmente útil porque uma parte importante do experimento consiste justamente em observar onde termina o comportamento definido pela aplicação e onde começa o comportamento introduzido pelo modelo.
O stack de avaliação#
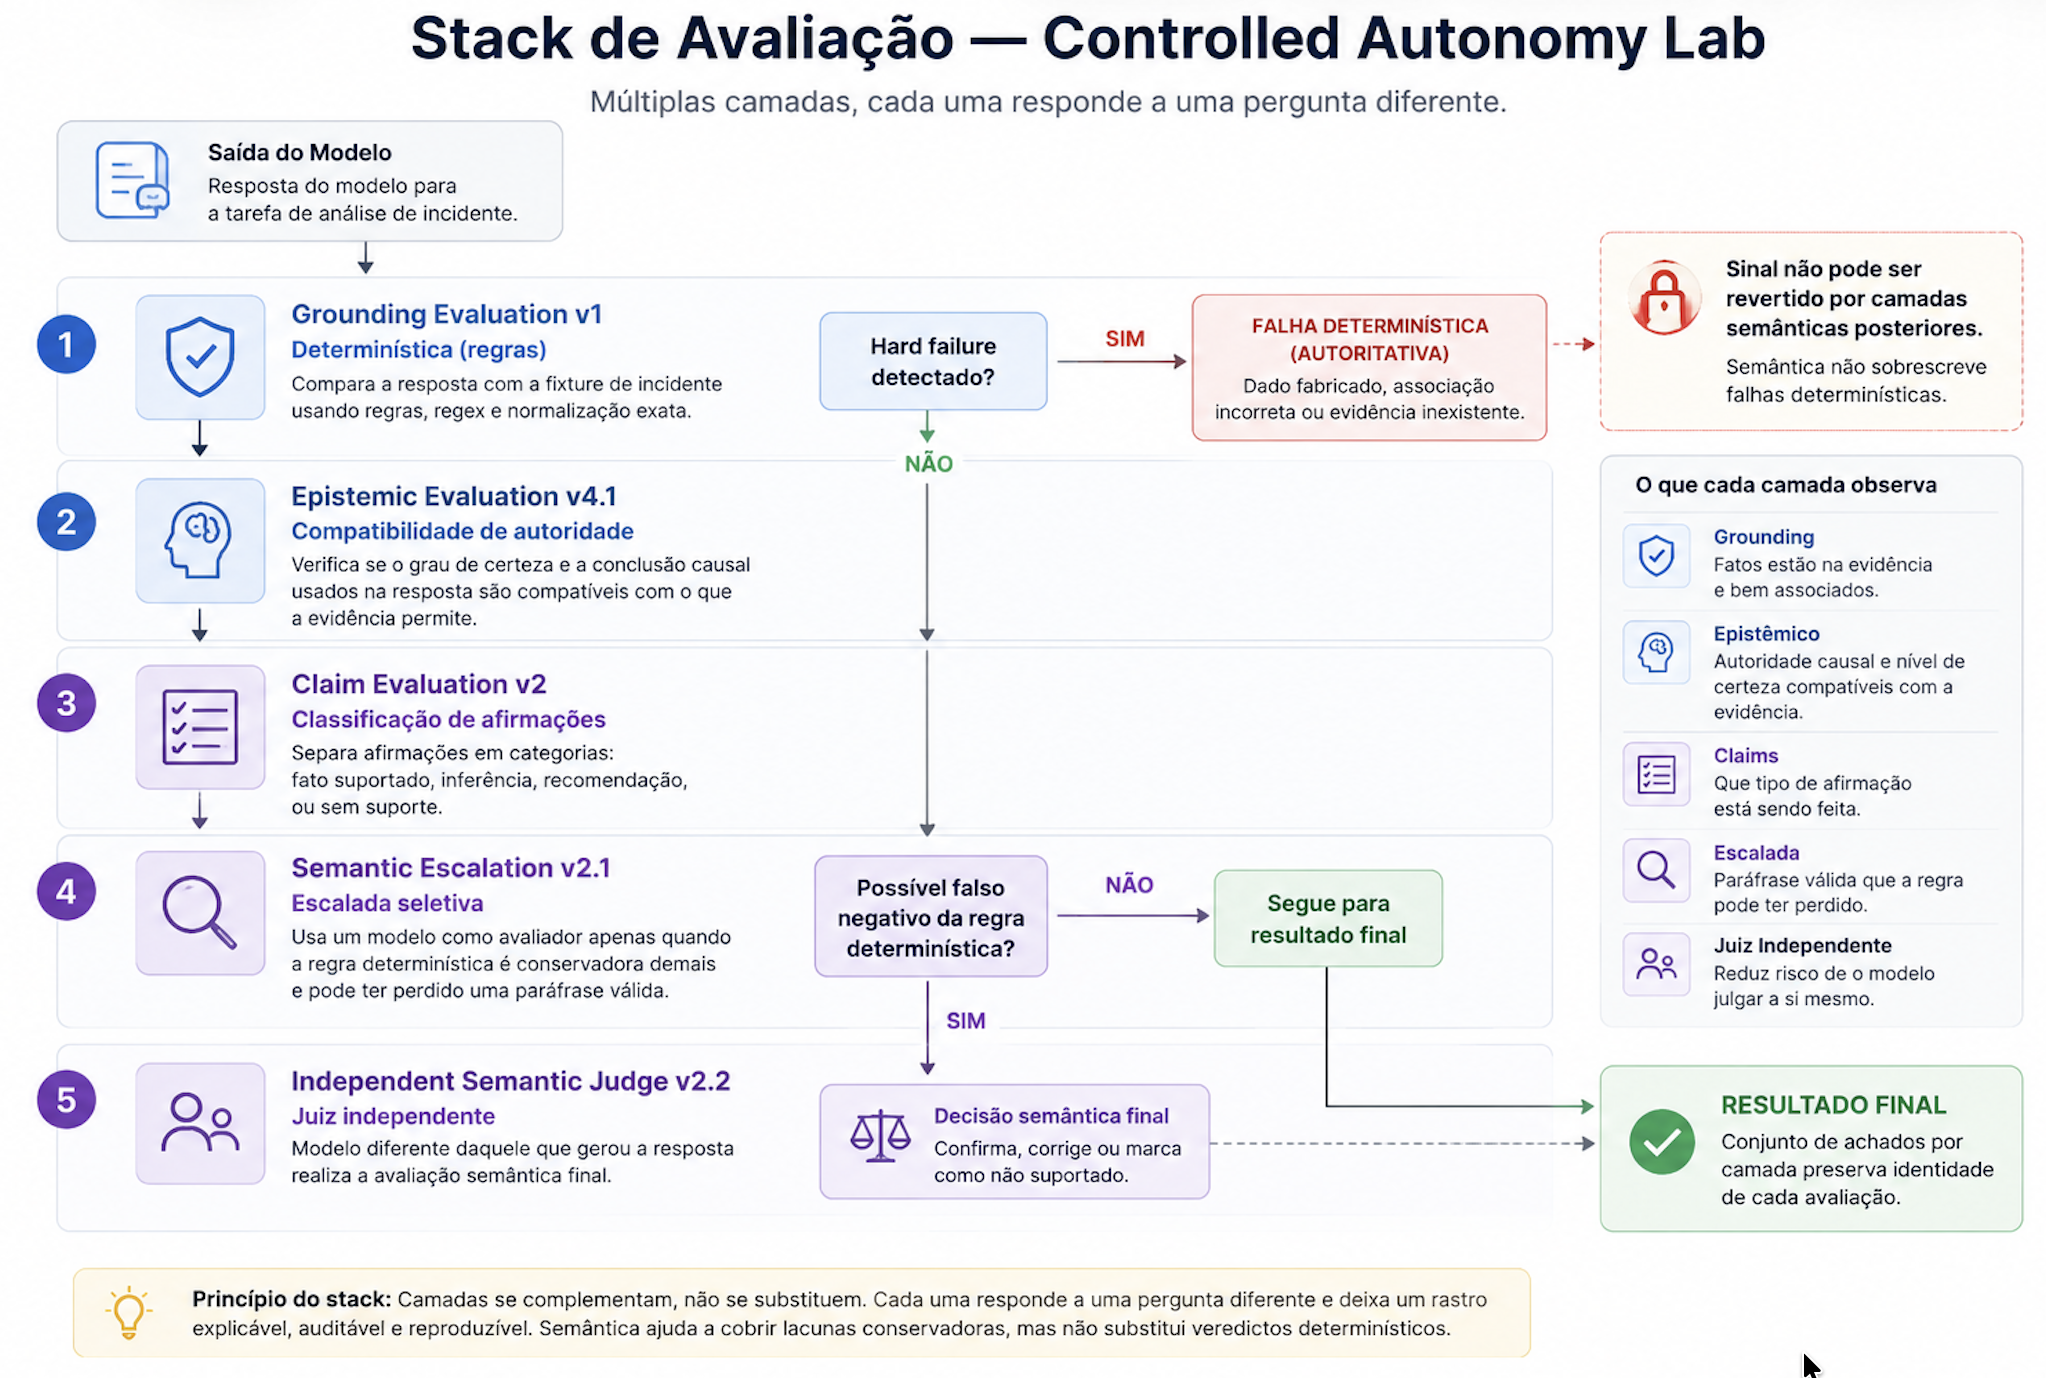
Depois das primeiras execuções ficou evidente que comparar apenas latência, tokens ou uma métrica genérica de qualidade seria insuficiente. O projeto acabou desenvolvendo cinco camadas de avaliação, cada uma respondendo a uma pergunta diferente.
O Grounding Evaluation v1 é determinístico. Ele compara a resposta com o fixture do incidente por regras explícitas, verificando versões, timestamps, medidas, equivalências de unidade, associações entre evidências e linguagem causal forte. Se a resposta mencionar uma versão inexistente ou associar um valor ao contexto errado, por exemplo, isso produz um hard failure. Uma avaliação semântica posterior pode recuperar uma paráfrase legítima que uma regra lexical não reconheceu, mas não recebe autoridade para reverter esses sinais determinísticos.
O Epistemic Evaluation v4.1 surgiu depois de uma limitação observada nos próprios benchmarks. Uma versão anterior usava um indicador de preservação de incerteza. No breadth benchmark, esse campo ficou positivo em todas as 59 células bem-sucedidas, inclusive em respostas que também apresentavam overclaims causais. A métrica havia saturado. A versão seguinte passou a observar a relação entre a postura da evidência e o grau de certeza usado na resposta.
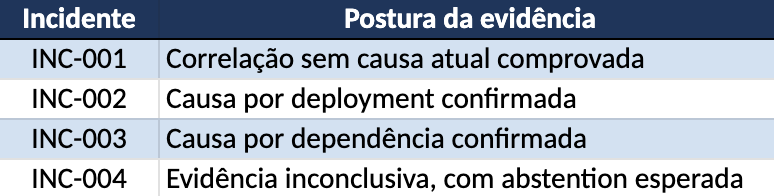
Os quatro incidentes usados pelo laboratório foram desenhados para representar situações diferentes:
 Ampliar ↗
Isso permite tratar de forma diferente frases como “may have caused”. Em um incidente correlacional, essa cautela pode ser apropriada. Em um incidente cuja causa está explicitamente confirmada, a mesma formulação pode representar excesso de hesitação.
As demais camadas completam o processo. Claim Evaluation v2 separa fatos, inferências, ações propostas e afirmações sem suporte. Semantic Escalation v2.1 trata casos em que uma regra determinística conservadora deixou de reconhecer uma paráfrase válida. Independent Semantic Judge v2.2 permite desacoplar o modelo que gerou a resposta daquele que participa da avaliação semântica.
 Ampliar ↗
O que as 234 células experimentais mostraram#
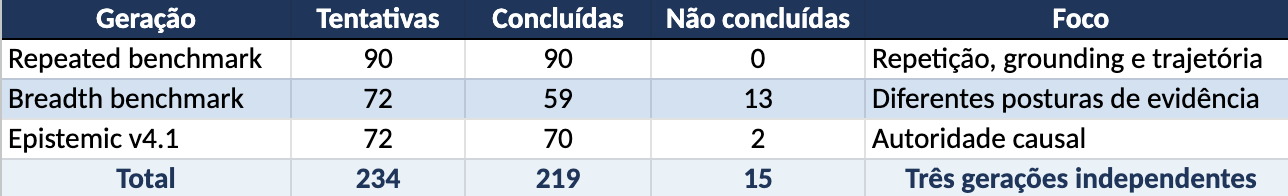
O laboratório mantém três gerações separadas:
 Ampliar ↗
Cada geração possui um commit congelado e evidence packs acompanhados de checksums SHA-256. Rate limits e erros de provider permanecem registrados como dados de disponibilidade; as métricas de qualidade consideram somente as células concluídas com sucesso. Essa separação importa porque uma falha de API diz algo sobre disponibilidade naquele contexto de execução, mas não informa a qualidade de uma resposta que nunca chegou a ser produzida.
O primeiro resultado que me chamou atenção apareceu no repeated benchmark. O chaining, com três chamadas sequenciais, apresentou o menor grounding específico nos três provider bundles: 90,0% no OpenAI, 67,4% no Groq e 82,1% no Anthropic. O augmented LLM, usando apenas uma chamada, chegou a 100,0%, 88,3% e 95,3%, respectivamente.
A quantidade de chamadas, portanto, não mostrou uma relação monotônica com grounding. Uma hipótese plausível é que os handoffs sequenciais criem novos pontos em que inferências sem suporte podem aparecer e depois ser propagadas. O benchmark não foi desenhado para provar esse mecanismo, então prefiro tratá-lo como uma hipótese para novos experimentos.
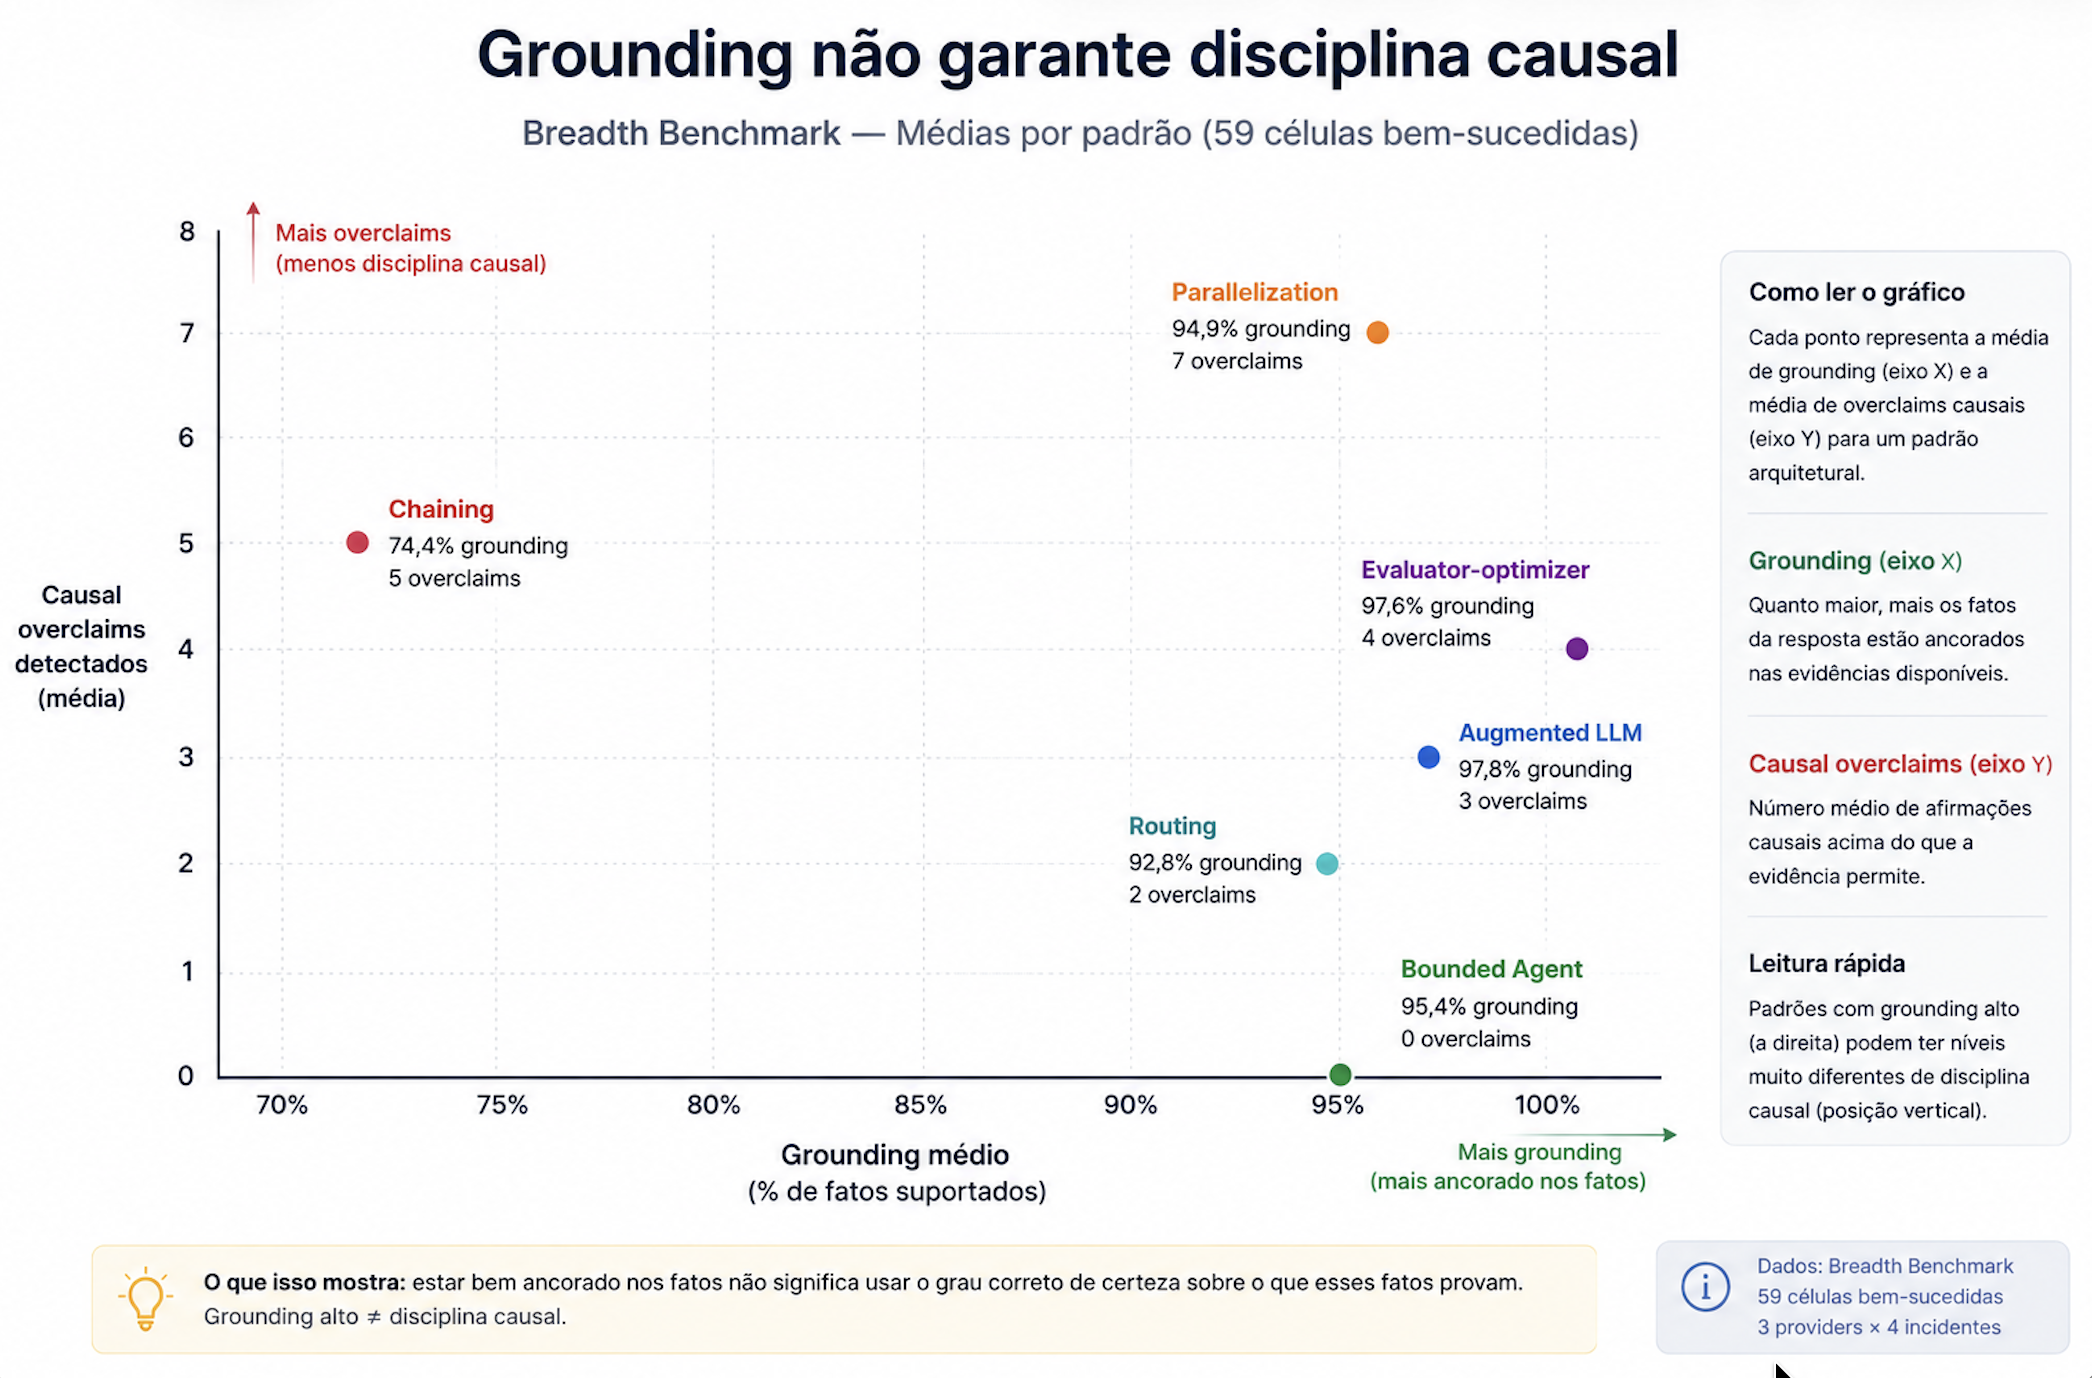
O breadth benchmark trouxe outro tipo de problema. Algumas células alcançaram 100% de grounding específico e, ao mesmo tempo, produziram overclaims causais. Isso pode acontecer quando uma resposta usa corretamente todas as evidências disponíveis, mas transforma uma correlação temporal em uma afirmação causal mais forte do que os dados permitem.
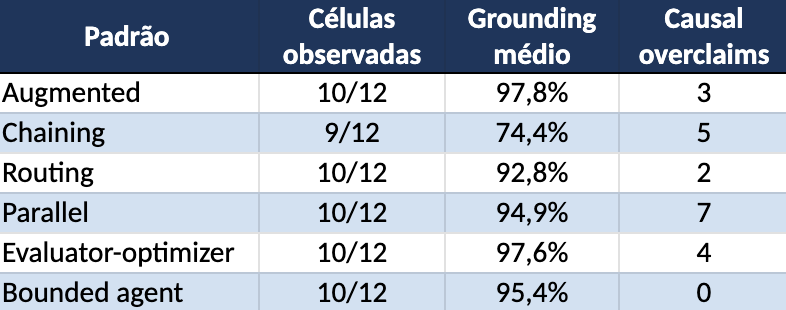
A distinção ficou bastante concreta nos resultados:
 Ampliar ↗
O parallel é um exemplo interessante: manteve grounding alto, 94,9%, ao mesmo tempo em que concentrou sete overclaims nas dez células observadas. O fan-out ampliou a análise disponível para a etapa de síntese, mas a síntese ainda precisou decidir quanto de autoridade causal atribuir àquelas evidências.
No outro extremo, o bounded agent terminou as dez células observáveis do breadth com 95,4% de grounding médio e nenhum overclaim causal detectado. Augmented e evaluator-optimizer tiveram grounding ligeiramente maior, porém registraram três e quatro overclaims.
Esse resultado motivou novas perguntas sobre a relação entre busca dinâmica de evidência e contenção causal. Como o agent pode consultar novas informações antes de concluir, ele possui uma forma de aquisição de evidência que os workflows fixos do experimento não possuem. Ainda assim, dez células são insuficientes para atribuir o resultado ao mecanismo arquitetural com confiança.
 Ampliar ↗
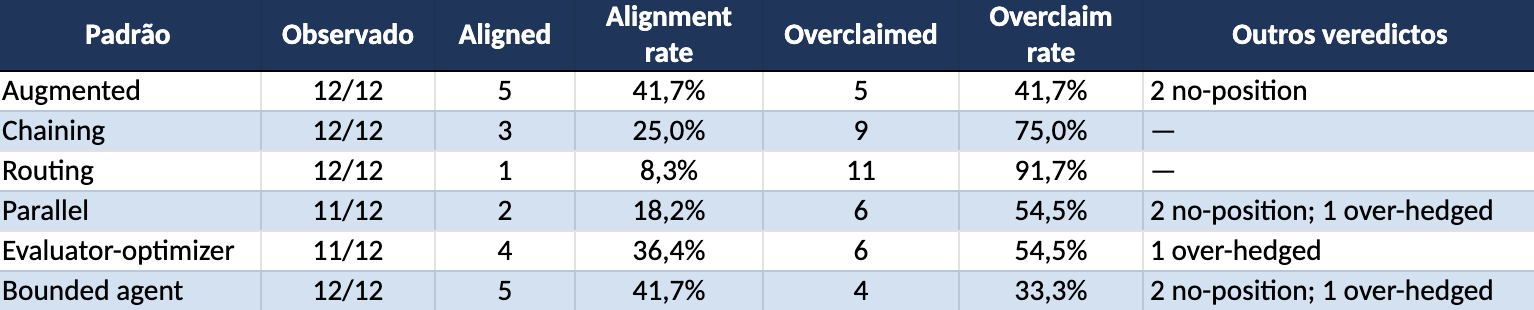
A geração Epistemic v4.1 ajudou a testar esse sinal com uma avaliação mais específica de postura. Foram 72 tentativas e 70 concluídas. Entre elas, o evaluator classificou 20 como aligned, 41 como overclaimed, 6 como no-position e 3 como over-hedged. Os incidentes que exigiam maior contenção foram responsáveis pela maior parte dos overclaims: INC-001, com evidência correlacional, e INC-004, inconclusivo, somaram 29 dos 41 casos detectados.
No nível de arquitetura, o bounded agent apresentou 4 overclaims em 12 células. Entre os padrões completamente observados, foi a menor taxa da geração, 33,3%. O augmented ficou em 5/12, chaining em 9/12 e routing em 11/12. O routing foi particularmente útil para enxergar a diferença entre factualidade e postura. Na geração Epistemic v4.1, ele manteve grounding médio de 95,1% e teve 11 das 12 respostas classificadas como overclaimed.
 Ampliar ↗
Esses números também ajudam a colocar o resultado anterior do agent em perspectiva. O zero observado no breadth não se repetiu na geração seguinte. O sinal de contenção continuou aparecendo de forma relativa, mas já com quatro casos detectados pelo evaluator. É exatamente esse tipo de variação que torna importante preservar gerações históricas em vez de escolher apenas o experimento que produz o resultado mais atraente.
Quando o modelo passa a fazer parte do control plane#
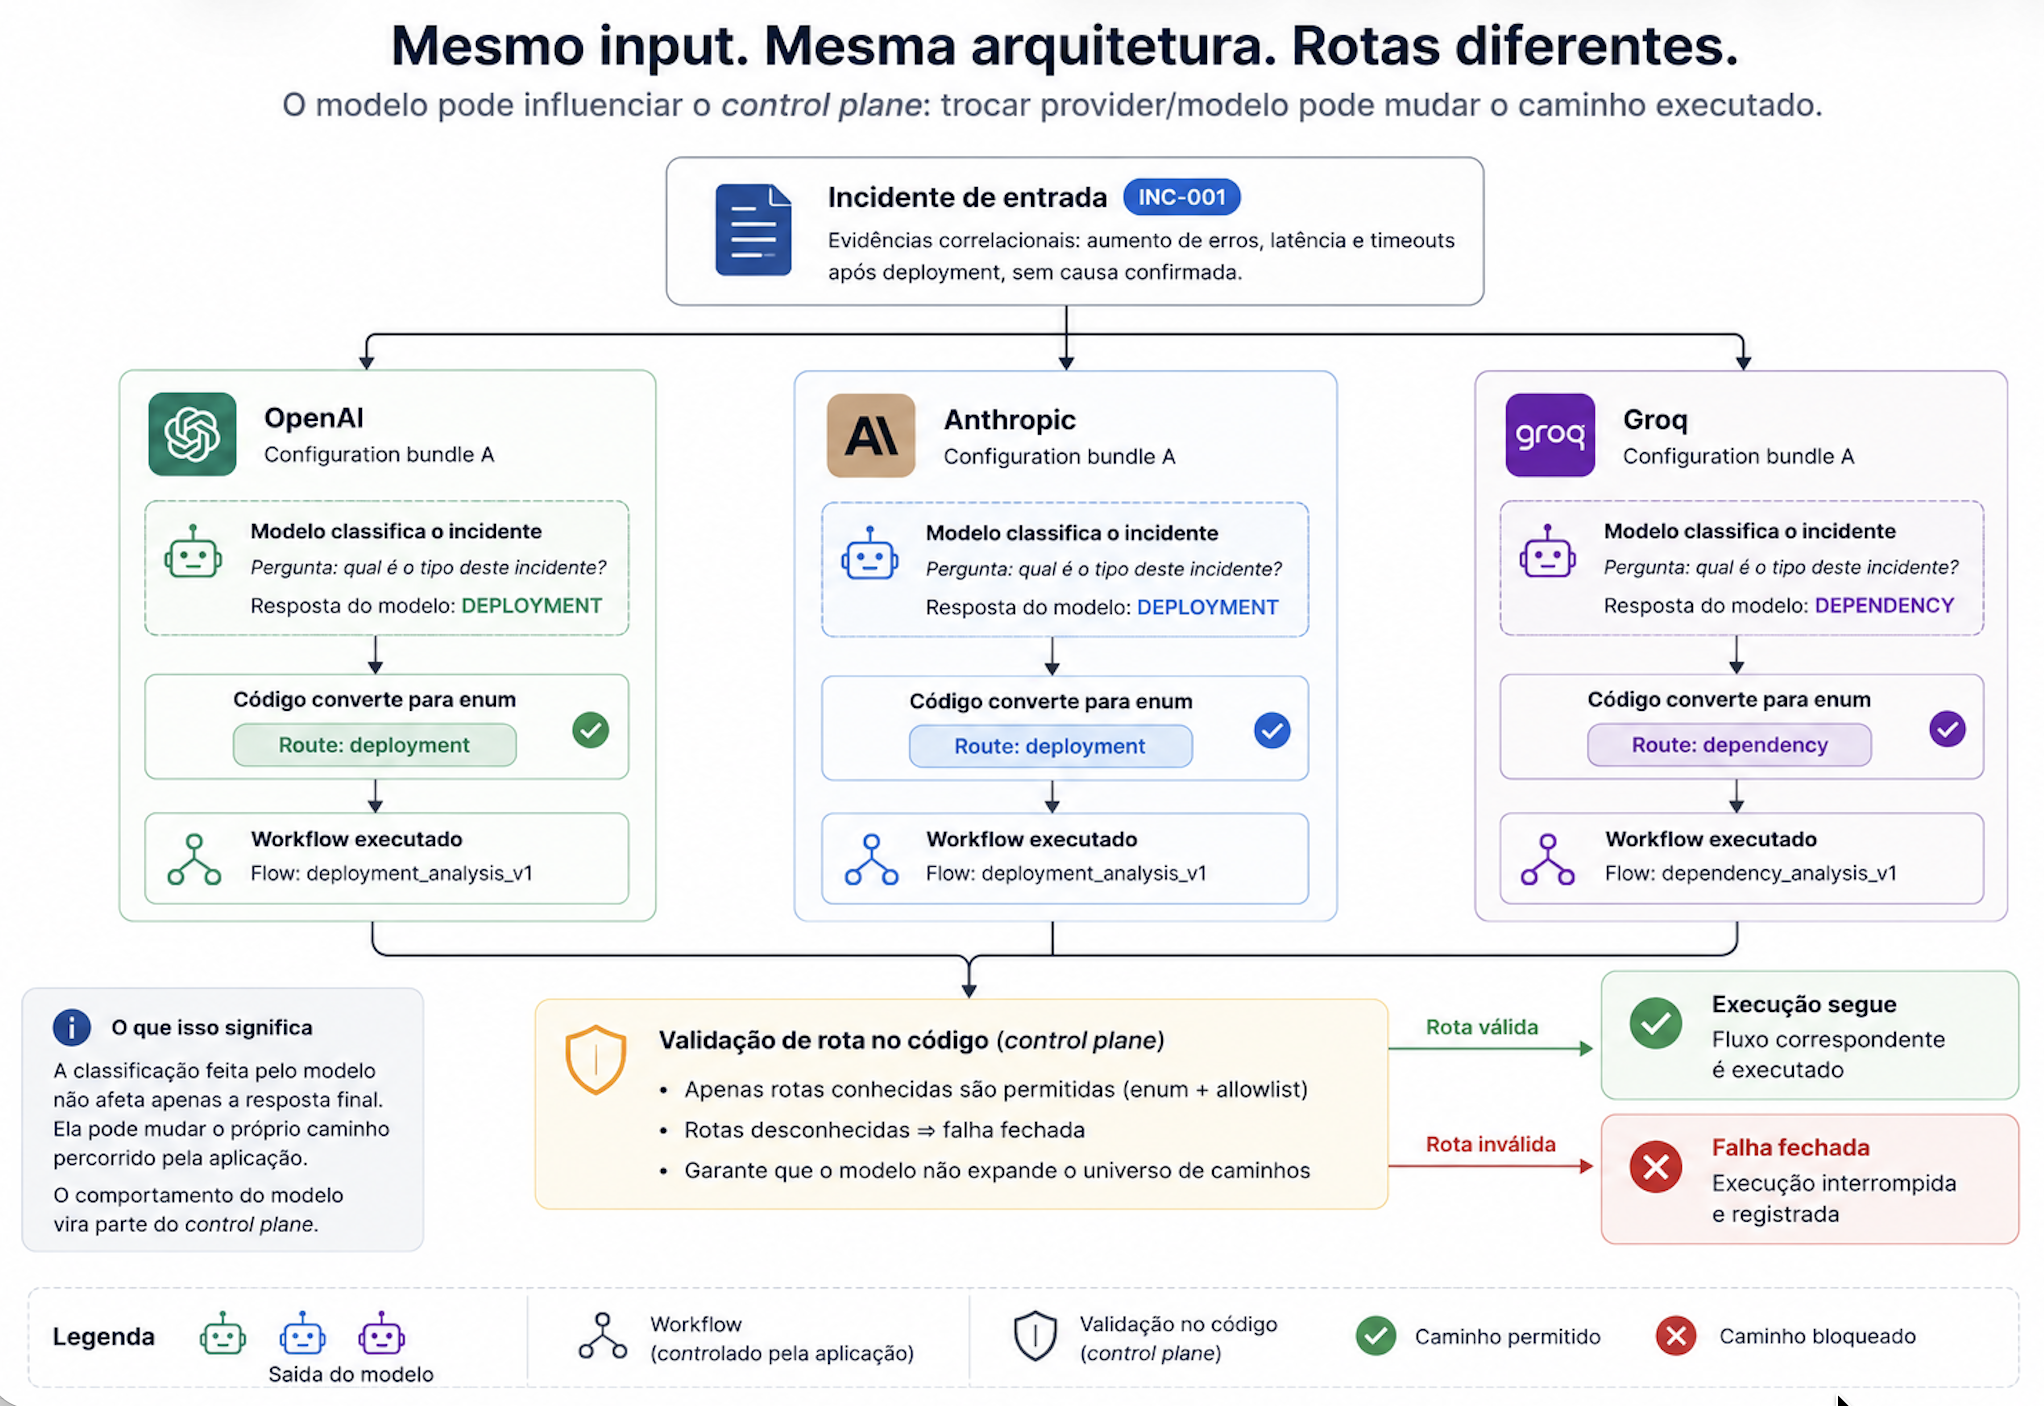
O routing trouxe um achado de outra natureza: no breadth benchmark, OpenAI e Anthropic classificaram INC-001 para a rota deployment, enquanto Groq escolheu dependency. A fixture, a arquitetura e a instrução de classificação eram as mesmas.
Em um sistema em que a classificação do modelo decide qual workflow será executado, essa divergência afeta o comportamento da aplicação além do texto da resposta. Uma troca de provider/model/configuration bundle pode mudar o caminho percorrido pelo sistema.
Por isso, o routing do projeto converte a resposta para uma enum conhecida e falha fechado diante de valores inesperados. O modelo participa da escolha, mas o código continua definindo o universo de rotas aceitas.
 Ampliar ↗
Esse comportamento também é uma razão para tratar provider, modelo, API e configuração como um bundle experimental. As diferenças observadas não podem ser atribuídas isoladamente ao modelo, porque transporte, limites de output, tokenização, configuração de reasoning e condições do serviço também variam.
O que esses resultados ainda não dizem#
Os benchmarks breadth e epistemic têm uma limitação importante: existe apenas uma execução por célula. Eles descrevem o comportamento observado, mas não permitem estimar variância ou significância estatística. Os quatro incidentes também pertencem ao mesmo domínio de infraestrutura. Um sistema de análise jurídica, crédito, atendimento ou desenvolvimento de software pode apresentar padrões completamente diferentes.Os fixtures são sintéticos e controlados. Isso facilita a avaliação porque existe uma referência conhecida para cada evidência, mas incidentes reais apresentam ruído, lacunas, timestamps conflitantes e fontes incompletas. Custo também ainda não está normalizado em dólares. O projeto registra tokens e latência, mas os providers possuem tokenizadores, preços e limites de output diferentes. No breadth, por exemplo, OpenAI e Anthropic usaram output cap de 4.000 tokens, enquanto Groq usou 900.
Essas diferenças impedem uma leitura do projeto como leaderboard de modelos. O repositório mantém uma seção específica de limitações e não-afirmações, e os relatórios congelados documentam threats to validity. Esse cuidado se tornou parte da metodologia: se o objetivo é avaliar quanta certeza uma resposta deveria expressar, as conclusões sobre o próprio benchmark também precisam respeitar o alcance da evidência disponível.
Para quem está escolhendo entre workflows e agents#
Depois desses experimentos, minha forma de pensar sobre autonomia ficou mais concreta. Há tarefas em que o caminho é conhecido antecipadamente e pode ser representado como código. Nesses casos, workflows oferecem um controle operacional simples de reconstruir, testar e observar. Em outras situações, o sistema precisa adquirir novas evidências durante a execução e decidir o que investigar a partir do que acabou de encontrar. A capacidade de escolher o próximo passo começa a ter valor nesse ponto. O bounded agent do laboratório explora exatamente essa segunda situação, mas dentro de uma fronteira estreita. Ele escolhe quais evidências consultar e em qual ordem, enquanto permissões, budgets e capacidade de ação continuam definidos deterministicamente.
Os benchmarks mostraram um sinal interessante de contenção causal nesse desenho. O breadth registrou zero overclaims nas dez células observáveis; a geração Epistemic v4.1 registrou quatro em doze, ainda a menor taxa entre os padrões totalmente observados. O grounding permaneceu alto nas duas gerações. Ainda há muito espaço para testar esse comportamento com mais fixtures, repetições e outros domínios.
Para decisões de arquitetura hoje, continuo achando mais útil começar pela solução mais simples que atende ao problema, medir o comportamento real e acrescentar autonomia quando existe uma necessidade concreta que o fluxo atual não resolve bem.
Esse princípio parece básico, mas na prática ele evita que flexibilidade futura seja comprada antecipadamente com mais estados possíveis, mais pontos de falha e mais dificuldade de auditoria.
O Controlled Autonomy Lab continua evoluindo justamente a partir dessas perguntas.
Repositório e dados dos benchmarks: