Nos posts anteriores mostrei como o DSPy classifica a intenção e como o roteador customizado por embeddings decide a macro-intent. Os dois têm uma coisa em comum: podem degradar silenciosamente.
O DSPy degrada quando o provider atualiza o modelo. O semantic router degrada quando o vocabulário dos usuários muda. Nenhum dos dois lança exceção quando isso acontece. Você descobre pela qualidade da resposta (ou pela reclamação do usuário).
Observabilidade é o que muda esse cenário. Esse post é sobre como instrumentar um grafo LangGraph com Langfuse para rastrear exatamente onde cada decisão aconteceu e como detectar degradação antes que chegue ao usuário.
O que o log estruturado não resolve#
O logger estruturado cobre o que aconteceu dentro de cada nó. Ele não responde perguntas como:
Para qual scope o DSPy roteou nas últimas 500 queries? Qual a distribuição?
A taxa de fallback para geral subiu nos últimos 30 minutos?
O
critique_nodeinterveio em quantas respostas hoje? Por qual tipo de violação?O
dspy.Refineprecisou de mais de uma tentativa em quantas requisições?
Essas perguntas exigem uma visão agregada sobre múltiplas execuções, não o log de uma execução individual. É aí que o Langfuse entra.
A instrumentação base: @observe nos nós#
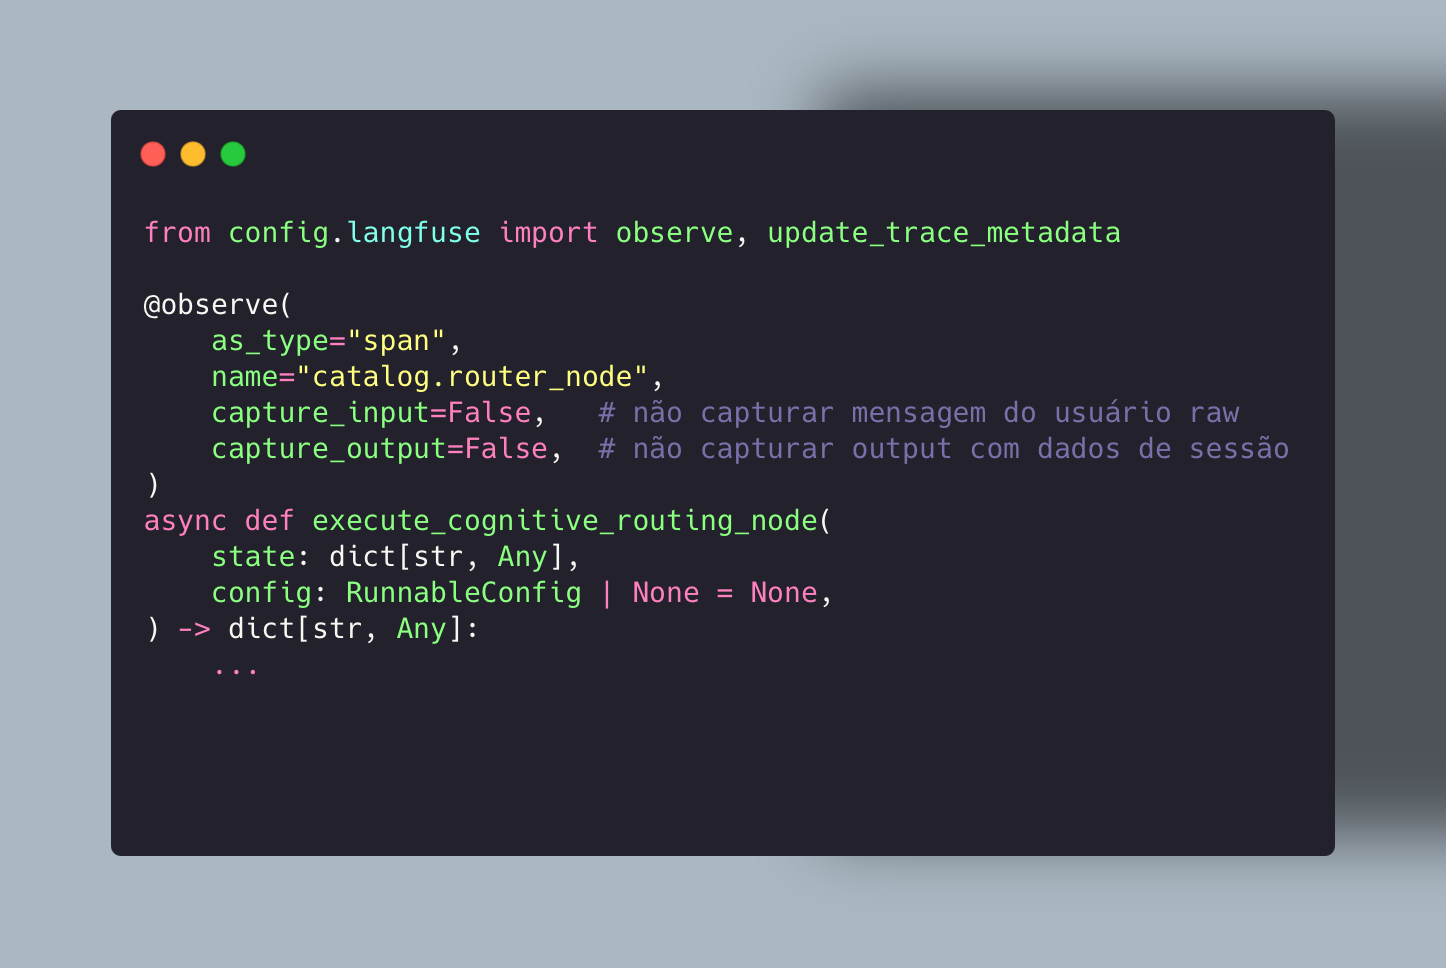
O ponto de entrada mais simples é o decorator @observe nos nós do grafo:
 Ampliar ↗
capture_input=False e capture_output=False não são paranoia. Em qualquer sistema com dados de usuário, capturar o estado completo do grafo no Langfuse significa capturar histórico de conversa, identificadores de sessão e potencialmente dados pessoais. O que você quer no trace não é o estado, são os metadados da decisão.
update_trace_metadata: injetando contexto na trace ativa#
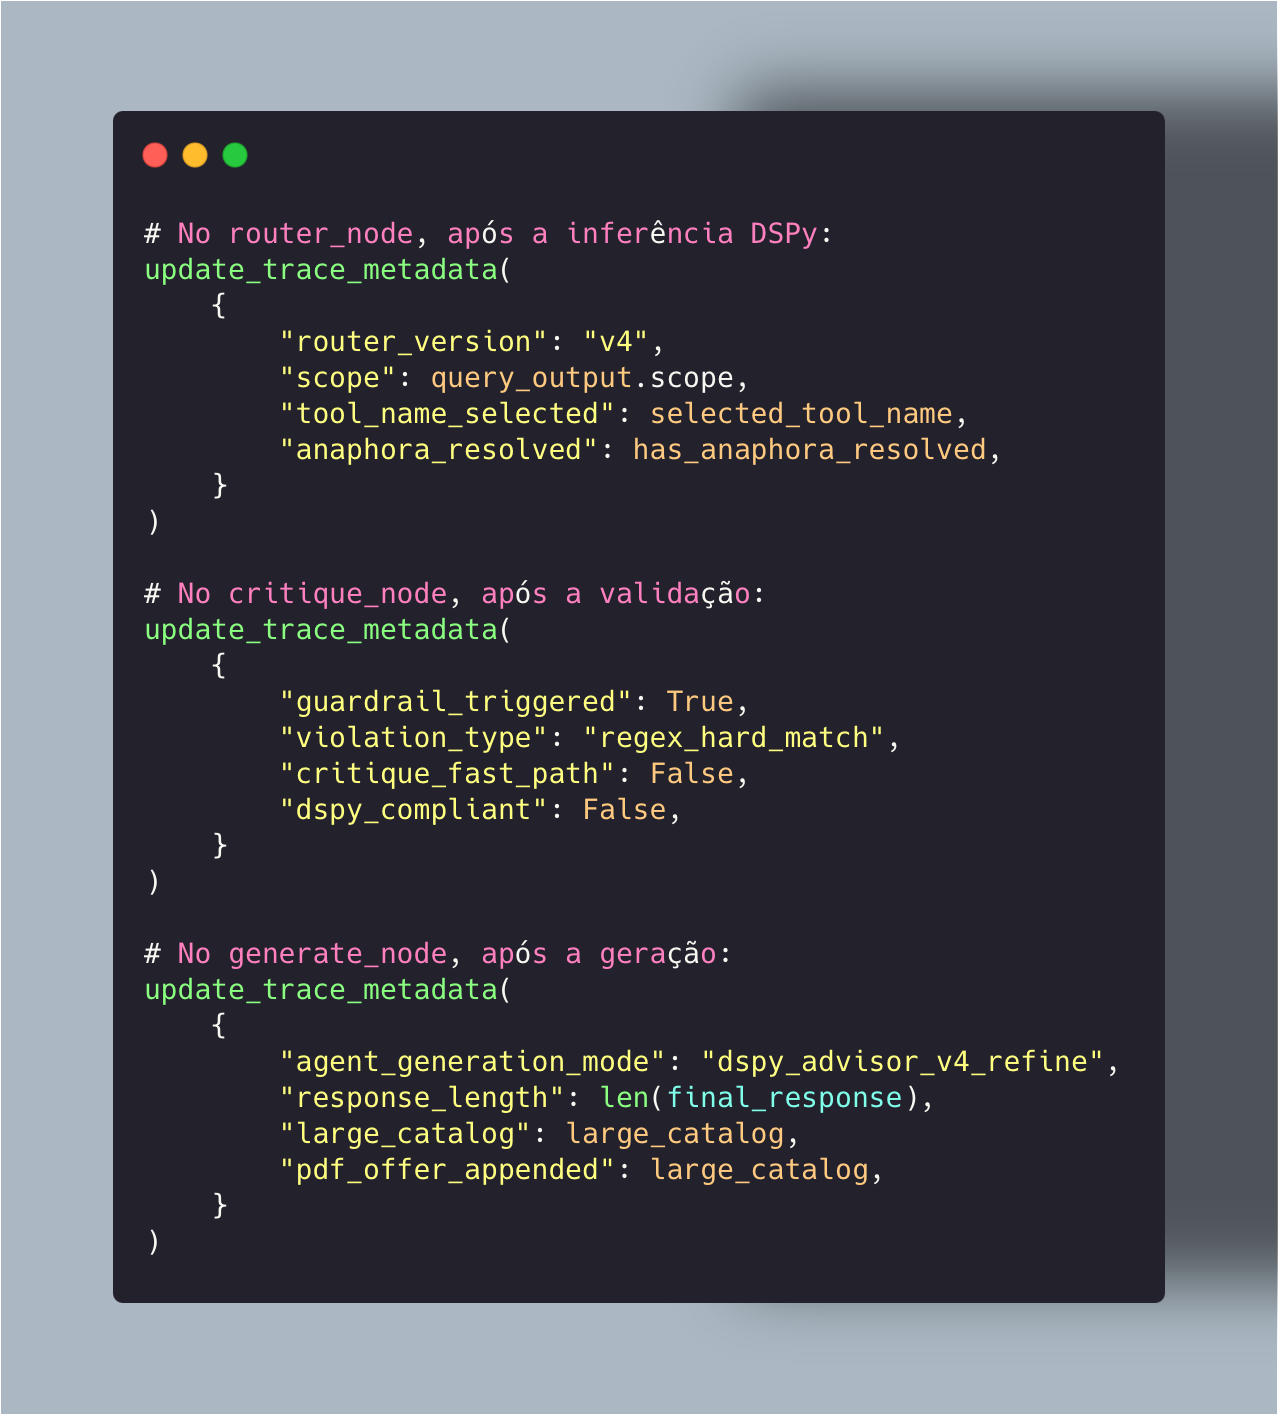
Dentro de qualquer nó, update_trace_metadata acumula metadados na trace da requisição atual:
 Ampliar ↗
Cada nó contribui com seus metadados para o mesma trace. No Langfuse, você vê o trace completo de uma requisição com todos esses campos agregados, sem precisar cruzar logs de diferentes workers.
Tags e user_id: segmentação sem dados pessoais#
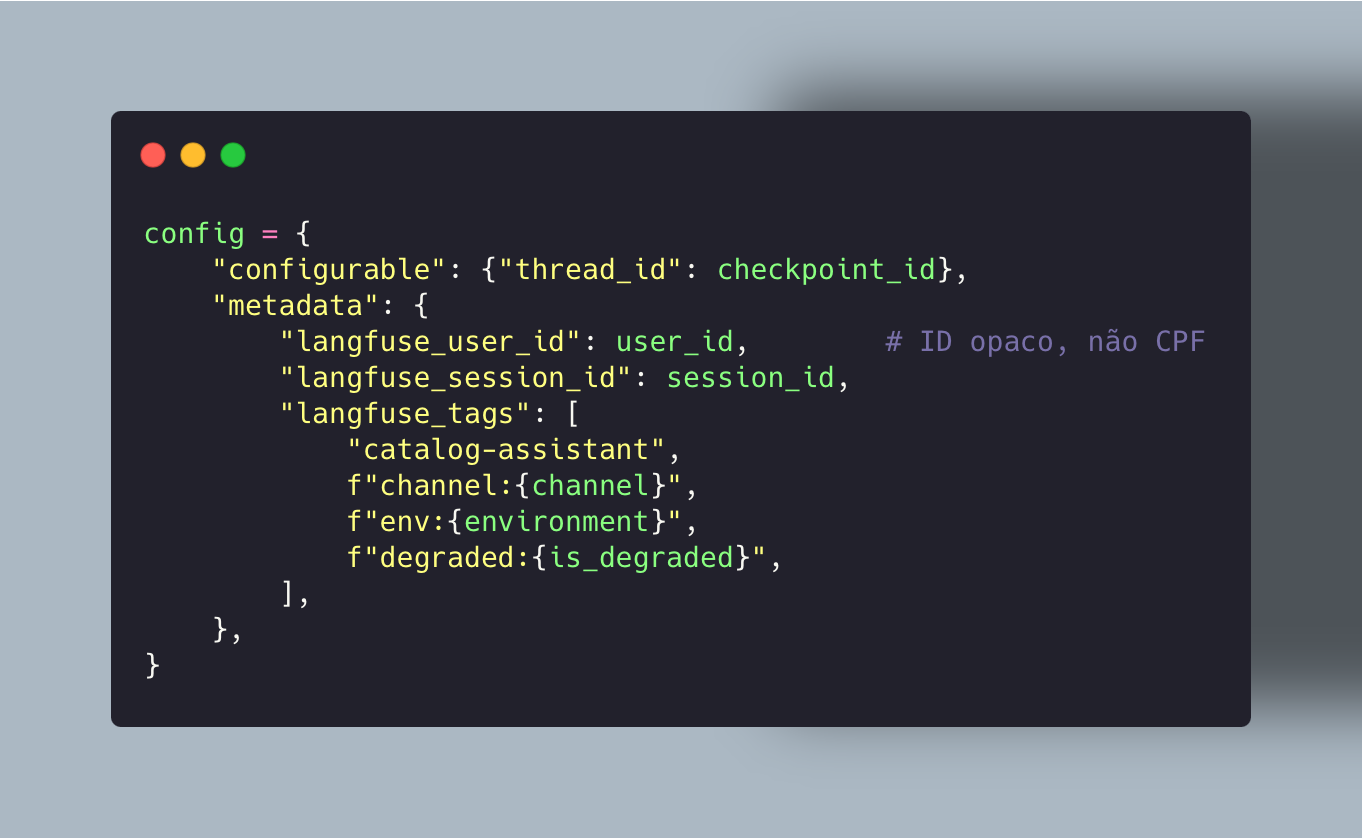
No supervisor, ao montar a configuração do grafo:
 Ampliar ↗
O langfuse_user_id é um identificador interno, nunca um CPF, e-mail ou número de telefone. As tags permitem filtrar traces por canal, ambiente e modo degradado no dashboard sem expor dados pessoais.
RouterMetricsCollector: métricas in-process com backend Redis#
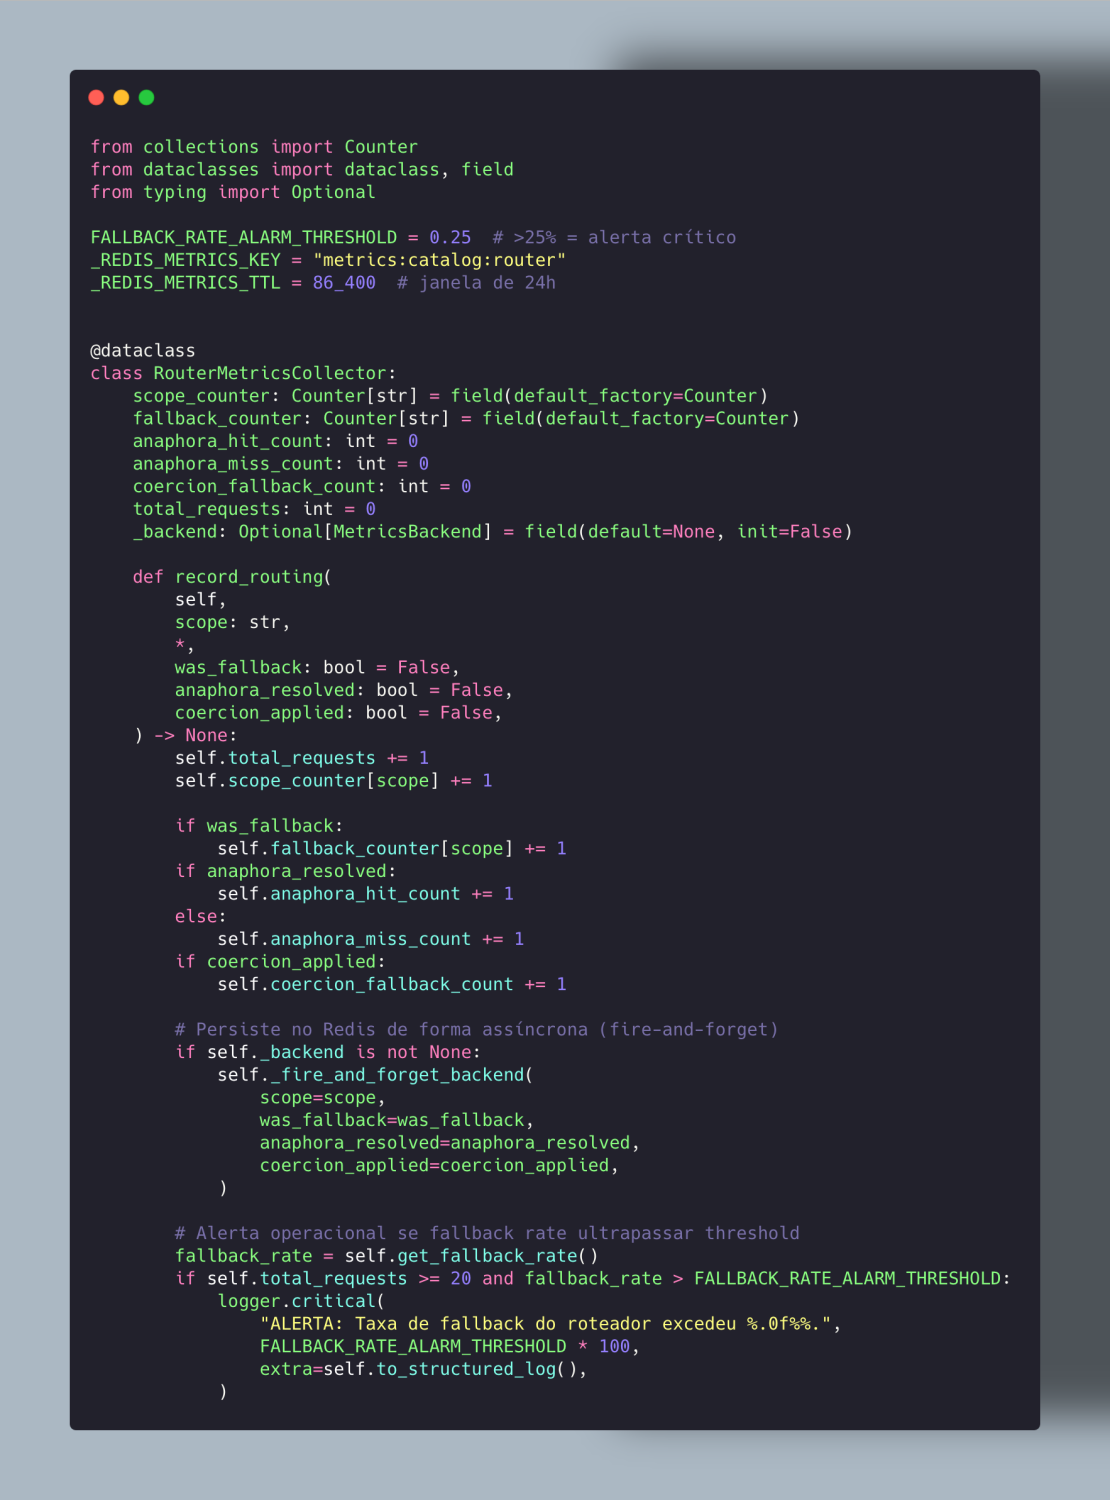
O Langfuse rastreia execuções individuais. Para métricas agregadas em tempo real, taxa de fallback, distribuição de scopes, hits de anáfora, o sistema tem um coletor próprio:
 Ampliar ↗
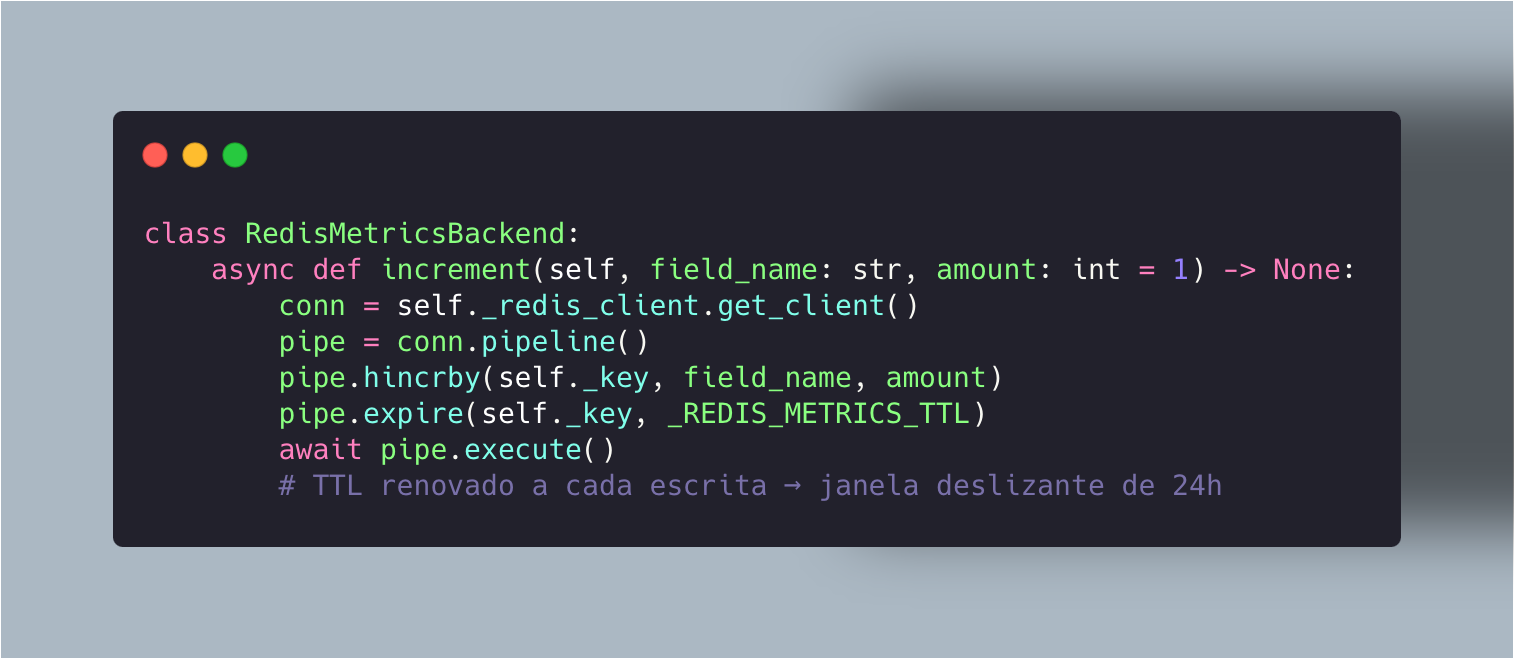
O backend Redis usa HINCRBY, compatível com deploys multi-worker onde cada processo tem seu próprio in-process counter, mas todos escrevem na mesma HASH:
 Ampliar ↗
O increment é fire-and-forget: não bloqueia o hot path do router_node. Se o Redis estiver indisponível, o contador in-process ainda funciona, e o alerta de fallback ainda dispara.
O que monitorar para detectar degradação do DSPy#
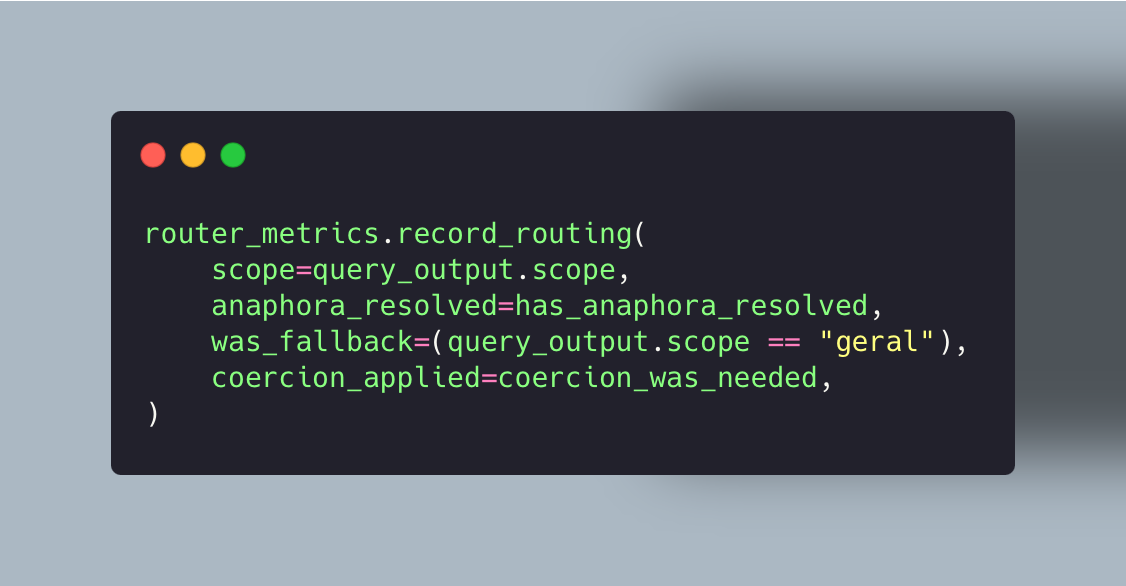
No router_node, após cada inferência:
 Ampliar ↗
Os três indicadores que mais importam:
Taxa de fallback para geral: quando o DSPy não consegue classificar a query, retorna scope="geral". Uma taxa acima de 25% é sinal de que os demos compilados estão desatualizados em relação ao vocabulário dos usuários. Correção: expandir o dataset e recompilar.
Taxa de anáfora resolvida: se
anaphora_hit_count/total cair abruptamente, os padrões regex do resolver de anáforas pararam de casar com as mensagens dos usuários. Correção: revisar os patterns.Taxa de coerção forçada: se
coercion_fallback_countsubir, o LLM começou a retornar formatos de output que a camada de coerção não consegue parsear. Correção: inspecionardspy.inspect_history()e revisar a Signature.
O que o Langfuse mostra que o log não mostra#
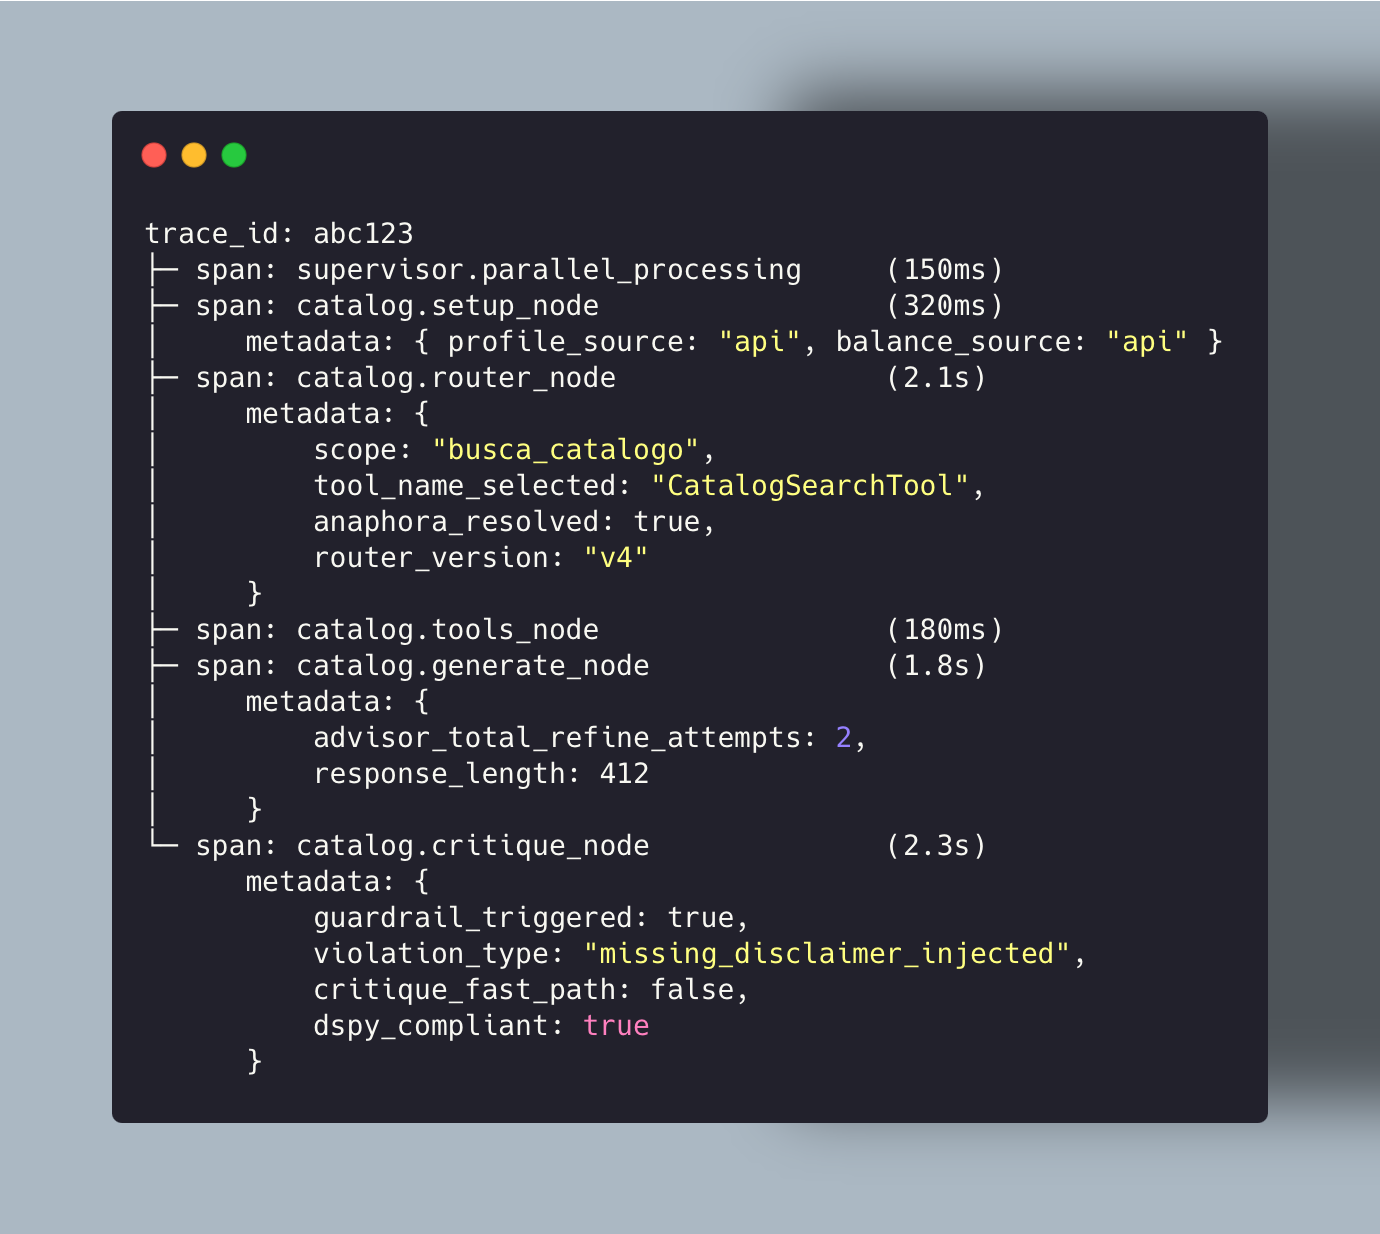
Com update_trace_metadata em todos os nós, o Langfuse agrega num único trace:
 Ampliar ↗
Em 5 segundos de execução você sabe: a anáfora foi resolvida, o DSPy roteou para busca de catálogo, o Refine precisou de 2 tentativas, e o critique injetou um disclaimer ausente.
Sem esse trace, você tem 5 logs em arquivos diferentes, sem correlação direta, sem timeline.
Itens importantes:#
capture_input=False em todos os spans que tocam mensagens do usuário.capture_output=False em todos os spans que retornam estado do grafo.O que vai para o Langfuse são os metadados da decisão, scope, tool selecionada, latência, flags de compliance, não os dados em si.
Dados de usuário pertencem ao arquivo legal. Metadados de decisão pertencem ao sistema de observabilidade. Misturar os dois cria problemas de privacidade e infla o custo do Langfuse sem adicionar valor para debugar.
Na semana que vem: como o módulo de geração usa autocorreção em runtime com função de recompensa, e o trade-off de latência que isso cria.