Esta série nasceu de duas situações bastante concretas. Em uma experiência profissional, herdei uma POC de uma arquitetura multiagente em que um supervisor construído com LangGraph delegava trabalho para agentes implementados com Agno. A separação parecia razoável no diagrama: um componente cuidava da orquestração e os demais executavam capacidades especializadas. O problema apareceu quando foi necessário entender continuidade, recuperação e estado. Cada runtime tinha seu próprio lifecycle, suas próprias identificações de execução e sua forma de persistir contexto. Quando alguma coisa saía do caminho feliz, reconstruir o que havia acontecido exigia atravessar duas caixas pretas que não compartilhavam uma visão única da execução.
Quase um ano depois, em uma conversa com outro profissional, surgiu um relato muito parecido. Era outra empresa, outra implementação e outro time, mas os sintomas eram familiares: supervisor de um lado, agentes de outro e dificuldade para preservar continuidade de forma previsível. Foi a partir dessas duas experiências que comecei a organizar melhor uma questão que aparece quando combinamos frameworks agentic: o problema raramente está apenas no modelo ou no prompt. Muitas vezes ele está na forma como estado, identidade e responsabilidade de execução foram distribuídos.
Esse tipo de arquitetura é fácil de justificar: LangGraph oferece uma boa base para workflows stateful, Agno acelera a construção de agentes e times especializados, CrewAI modela bem colaboração orientada a papéis e tarefas, e outros componentes podem entrar para serving, memória, tools e observabilidade. O ganho local de cada escolha é real, mas tem o maledetto do tradeoff: o custo aparece quando mais de uma dessas camadas passa a decidir, ao mesmo tempo, o que significa continuar uma conversa, retomar um run, repetir uma tarefa ou considerar um efeito concluído.
Antes de falar em memória, vale separar os tipos de estado#
Em aplicações com LLM, a palavra memória costuma ser usada para situações muito diferentes. Em produção, essa simplificação atrapalha porque uma conversa pode ter histórico textual, um workflow pode estar parado aguardando aprovação, um agente pode manter fatos de longo prazo e uma integração externa pode já ter sido executada mesmo que o checkpoint local ainda não registre isso.
Aprendi a separar pelo menos cinco categorias:
histórico conversacional: o que usuário e sistema já trocaram;
estado do workflow: em qual etapa do processo a execução se encontra;
memória de longo prazo: fatos que precisam sobreviver a uma execução ou conversa;
estado operacional: qual run, tentativa, delegação ou agente está ativo;
efeitos externos: o que já aconteceu fora do runtime, como um pagamento, ticket ou envio de e-mail.
Essas categorias têm ciclos de vida diferentes. Um histórico de mensagens pode ser reconstruído a partir de uma sessão, enquanto um pagamento exige uma evidência muito mais forte de que foi ou não enviado. Guardar tudo sob uma estrutura genérica chamada memory pode funcionar durante a prototipação, mas fica frágil quando entram retry, crash, concorrência e long-running workflows.
Duas persistências podem produzir duas versões válidas da mesma história#
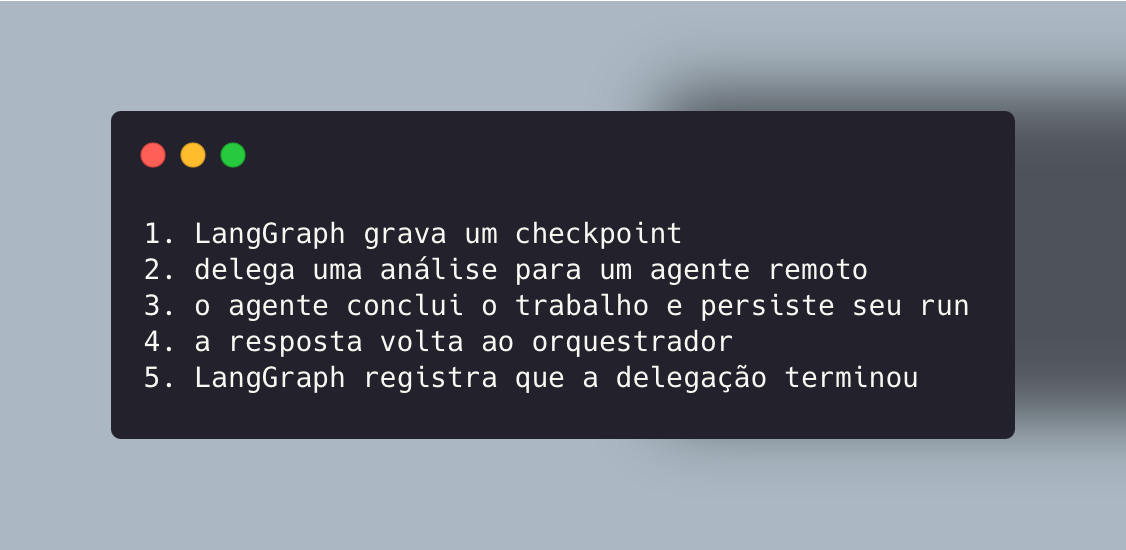
Considere uma integração em que LangGraph controla o fluxo global e um segundo framework persiste sua própria sessão. Um caminho simplificado poderia ser:
 Ampliar ↗
Se o processo cair entre os passos 3 e 5, o especialista pode ter evidência de conclusão enquanto o workflow ainda registra aquela delegação como pendente. Nenhuma das duas persistências está necessariamente corrompida; elas apenas registraram momentos diferentes da mesma operação sem uma transação comum entre os runtimes.
Esse tipo de falha é incômoda justamente porque não precisa gerar uma exceção. Depois do restart, a aplicação pode retomar e chamar o especialista novamente. O usuário percebe uma resposta repetida, uma análise duplicada ou alguma inconsistência de contexto, enquanto os logs mostram componentes aparentemente saudáveis.
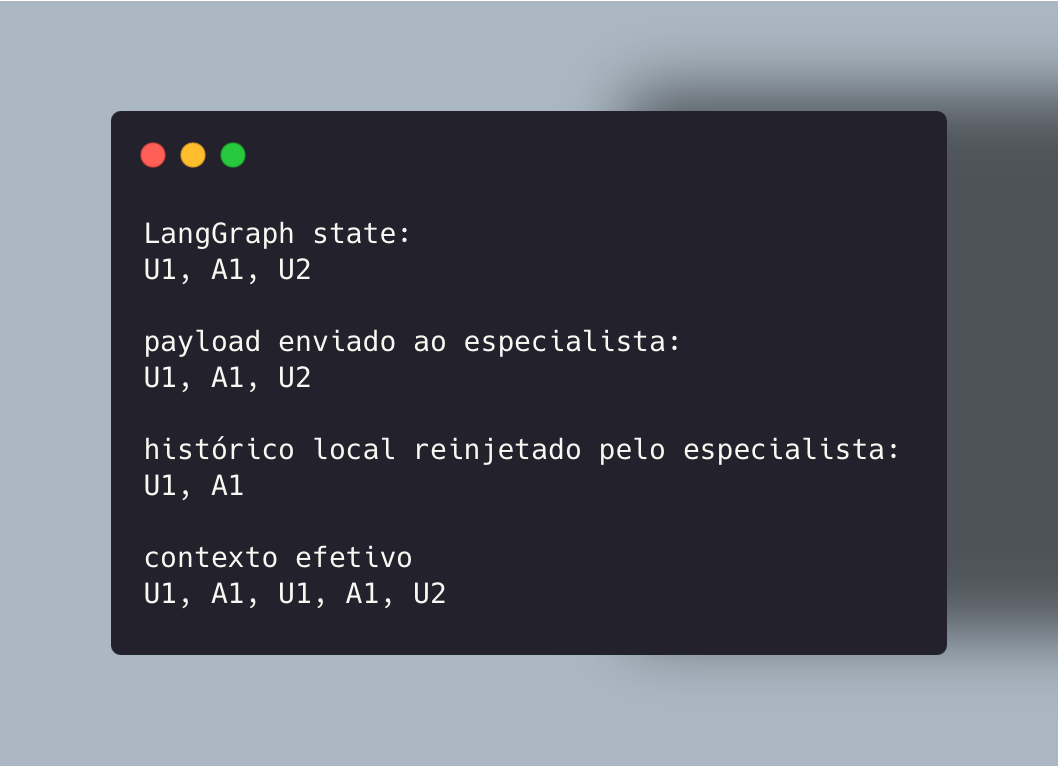
A mesma coisa acontece com histórico conversacional. Se o LangGraph envia ao especialista todas as mensagens acumuladas e o especialista, ao receber a mesma sessão, injeta outra vez o histórico que mantém localmente, o prompt pode conter mensagens duplicadas:
 Ampliar ↗
Quando a saída fica repetitiva ou contraditória, é tentador atribuir o comportamento ao LLM. Nesse caso, porém, a montagem do contexto já saiu errada antes de o modelo receber a requisição.
Checkpoint do workflow e efeito externo precisam de evidências diferentes#
Durable execution ajuda bastante a retomar uma máquina de estados, mas não resolve sozinho o que aconteceu em sistemas externos. Imagine que um nó envie uma requisição de pagamento e o processo caia logo depois da resposta do provedor, antes do próximo checkpoint. Na retomada, executar o nó novamente pode gerar uma segunda tentativa de pagamento.
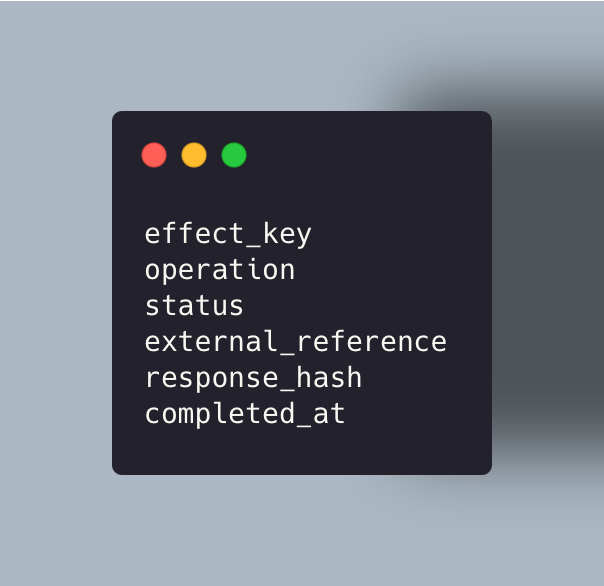
Por isso prefiro manter uma separação clara entre o checkpoint do workflow e um registro de efeitos externos. O checkpoint responde onde a execução estava. O ledger de efeitos responde o que já foi realizado fora dela. Uma estrutura mínima pode guardar:
 Ampliar ↗
Antes de repetir uma operação crítica, o runtime consulta esse registro. Para algumas integrações, a própria API externa também oferece idempotency keys e pode servir como parte dessa garantia. Em processos financeiros, de atendimento ou qualquer fluxo com side effects relevantes, essa distinção evita que recuperação de workflow seja confundida com repetição segura de operação.
Identidade precisa existir acima do framework#
Outro problema que vi nesses desenhos é deixar cada camada criar seus próprios identificadores sem uma relação explícita. LangGraph trabalha com thread_id; Agno organiza sessões e runs; CrewAI, serviços A2A, filas, traces e tools podem acrescentar novos IDs. Se a aplicação não possui identificadores canônicos, correlacionar tudo depois vira trabalho de investigação.
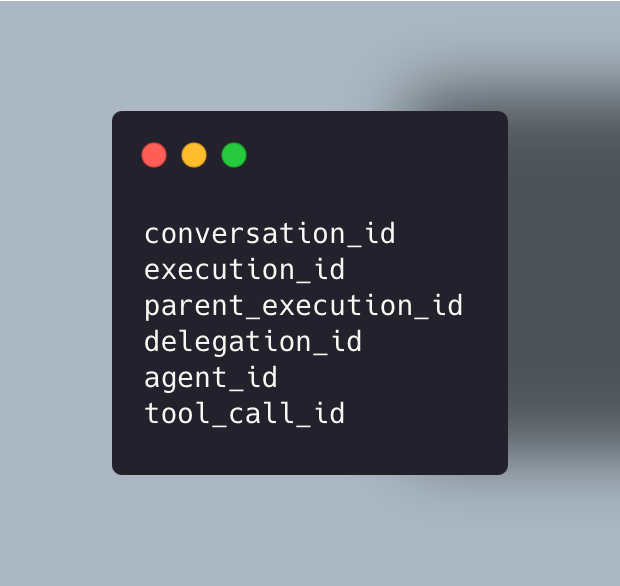
Um modelo que considero útil é manter na camada de aplicação:
 Ampliar ↗
A partir daí, cada runtime recebe um mapeamento. A mesma conversation_id, por exemplo, pode ser usada como thread_id no LangGraph e como session_id em um especialista Agno quando essa continuidade compartilhada fizer sentido. A delegation_id pode identificar a chamada remota e participar da chave de idempotência. Os frameworks continuam livres para criar IDs internos, mas existe uma identidade de negócio capaz de atravessar todos eles.
Também mantenho essa identidade separada de OpenTelemetry. trace_id e span_id são excelentes para troubleshooting distribuído, mas uma conversa pode gerar vários traces e uma execução pode ser retomada horas depois em outro trace. O melhor resultado aparece quando a telemetria carrega os identificadores canônicos como atributos, permitindo navegar tanto pela visão operacional quanto pela história do processo.
O objetivo desta série#
Os próximos artigos partem dessa experiência para explorar alguns pontos que passaram a ser critérios de arquitetura para mim. O segundo trata de identidade e continuidade entre runtimes. O terceiro mostra uma forma de combinar LangGraph e Agno mantendo um único dono do workflow global, com contratos explícitos, idempotência e um ledger de efeitos. O quarto amplia a comparação para CrewAI e discute quando cada abstração tende a encaixar melhor no problema.
O objetivo não é transformar uma escolha de framework em regra universal. LangGraph, Agno e CrewAI resolvem problemas reais e podem coexistir na mesma solução. O cuidado está em definir quais responsabilidades atravessam a fronteira entre eles, quais permanecem locais e qual componente tem autoridade para afirmar o estado global da execução. Foi justamente a ausência dessas respostas, nas situações que motivaram esta série, que tornou o diagnóstico tão difícil.