Depois de lidar com uma arquitetura em que LangGraph e Agno dividiam responsabilidades sem uma fronteira suficientemente clara, no meu caso a decisão acabou sendo migrar a solução integralmente para LangGraph.
A escolha fez sentido para aquele caso, pois o workflow já dependia bastante de estado, branching, checkpoints, retomada e controle explícito da execução, então manter dois runtimes acrescentava uma complexidade que não estava trazendo benefício proporcional. Concentrar a orquestração e os agentes em LangGraph simplificou continuidade, observabilidade e troubleshooting.
Essa experiência, porém, não me levou à conclusão de que LangGraph e Agno não devam ser usados juntos. O que ficou mais claro foi em quais condições essa combinação começa a fazer sentido e, principalmente, quais responsabilidades precisam estar definidas antes da integração.
Se eu tivesse hoje um motivo concreto para manter os dois frameworks na mesma aplicação, usaria um deles como autoridade sobre o processo global e trataria o outro como uma capability delimitada, acessada por contrato. Esse é o desenho que apresento aqui.
Há cenários em que a combinação é justificável: enquanto o LangGraph oferece um modelo muito conveniente para state machines, checkpoints, branching, interrupts e retomada, o Agno facilita a construção de agentes especializados com tools, knowledge, sessões e Teams, além dos componentes disponíveis ao redor do AgentOS. Um produto pode ter um workflow de negócio fortemente stateful e, ao mesmo tempo, já possuir um especialista Agno consolidado ou uma capability que faça sentido manter nesse ecossistema.
Nessa situação, a primeira decisão que eu tomaria seria definir quem responde pelo estado global da execução.
Um desenho que eu usaria#
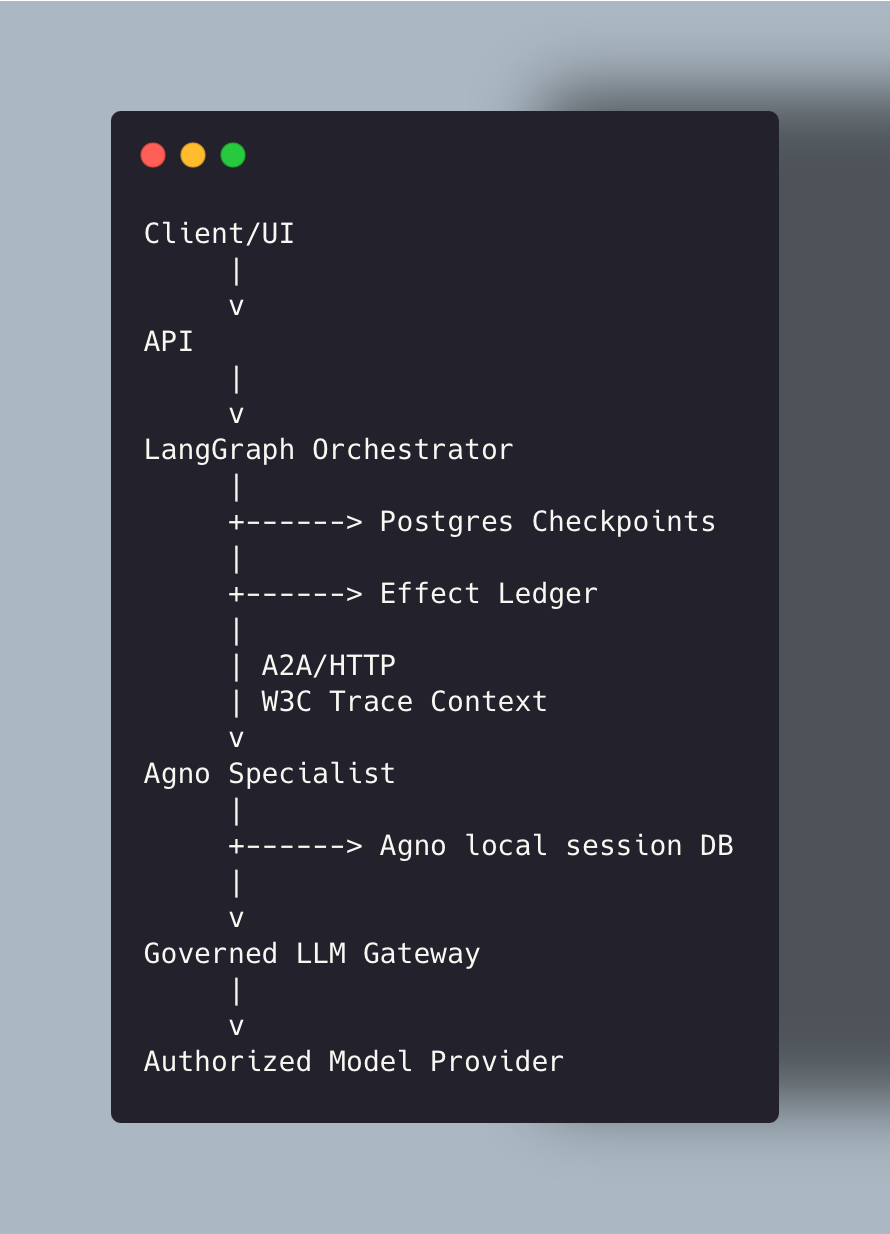
Para um workflow com coleta de dados, análise, compliance, aprovação humana e execução, manteria LangGraph como runtime autoritativo, enquanto um especialista Agno receberia uma tarefa delimitada e retornaria um resultado estruturado. Seu estado interno serviria para executar aquela capacidade, sem representar paralelamente a situação global do processo.
 Ampliar ↗
Nesse desenho, LangGraph mantém a fase do workflow, branching, interrupts, aprovação humana e progressão dos checkpoints e o Agno mantém apenas o estado necessário para a execução do especialista, como contexto local, ferramentas, knowledge e memória cujo escopo pertença àquela capability.
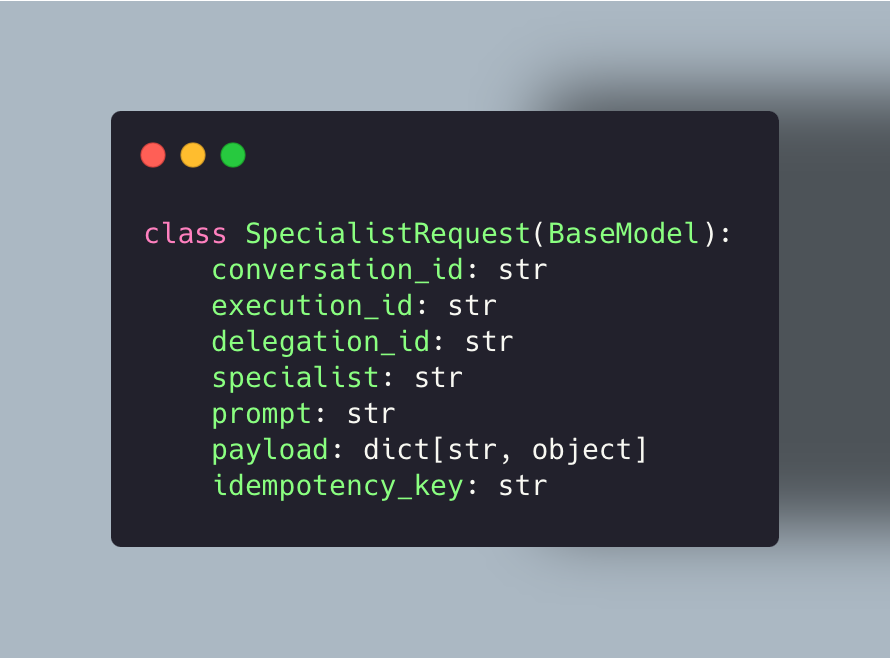
A camada de aplicação cria os identificadores que atravessam os runtimes, como 𝐜𝐨𝐧𝐯𝐞𝐫𝐬𝐚𝐭𝐢𝐨𝐧_𝐢𝐝, 𝐞𝐱𝐞𝐜𝐮𝐭𝐢𝐨𝐧_𝐢𝐝 𝐞 𝐝𝐞𝐥𝐞𝐠𝐚𝐭𝐢𝐨𝐧_𝐢𝐝, além da chave de idempotência. Um ledger independente registra resultados ou efeitos remotos já concluídos. O gateway de modelos fica responsável por credenciais, política de providers e modelos, fallback e proveniência.
Uma das dificuldades que encontrei na arquitetura que motivou esta série era justamente a quantidade de conhecimento implícito entre os runtimes. Quando o estado interno de um framework começa a ser necessário para que o outro consiga continuar a execução, troubleshooting e recovery ficam mais difíceis, por isso hoje prefiro colocar um contrato da aplicação nessa fronteira.
O contrato precisa sobreviver à troca do especialista#
Um request para um especialista pode ser relativamente simples:
 Ampliar ↗
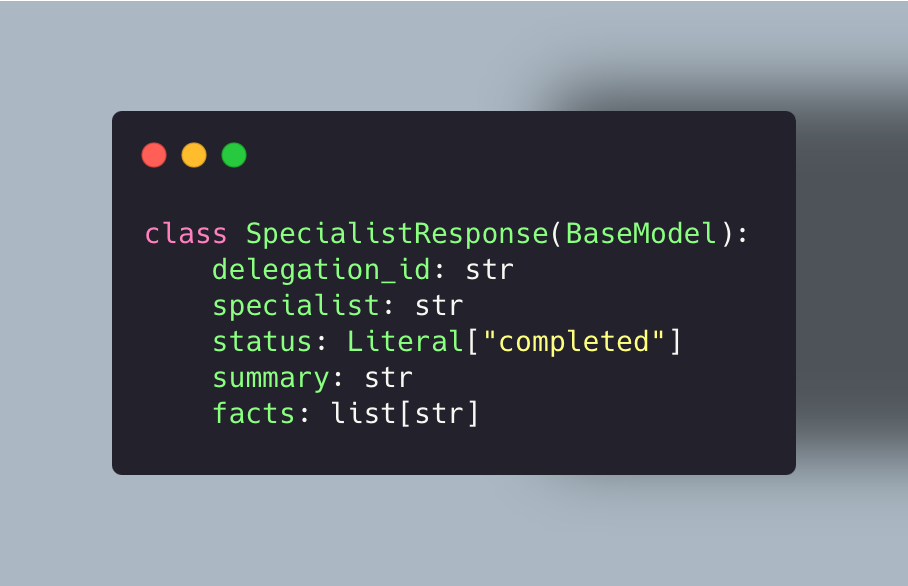
E a resposta:
 Ampliar ↗
O grafo conhece essas estruturas e uma interface como SpecialistPort e o adapter conhece Agno. Essa separação tem uma consequência prática importante: se o especialista for posteriormente implantado novamente em CrewAI, em um serviço próprio ou em outro runtime, o modelo de estado global não precisa ser redesenhado junto com ele.
O mesmo vale para identidade: um mapping explícito pode utilizar conversation_id como thread_id do LangGraph e como session_id do Agno, enquanto delegation_id identifica a execução remota daquele especialista. A convenção exata depende da aplicação; o importante é que ela seja criada pela aplicação e permaneça estável durante retries, restarts e failovers.
A2A como fronteira entre runtimes#
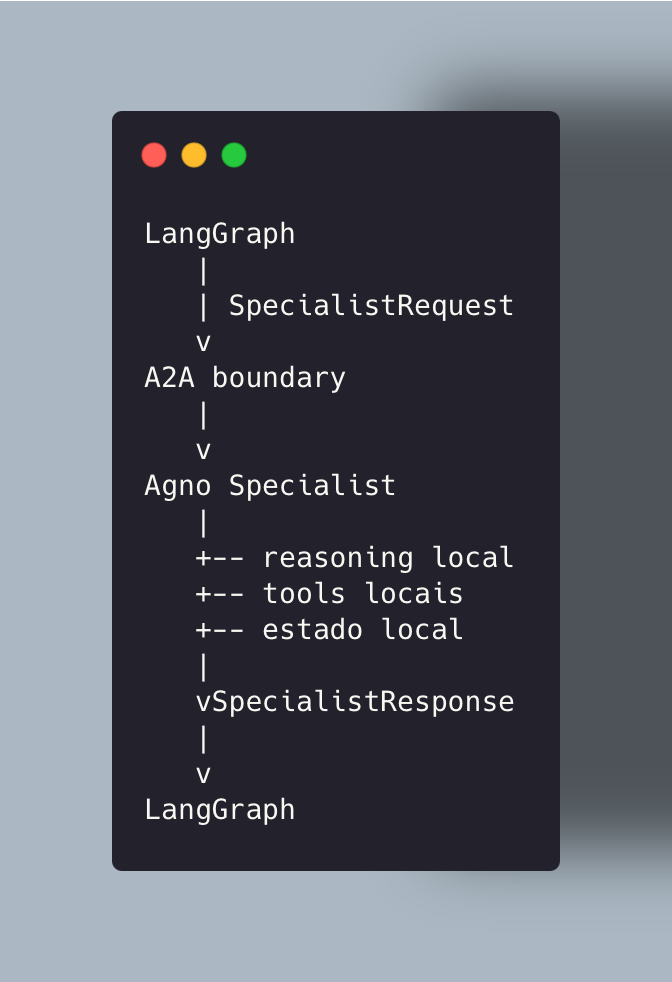
Quando o especialista roda como serviço independente, A2A é uma opção interessante para transportar a delegação e o contexto necessário entre os runtimes.
 Ampliar ↗
Eu manteria o protocolo como uma fronteira de comunicação. O estado de negócio continua sendo mantido pelo runtime que controla o workflow. Essa separação também ajuda a diferenciar A2A de MCP: um agente pode receber uma tarefa de outro runtime por A2A e, durante sua execução, consumir ferramentas ou recursos expostos por MCP. São responsabilidades diferentes e podem coexistir sem que o protocolo de comunicação precise se transformar no mecanismo de persistência do workflow.
Recovery depois da chamada remota#
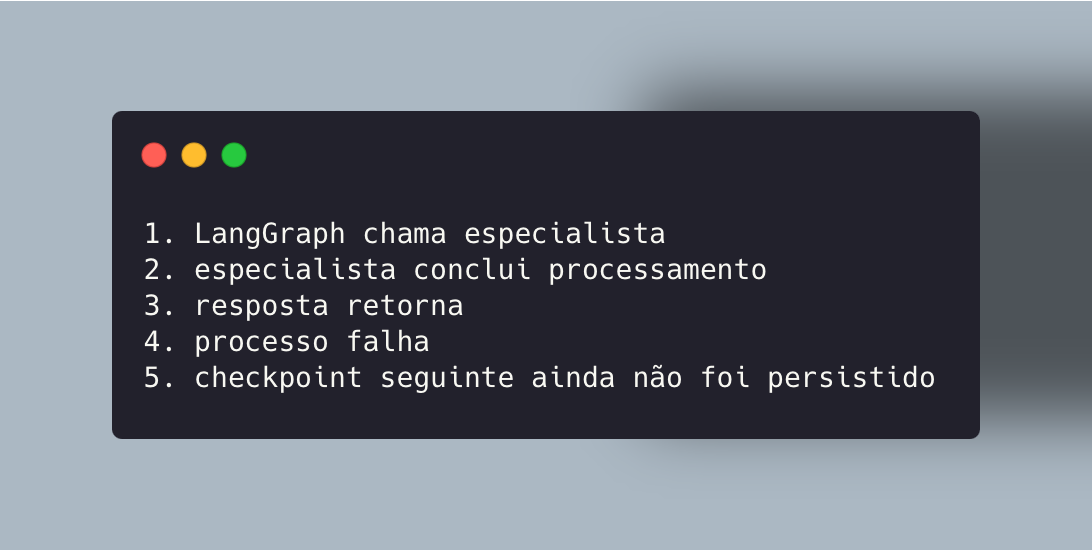
Uma das janelas mais delicadas aparece quando um especialista conclui seu trabalho e o processo principal falha antes de registrar o próximo checkpoint.
Imagine a seguinte sequência:
 Ampliar ↗
Sem idempotência, a retomada pode simplesmente executar novamente o especialista.
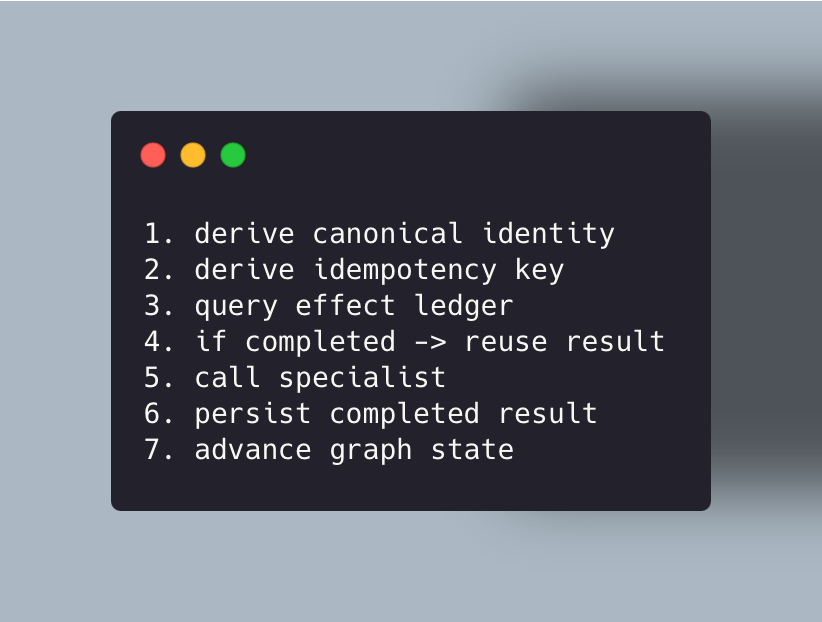
Eu trataria a chamada remota desta forma:
 Ampliar ↗
Se ocorrer uma falha depois do passo 6, o nó pode ser reexecutado durante a retomada. A aplicação consulta o ledger, encontra o resultado anterior e continua sem repetir o processamento remoto. Esse teste é particularmente útil porque reproduz uma classe de problemas que costuma aparecer somente depois que retry, persistence e chamadas remotas começam a operar juntos.
Para efeitos críticos, como movimentações financeiras ou alterações em sistemas externos, eu acrescentaria transactional outbox ou outra estratégia equivalente. Checkpoint do workflow e confirmação de um efeito externo são problemas relacionados, mas não representam a mesma coisa.
Persistência e observabilidade#
Para o estado canônico do workflow, Postgres se encaixa bem nesse desenho. O LangGraph possui checkpointer para Postgres e a combinação funciona bem para processos que precisam de durabilidade, retomada e auditabilidade. Redis pode continuar sendo útil para cache, rate limiting ou coordenação efêmera. Eu teria mais cuidado em utilizá-lo como única fonte de verdade para um workflow cujo histórico de execução precisa ser reconstruído depois de uma falha. Event sourcing pode fazer sentido em ambientes em que replay detalhado e trilha causal são requisitos importantes, mas adiciona outro conjunto de decisões arquiteturais e operacionais. Eu o adotaria quando essa necessidade já estivesse presente no domínio.
Com mais de um runtime, tracing distribuído também passa a ter um papel maior. Propagaria W3C Trace Context em toda a cadeia e adicionaria aos spans identificadores como conversation_id, execution_id, delegation_id, agent_id e tool_call_id.
As fronteiras remotas também merecem validações semelhantes às de qualquer API interna: versão de schema, especialista permitido, IDs, tamanho de payload, idempotency key e tipos de resposta. O especialista recebe apenas a autoridade necessária para cumprir sua função.
A arquitetura também pode ser invertida#
LangGraph não precisa ser necessariamente o runtime principal. Se uma aplicação já utiliza AgentOS como runtime central e existe uma capability específica implementada com LangGraph, a relação pode ser invertida. Nesse caso, AgentOS mantém a autoridade global e o grafo remoto executa uma função delimitada. O cuidado permanece o mesmo: evitar que os dois componentes mantenham versões independentes e autoritativas do mesmo processo.
Antes de adicionar um segundo framework, hoje eu procuro responder uma pergunta bastante concreta: qual capacidade adicional justifica introduzir outro lifecycle, outro modelo de persistência, outra semântica de retry e outra fronteira operacional? No projeto que originou esta série, a resposta acabou favorecendo a simplificação e a migração para LangGraph. Em outro sistema, um especialista Agno existente, uma Team já consolidada ou requisitos específicos do AgentOS poderiam justificar manter os dois.
Foi justamente para explorar essa segunda situação que construí o repositório de exemplo que acompanha a série. Nele, LangGraph controla o workflow global e Agno aparece como um especialista remoto acessado por contrato. Depois adicionei CrewAI como uma implementação alternativa do mesmo especialista.
O objetivo do experimento é verificar se o restante da aplicação continua funcionando quando o framework do especialista muda. Se essa troca exige alterar o state machine global, os IDs de negócio ou a estratégia de recovery, provavelmente a fronteira ainda está carregando responsabilidades demais.
Repositório: https://github.com/brunovicco/agent-runtime-boundaries-lab