Depois de olhar para estado e continuidade na primeira parte dessa série, uma das causas mais frequentes de comportamento estranho merece atenção separada: identidade. Em um sistema stateful, uma requisição só continua a história anterior se os componentes envolvidos conseguirem associá-la à mesma conversa, à mesma execução lógica e, quando houver delegação, ao mesmo trabalho remoto.
Quando isso falha, o efeito para quem usa a aplicação se parece muito com perda de memória. O agente volta a perguntar algo já respondido, ignora uma aprovação anterior, repete uma análise ou inicia uma nova sequência de raciocínio. Antes de aumentar contexto, trocar modelo ou adicionar uma camada de memória, vale verificar se o runtime recebeu os identificadores corretos.
Conversa, execução e delegação têm durações diferentes#
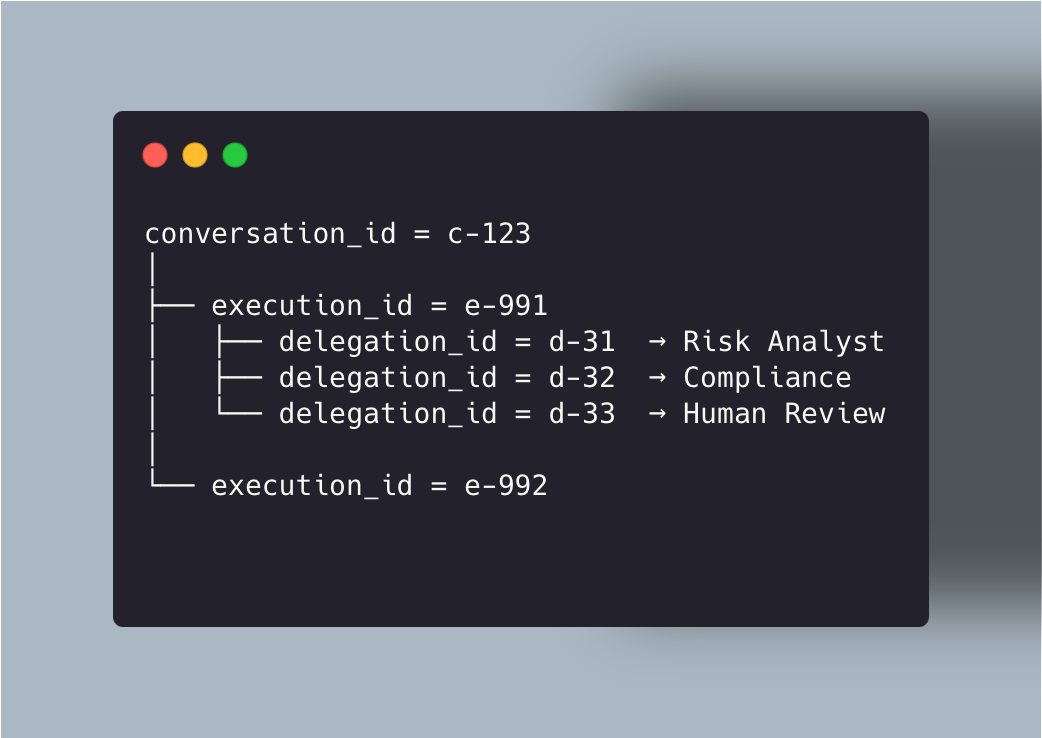
Eu separo três níveis básicos:
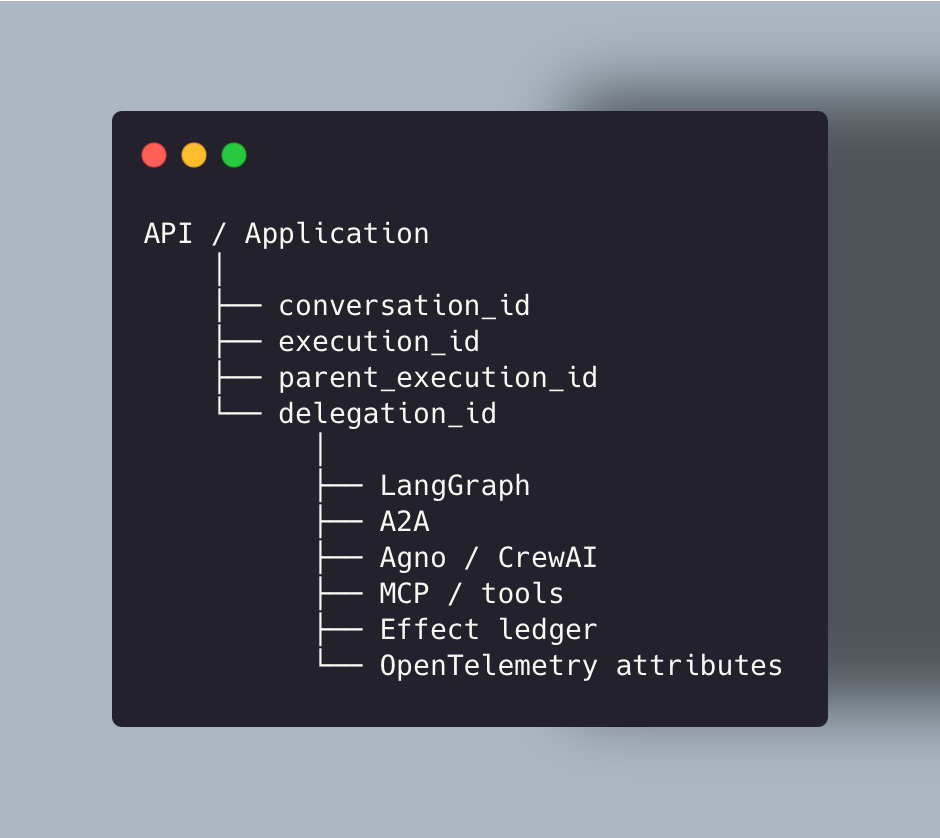
conversation_idrepresenta a continuidade lógica de uma interação ou processo.execution_ididentifica uma tentativa concreta de processar algo dentro daquela conversa.delegation_ididentifica um trabalho entregue a uma capability, agente ou serviço específico.
 Ampliar ↗
Essa separação fica especialmente útil quando existe retry. Um timeout de transporte não deveria, por acidente, transformar a repetição da mesma delegação em um novo trabalho de negócio. Ao mesmo tempo, uma nova solicitação do usuário pode pertencer à mesma conversa e gerar uma execução diferente. Sem esse vocabulário, IDs acabam sendo reutilizados ou recriados de forma arbitrária.
Como isso aparece em LangGraph e Agno#
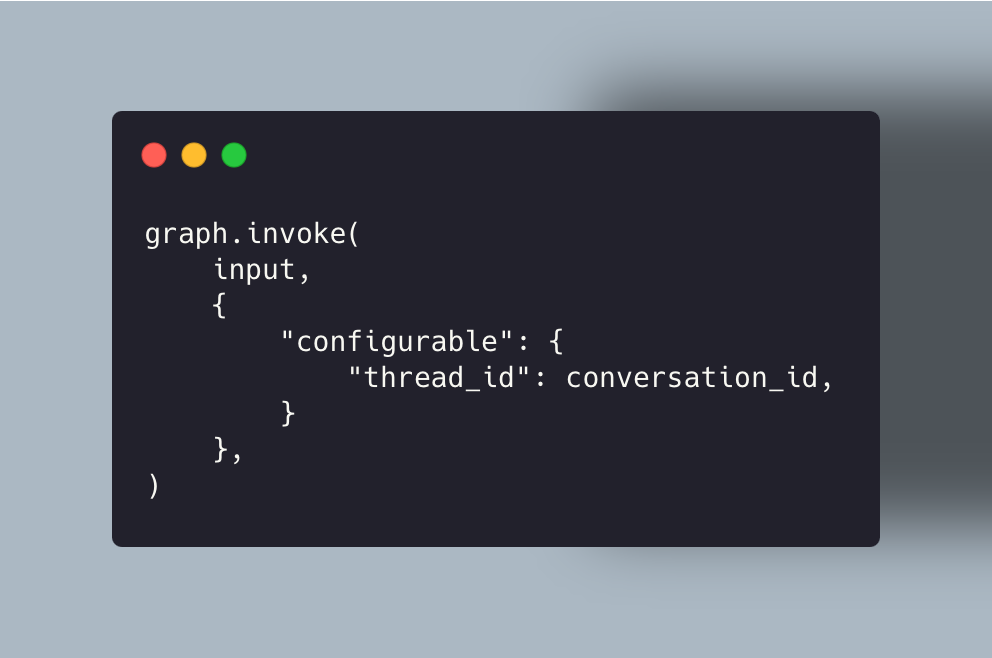
No LangGraph, thread_id é parte da identidade persistida usada pelo checkpointer. Se a próxima chamada chegar com outro valor, o runtime passa a consultar outra thread. A aplicação pode estar mostrando a mesma janela de chat para o usuário, mas o grafo já está lendo outro histórico de checkpoints.
Um uso simplificado seria:
 Ampliar ↗
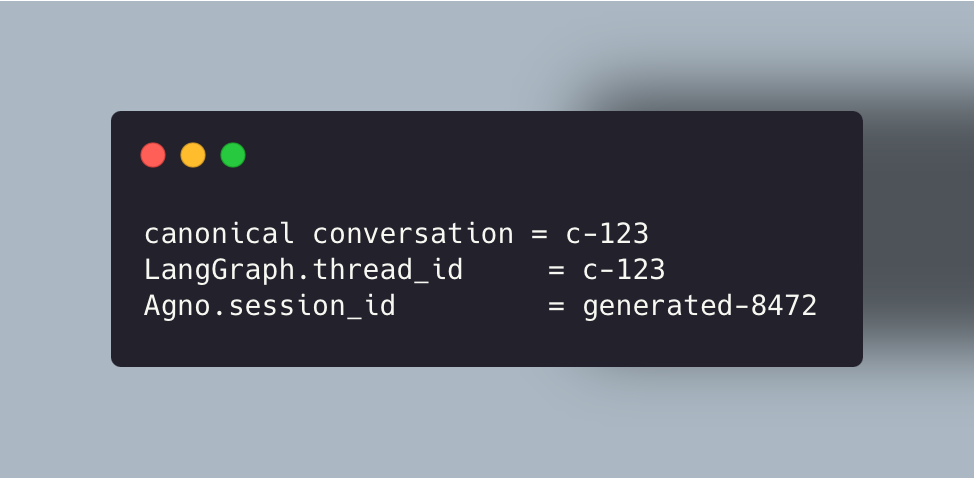
No Agno, session_id e run_id representam coisas diferentes. A sessão agrupa continuidade enquanto o run identifica uma execução individual do componente. Em uma integração entre os dois frameworks, é fácil acabar com algo assim:
 Ampliar ↗
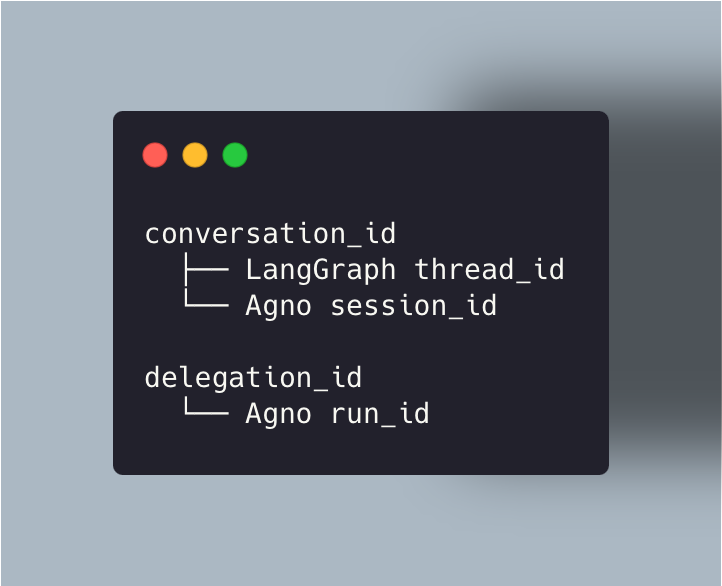
Cada lado continua coerente internamente, mas eles já não estão reconstruindo a mesma história. Quando a intenção for compartilhar a identidade da conversa, prefiro mapear explicitamente:
 Ampliar ↗
Esse mapping pertence à aplicação. Ele não deveria depender de um adapter descobrir sozinho qual ID de outro framework precisa reutilizar.
IDs automáticos são ótimos no começo e perigosos quando viram contrato implícito#
Durante um protótipo, deixar cada biblioteca criar identificadores reduz código e acelera a primeira versão. O problema aparece quando aquela implementação começa a receber retries, workers diferentes, filas ou chamadas remotas. Um serviço cria a sessão, outro cria o run, o gateway adiciona um request ID e a telemetria gera um trace. Depois de alguns meses, ninguém consegue dizer com segurança quais identificadores representam a mesma unidade de trabalho.
Por isso sugiro criar os IDs canônicos na camada de aplicação e propagá-los através das fronteiras:
 Ampliar ↗
Os runtimes podem continuar gerando identificadores internos para suas próprias estruturas. O importante é ter uma chave de correlação que sobreviva à troca de framework, à retomada e ao troubleshooting.
Retry exige uma decisão explícita sobre idempotência#
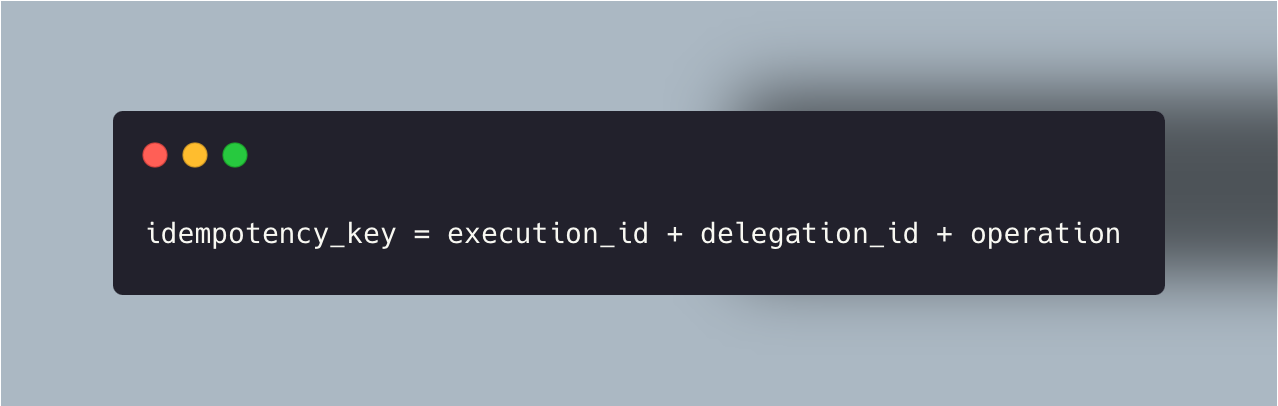
Considere uma delegação que chegou ao especialista, foi concluída e teve sua resposta perdida por timeout. O orquestrador faz uma nova chamada. Se esse retry receber uma nova delegation_id, o especialista não tem como saber que está vendo a repetição de um trabalho anterior.
Uma chave estável pode ser derivada do contexto de negócio:
 Ampliar ↗
Antes de executar novamente, o serviço consulta seu ledger ou um storage durável. Se já houver um resultado completo para aquela chave, ele devolve o resultado persistido. Isso não substitui o checkpointer do LangGraph; são garantias em níveis diferentes. O checkpointer ajuda a reconstruir o estado do grafo e a idempotência ajuda a impedir que uma repetição de transporte se transforme em um novo efeito de negócio.
Long-running deixa a importância desses IDs muito mais visível#
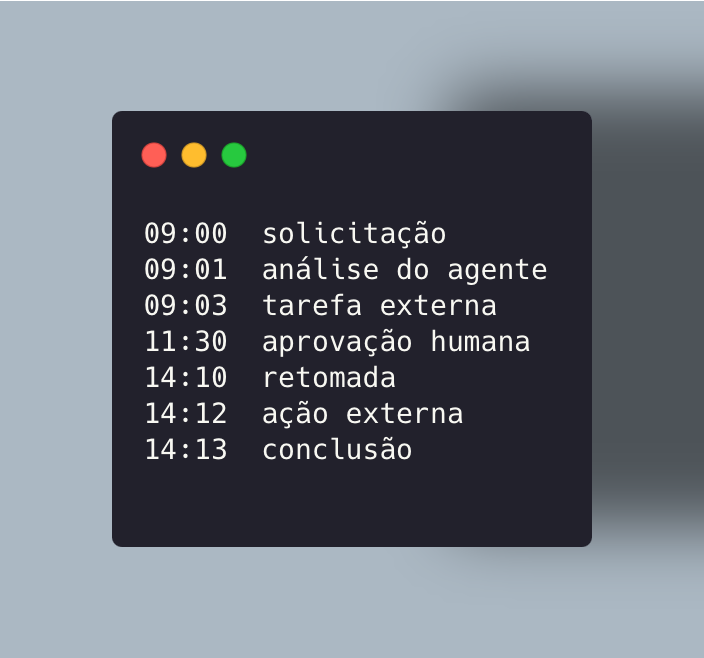
Em uma requisição curta, a execução parece simples: chega um input, o agente responde e termina. Em processos com maior duração, a mesma história pode atravessar deploy, failover, aprovação humana, mudança de worker e retomada manual:
 Ampliar ↗
Nesse intervalo, vários traces podem começar e terminar. O que precisa permanecer estável é a identidade de negócio. Uma opção é manter trace_id como informação de observabilidade e conversation_id, execution_id e delegation_id como informação do processo. Os dois conjuntos se encontram em atributos dos spans e logs.
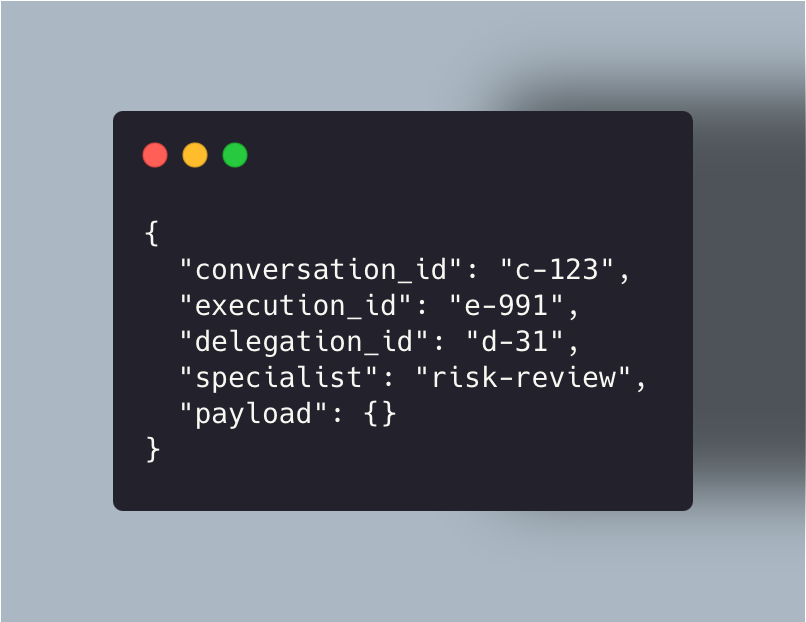
O mesmo princípio vale para A2A. A mensagem é o transporte da delegação; ela não substitui o modelo de identidade da aplicação. Um payload pode carregar ou permitir reconstruir algo como:
 Ampliar ↗
O receptor pode manter estado local e IDs internos, desde que não redefina silenciosamente qual conversa ou execução está processando.
Um teste de recuperação que vale mais do que muitos testes de happy path#
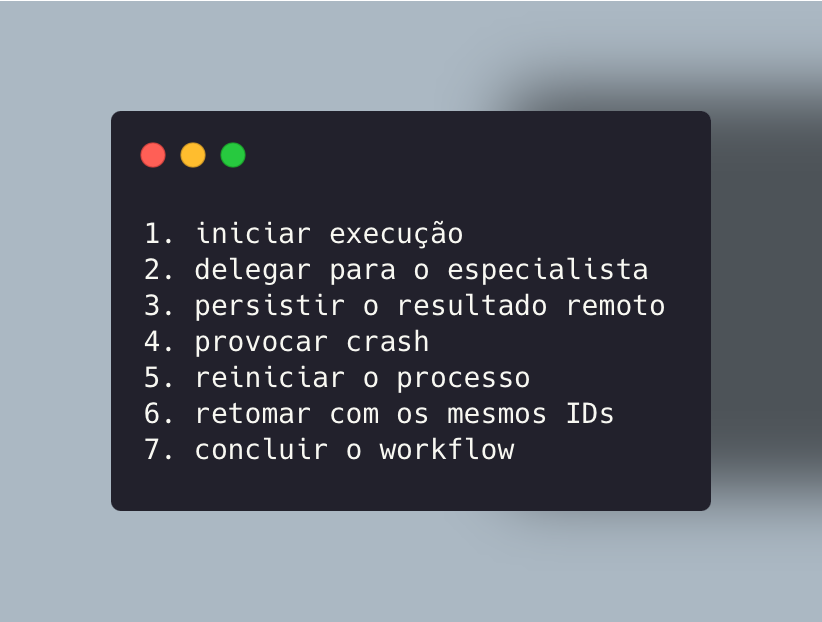
Uma forma simples de validar essa arquitetura é provocar a falha no ponto mais desconfortável: depois de o especialista concluir a tarefa e antes de o orquestrador avançar o próximo checkpoint.
 Ampliar ↗
Se a implementação estiver tratando aquela delegação de forma idempotente, a contagem de chamadas ao especialista permanece em uma. Quando ela sobe para duas, o teste revelou que alguma fronteira perdeu a identidade ou o resultado da operação anterior.
Esse é um dos motivos pelos quais, ao ouvir que um agente “esqueceu” uma conversa, hoje eu começo pelo caminho da requisição: qual conversation_id chegou, qual thread_id foi usado, qual session_id foi reaberta, qual execução estava em andamento e qual delegação foi retomada. Em muitos casos, o contexto nunca foi perdido pelo modelo; a aplicação simplesmente deixou de apontar para o mesmo estado persistido.