(Continuação do post anterior. Se quiser o contexto completo, começa por lá.)
Esses dias falei sobre como o Redis Stack virou minha camada de retrieval e análise determinística. Hoje quero me aprofundar no que, na prática, mais impactou performance e custo: a decisão de como modelar os documentos.
O tema parece simples, é só colocar tudo num JSON e indexar. Mas quando o volume cresce e o LLM começa a consumir o resultado e se perder, você descobre que a decisão de modelagem é tão importante quanto a escolha do banco.
Para evitar problemas de ética trabalhista, vou continuar usando como exemplo um domínio que acredito que muitos desenvolvedores já tocou: catálogo de produtos de e-commerce.
O problema concreto#
Imagine um assistente conversacional que responde perguntas como:
"Tem tênis masculino até R$ 300 com frete grátis e estoque disponível?" "Me fala mais sobre esse modelo de tênis que você acabou de me mostrar." "Quero ver os 5 produtos mais bem avaliados de fone bluetooth."
Três perguntas diferentes. Três padrões de acesso radicalmente diferentes. E o LLM, mesmo sendo inteligente, alucina quando você joga 80 campos num contexto que precisava de 5.
Os três modelos que testei#
1. FAT - Guarda tudo, indexa tudo#
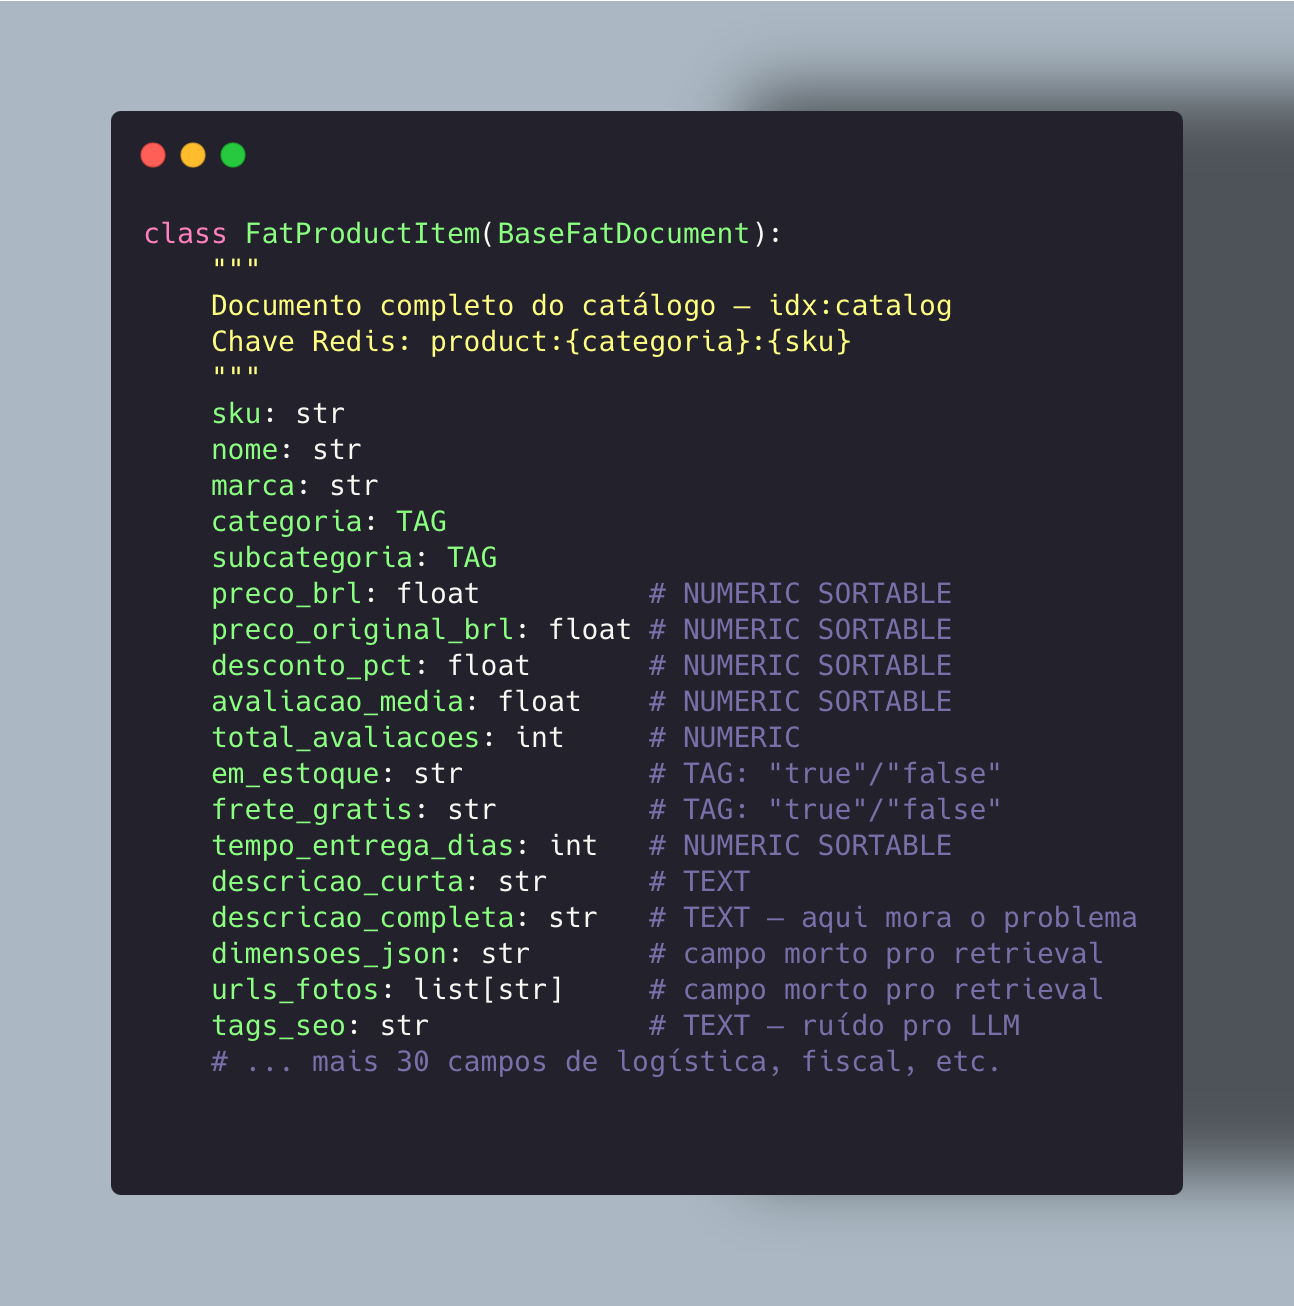
A tentação inicial: um documento enorme com cada campo que a API de catálogo devolve.
 Ampliar ↗
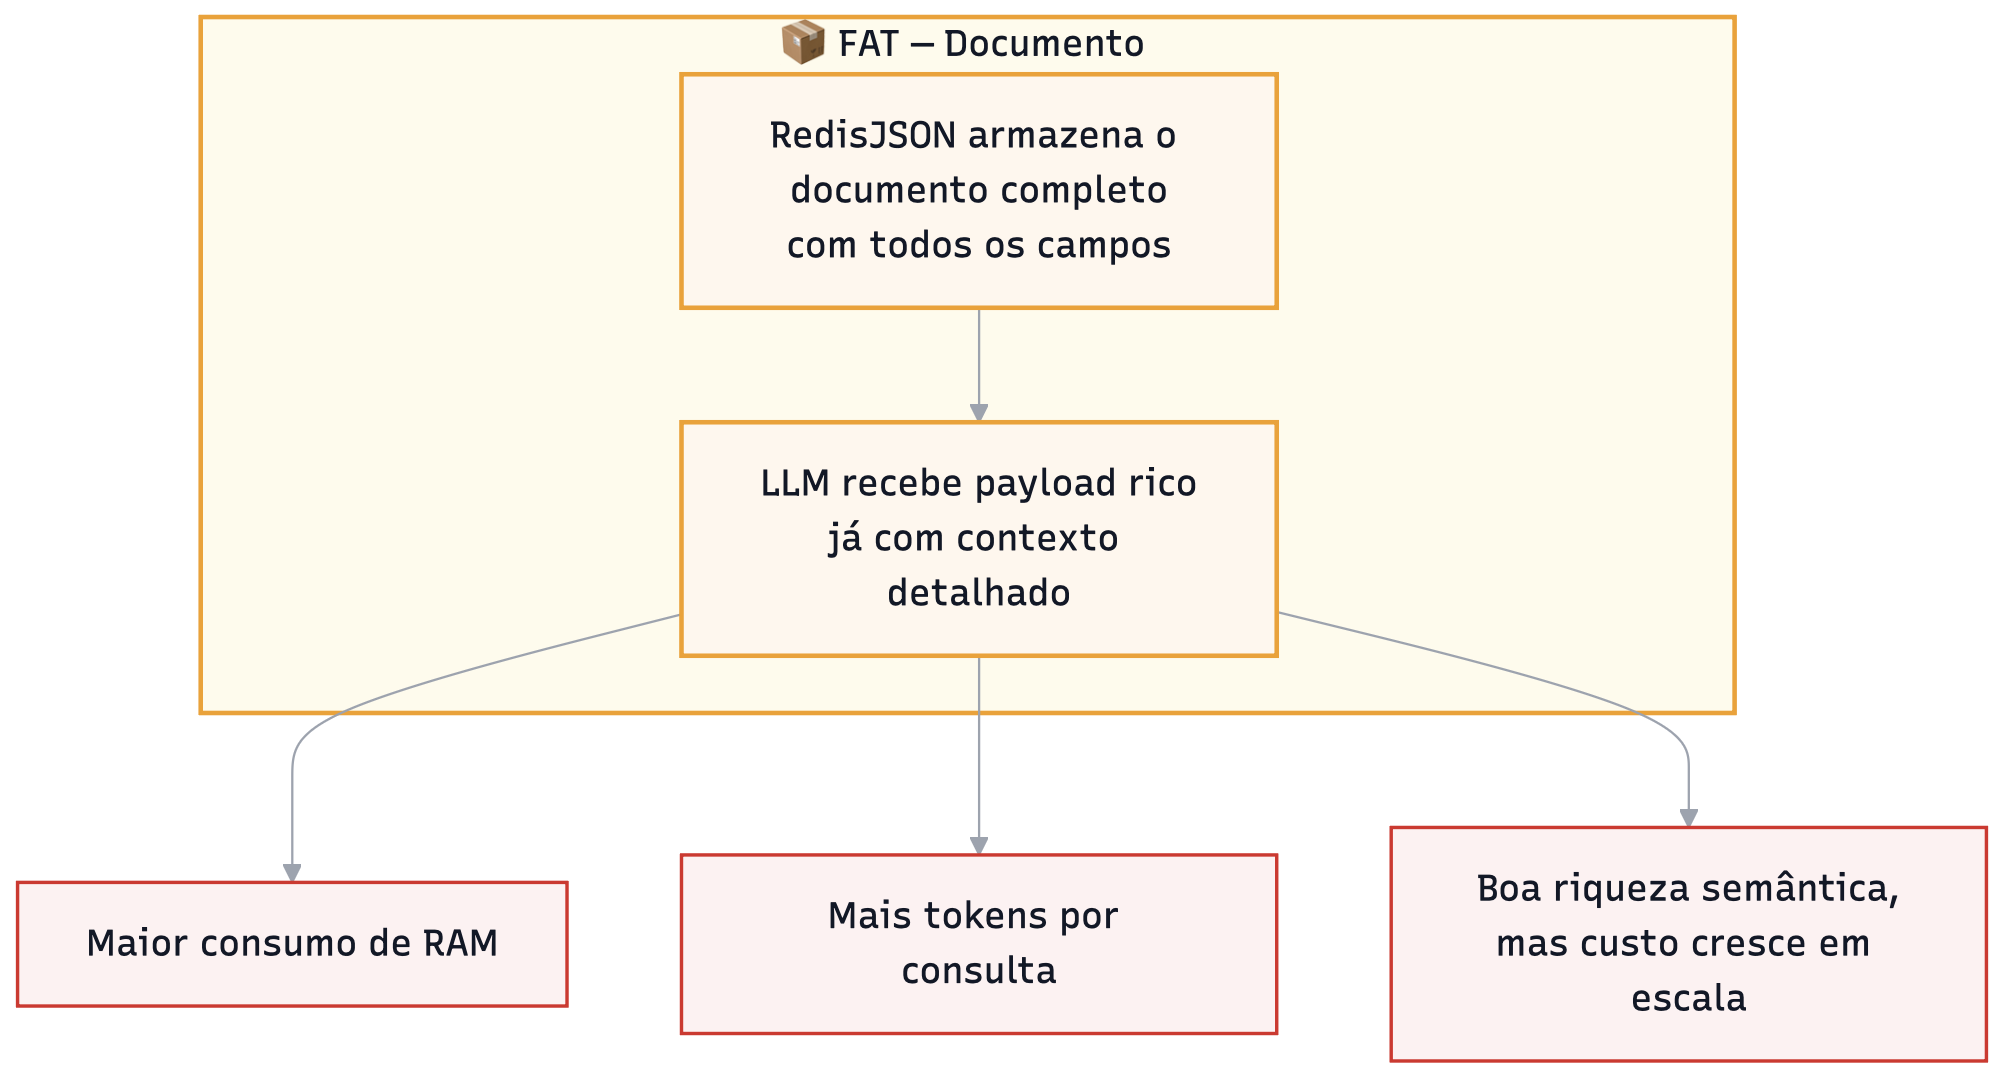
O que acontece:
RAM explode: cada documento com mais de 60 campos indexados = índice pesado
FT.SEARCH devolve tudo -> você passa o campo
descricao_completade 800 tokens pro LLMO modelo alucina porque se perde no ruído
Custo de LLM sobe sem entregar qualidade melhor
 Ampliar ↗
2. SLIM - Só o essencial no retrieval#
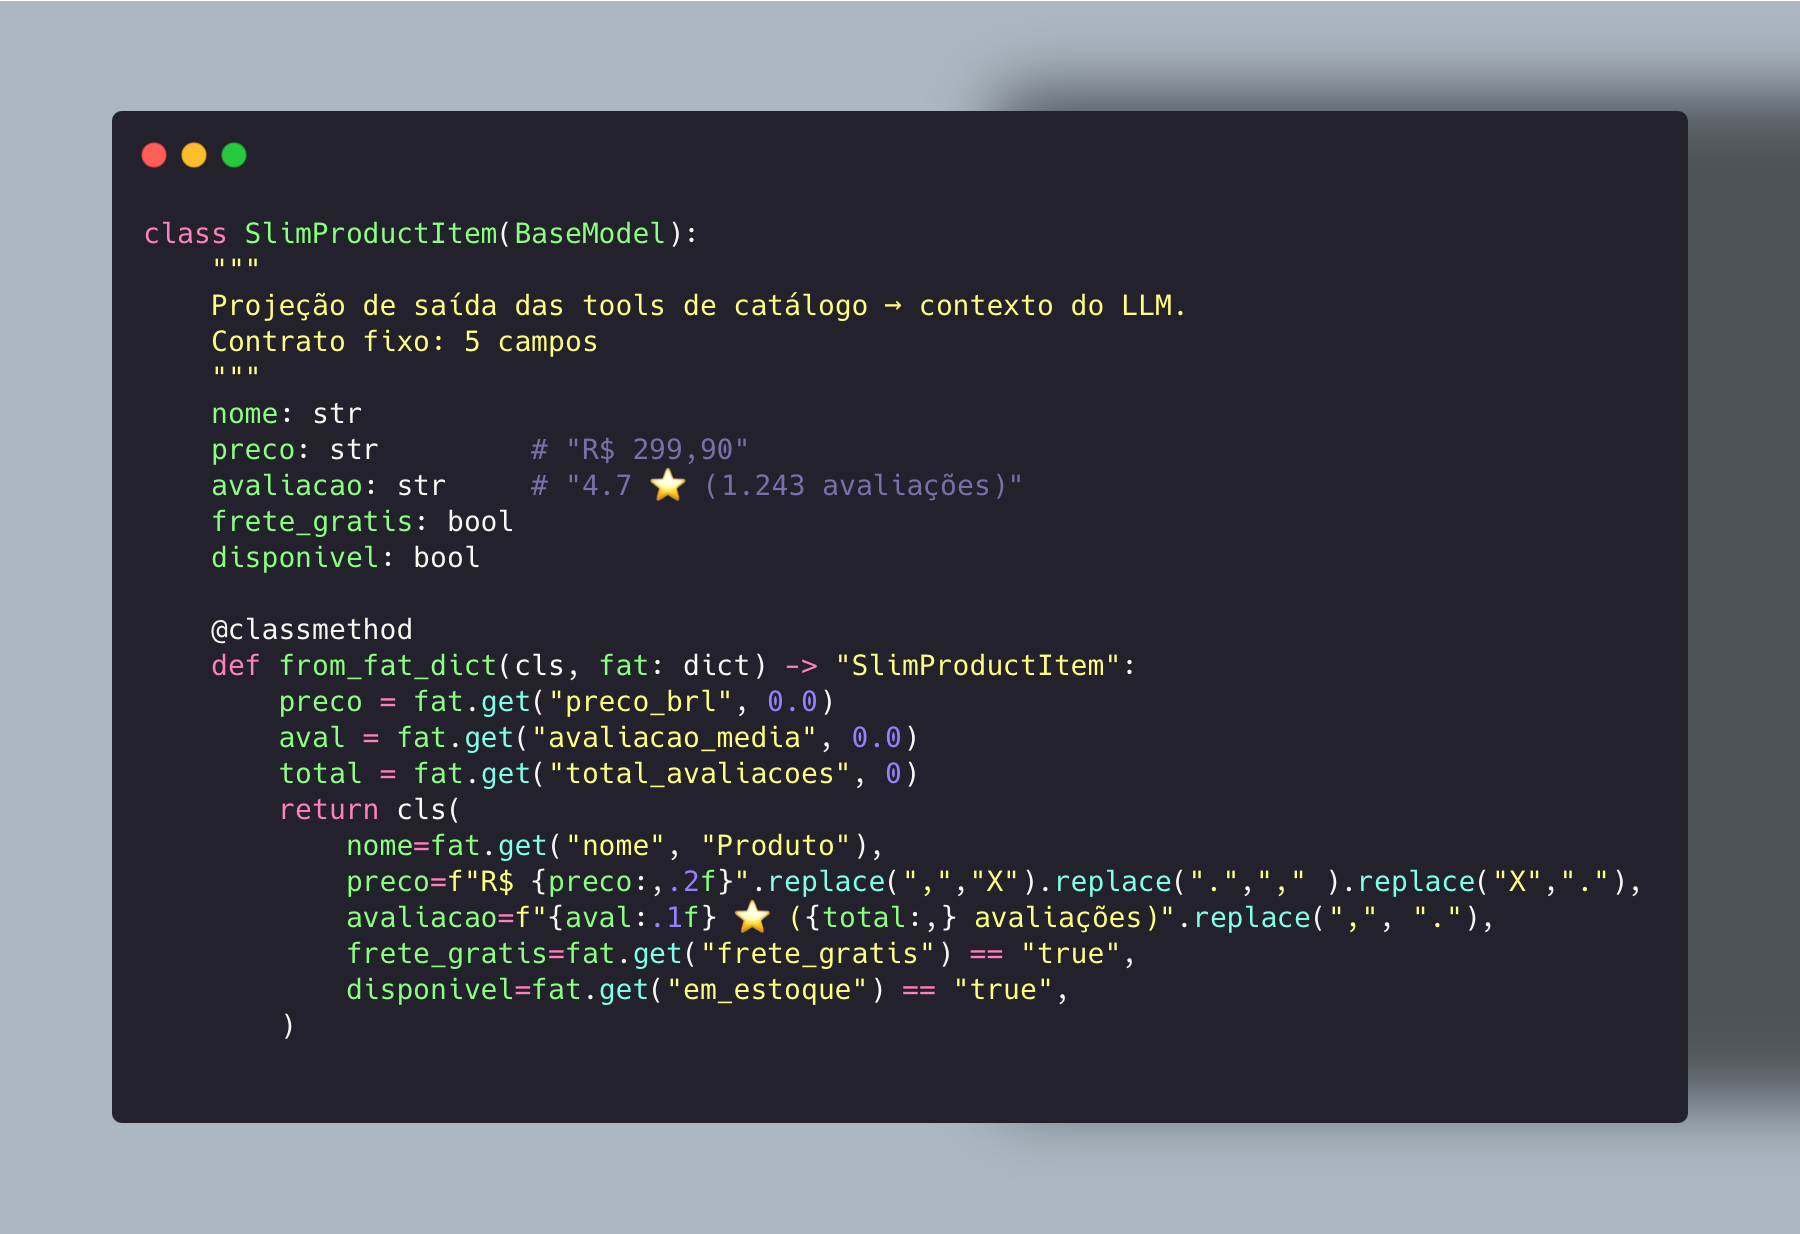
A segunda tentativa: indexar e retornar apenas o que o agente de busca precisa:
 Ampliar ↗
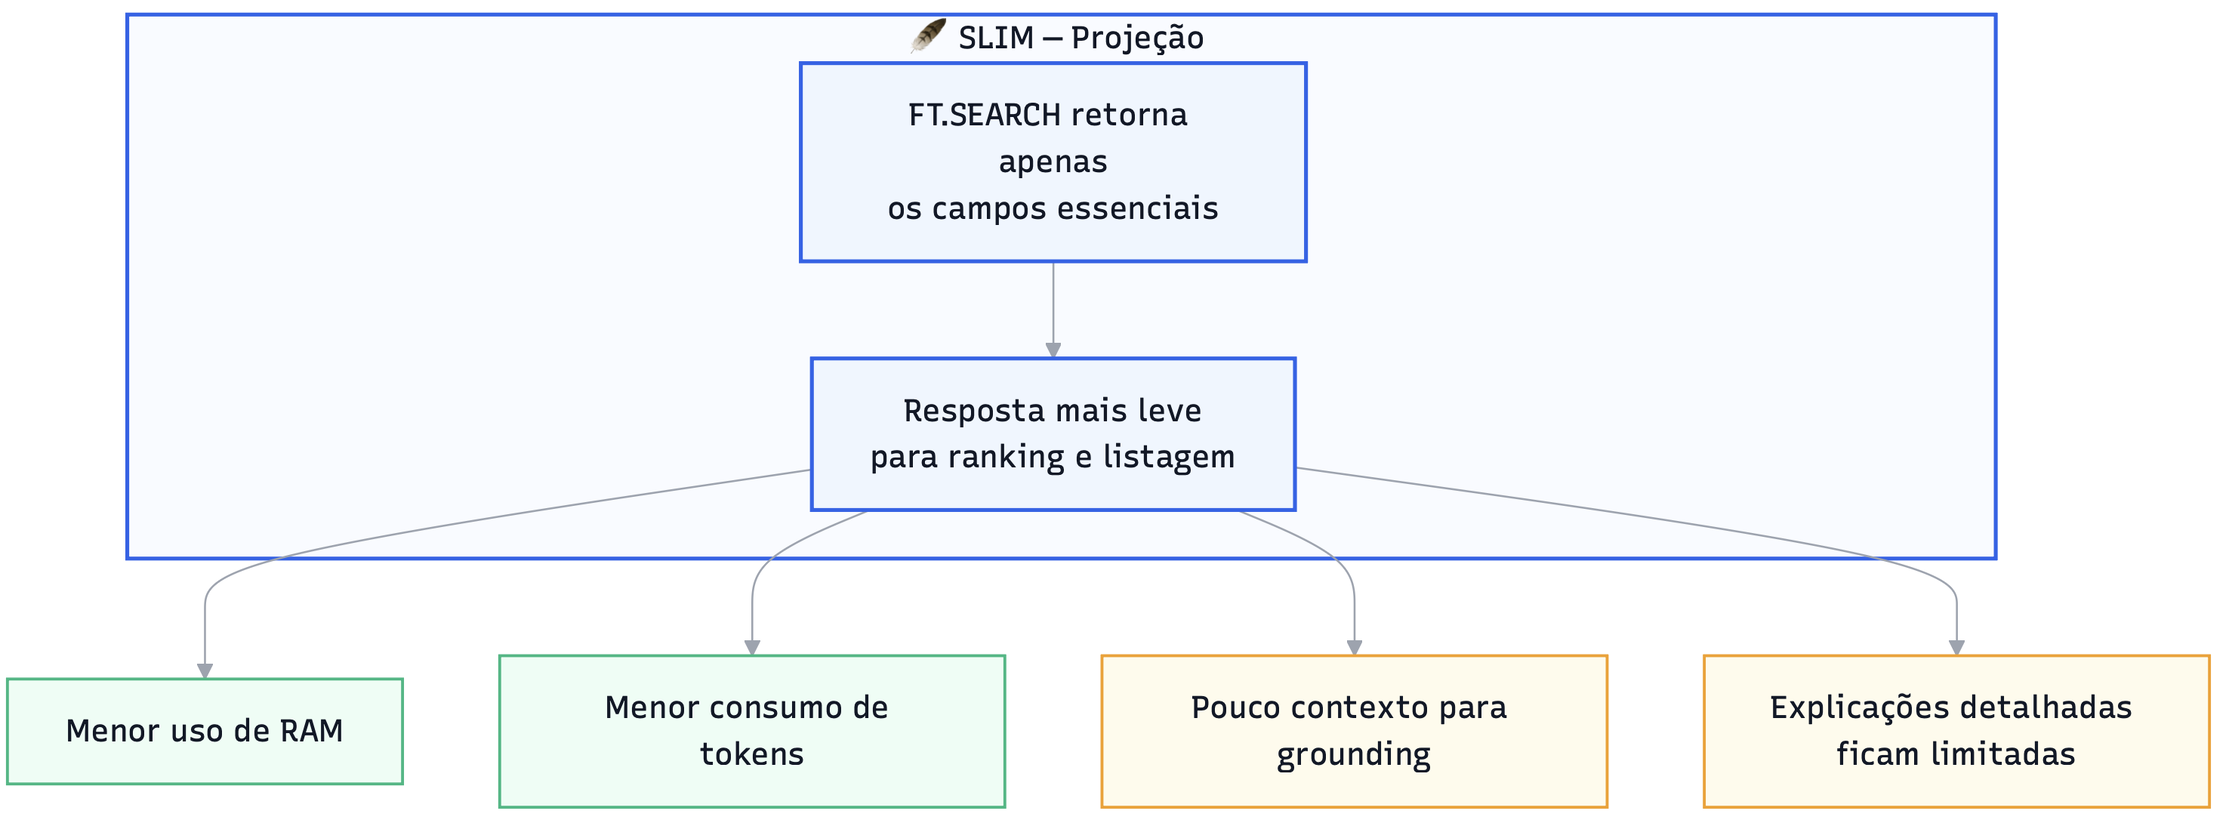
O problema: quando o usuário pergunta "me fala a política de troca desse produto" ou "qual o peso para calcular o frete?", você não tem os campos. Aí vem a tentação de ampliar o SLIM, e você volta pro FAT.
 Ampliar ↗
3. HÍBRIDO - O padrão que ficou#
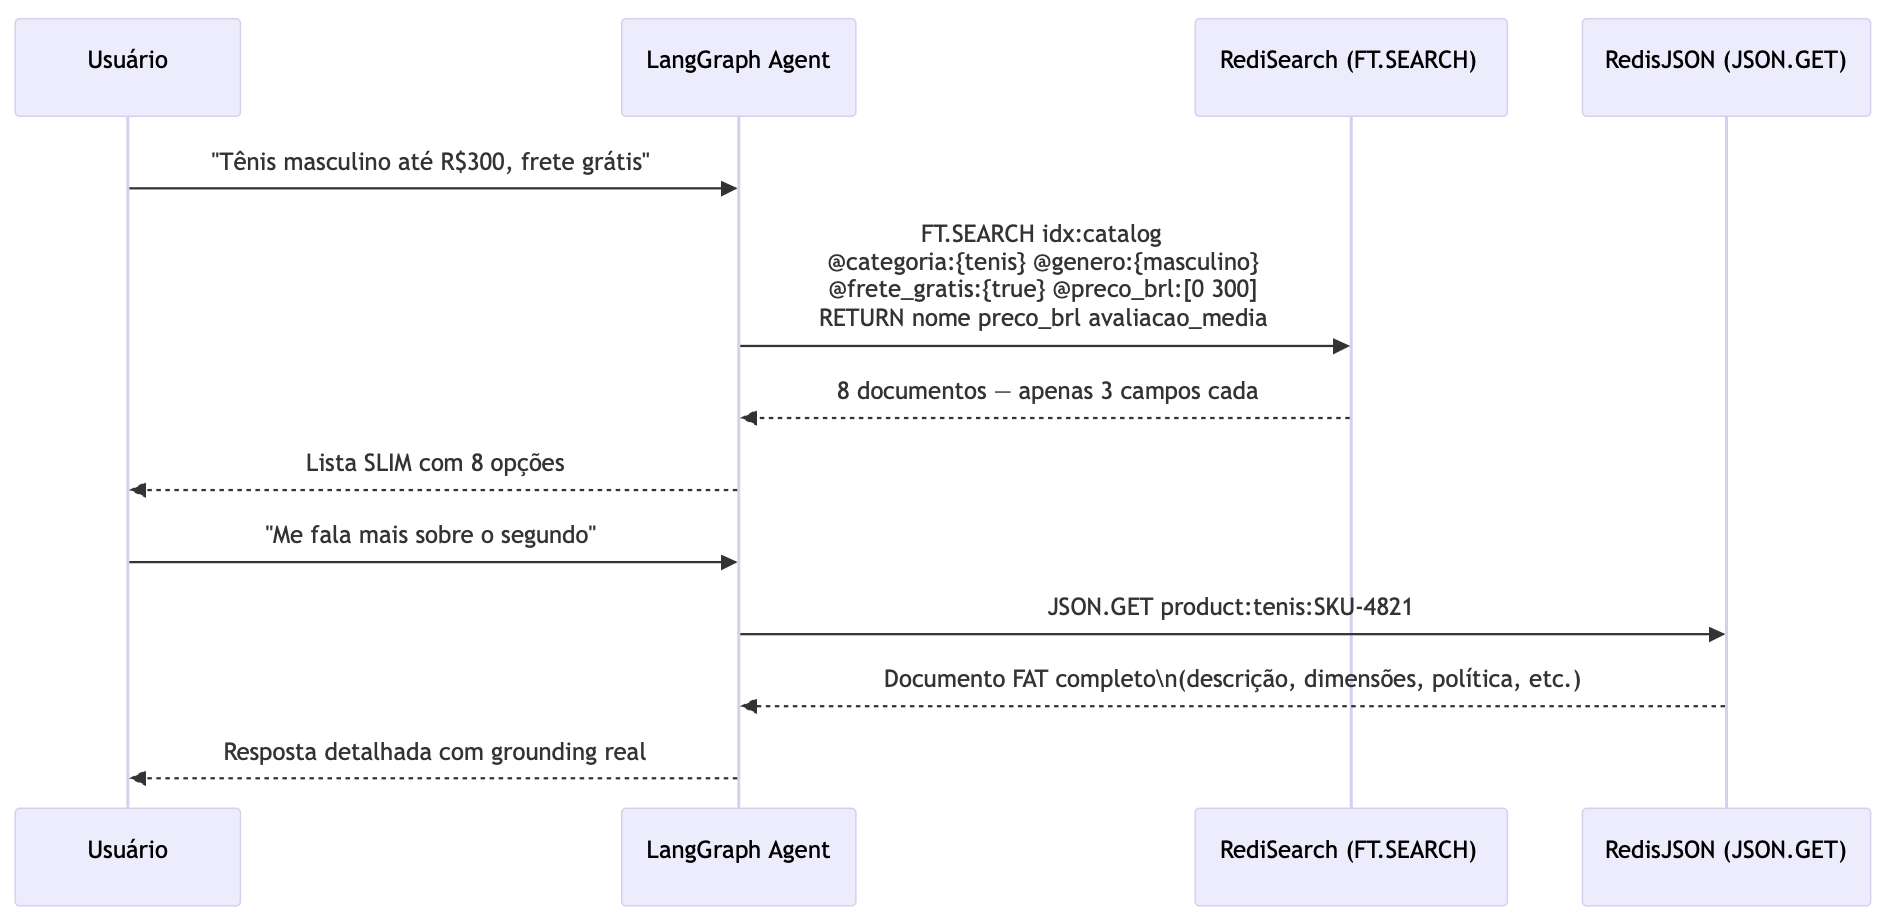
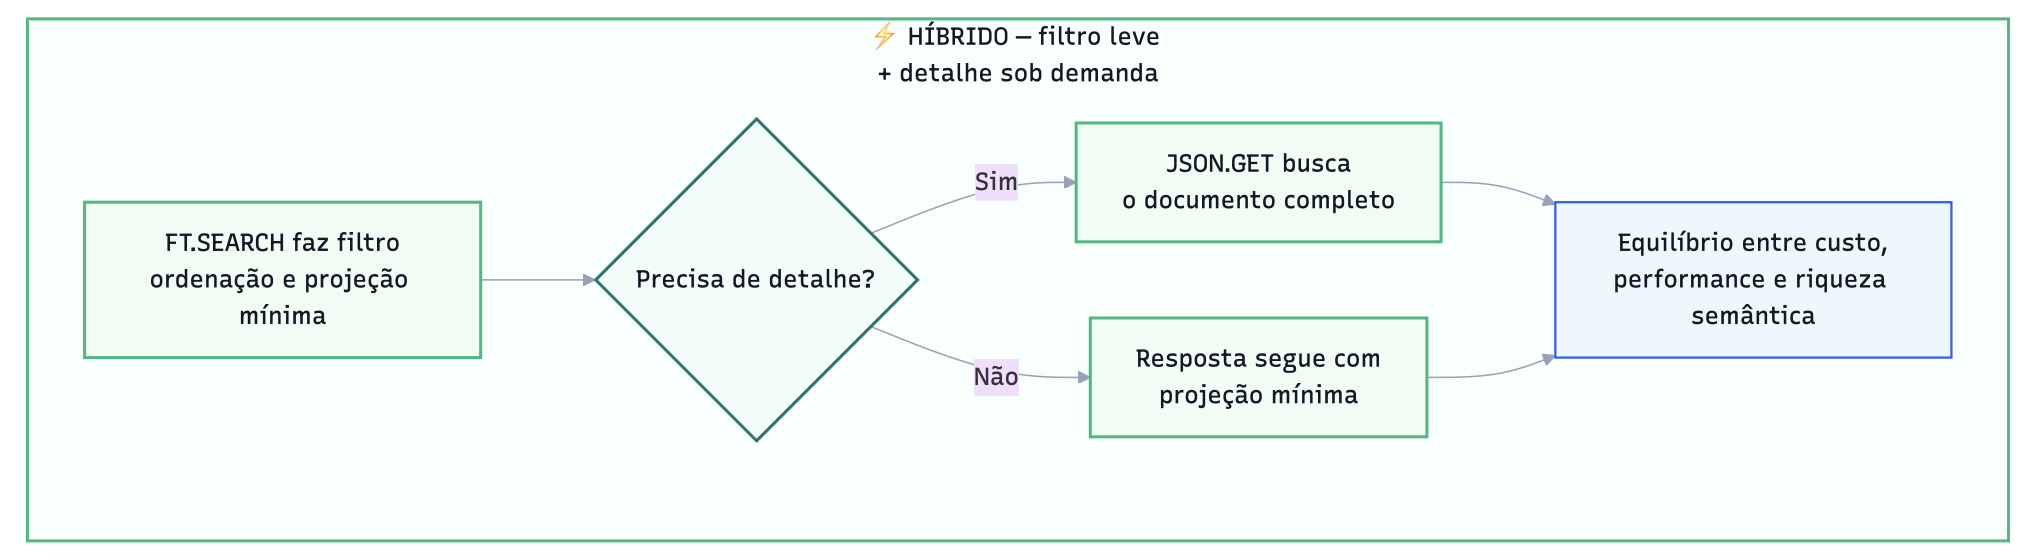
A sacada: separar a fase de busca da fase de detalhamento:
 Ampliar ↗
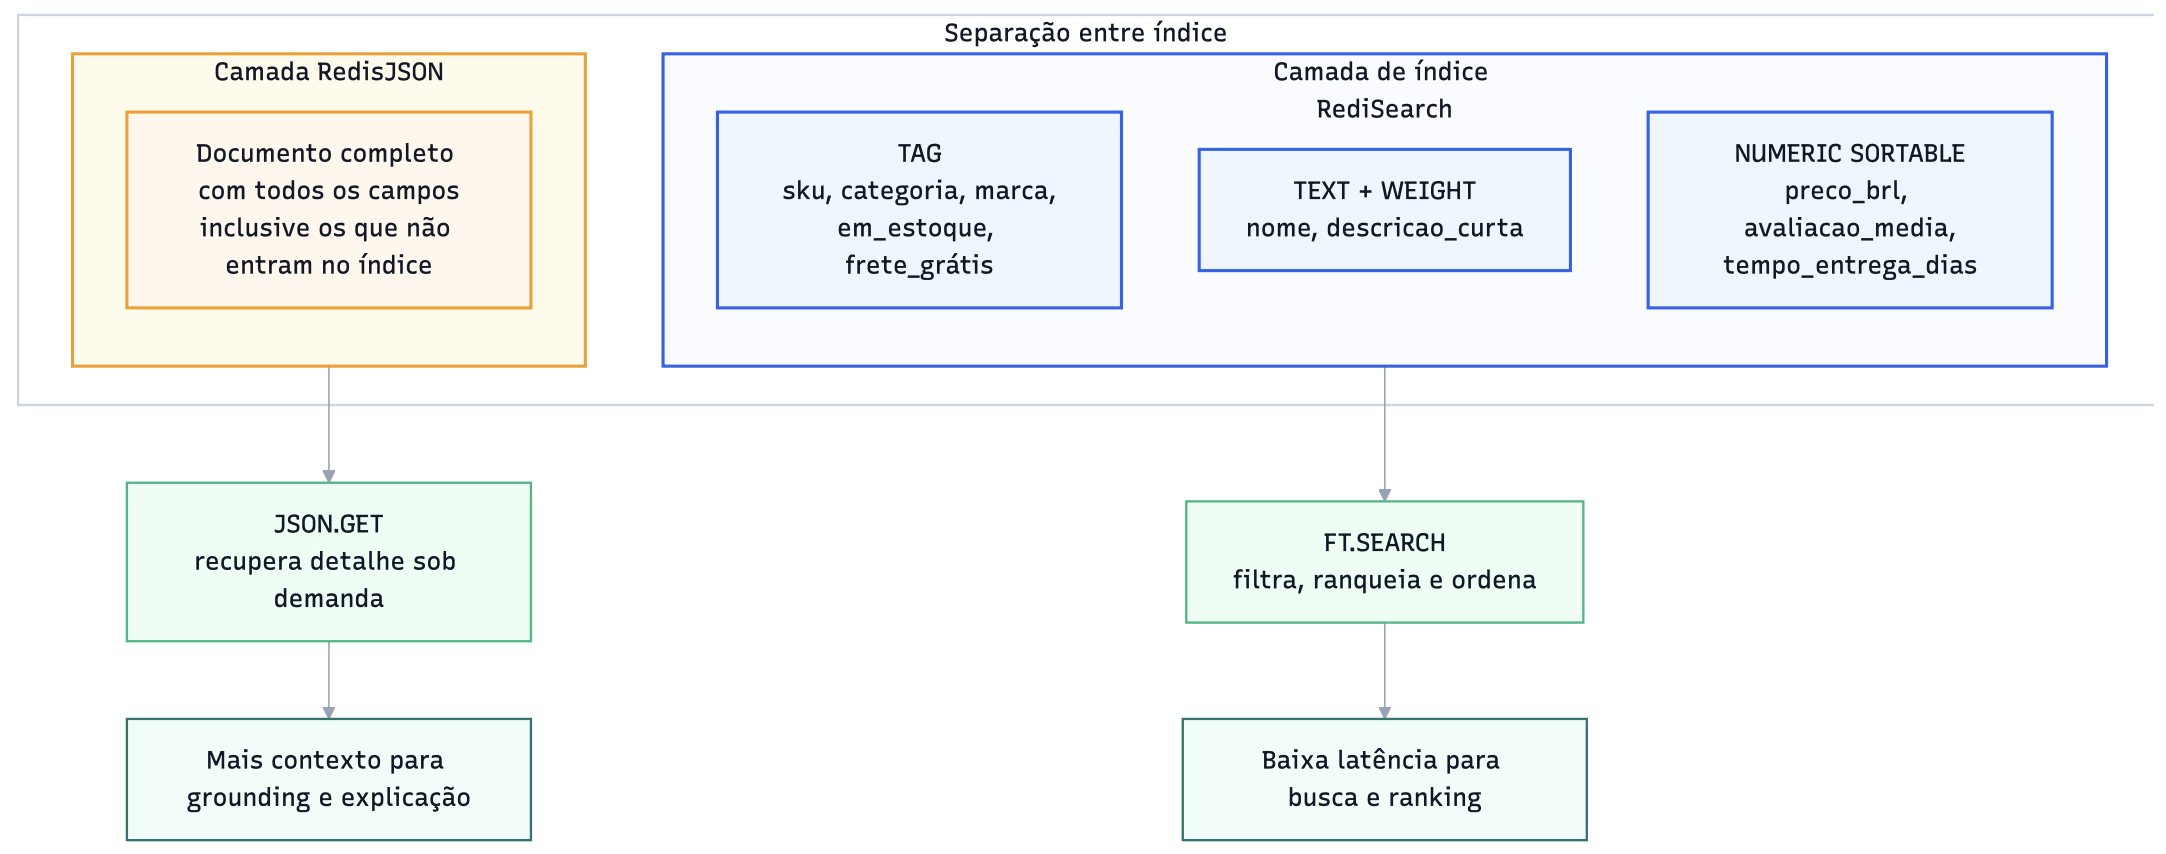
O RediSearch filtra e ordena usando os campos indexados. O JSON.GET recupera o documento completo só quando o usuário quer o detalhe de um item específico.
 Ampliar ↗
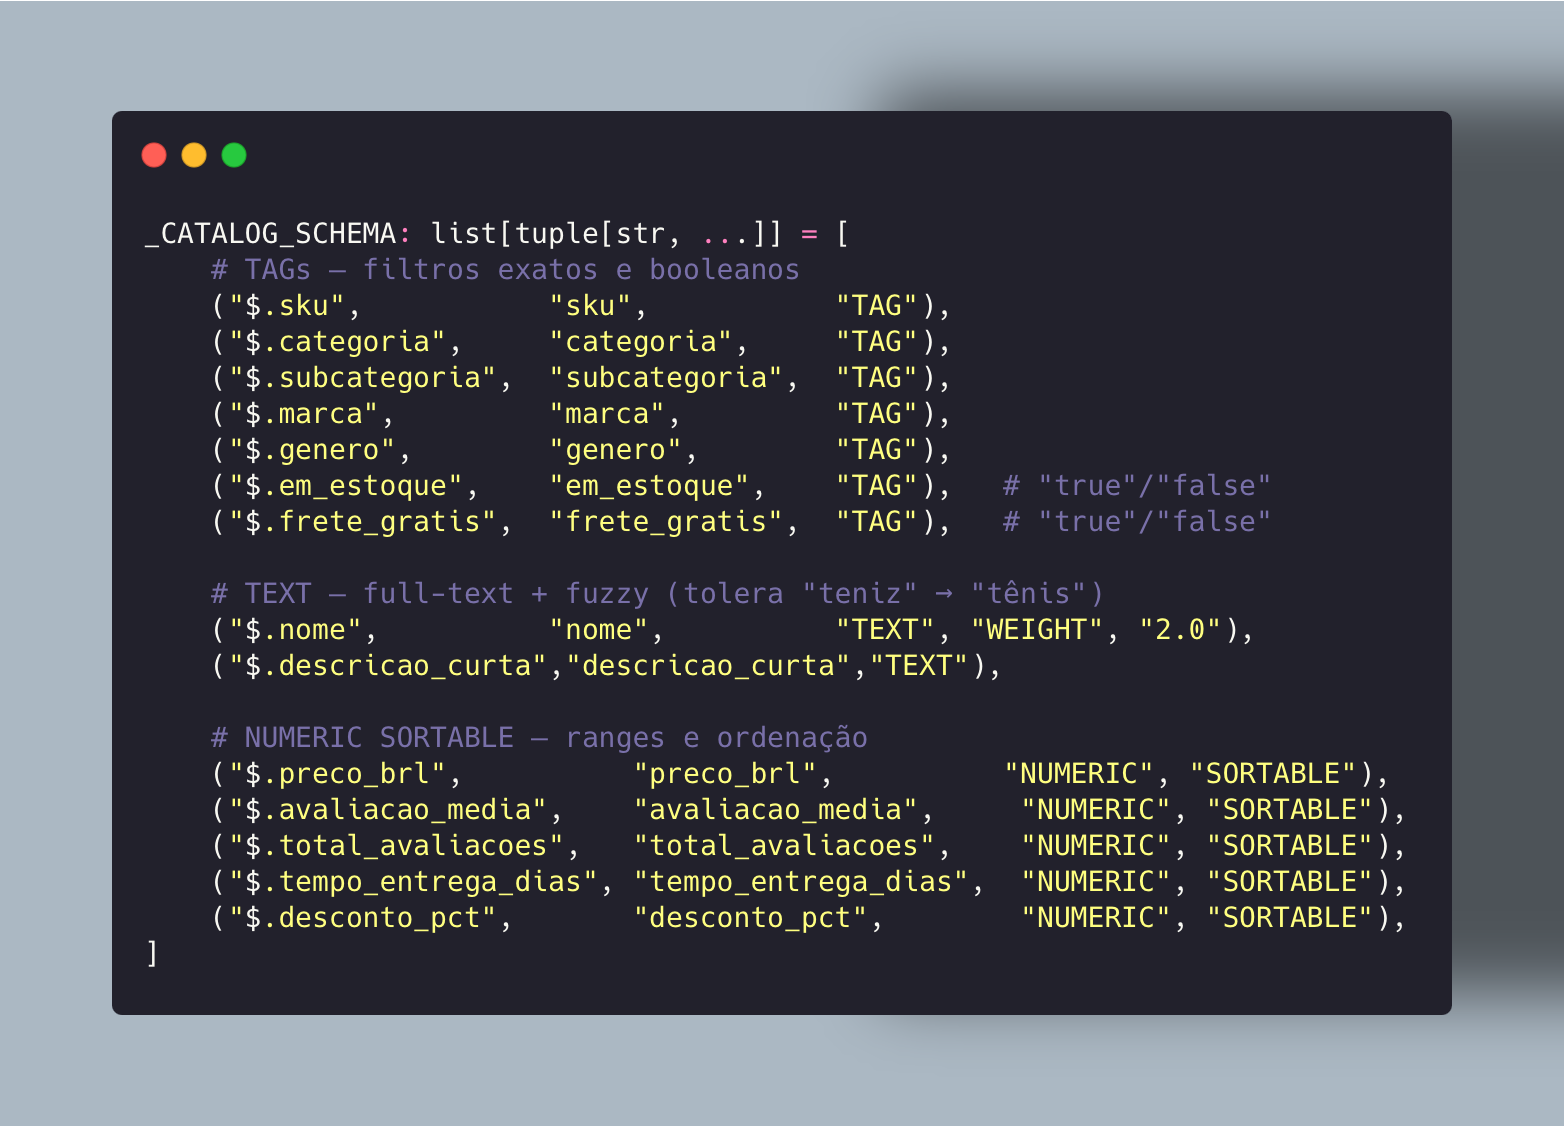
O schema que sustenta o híbrido#
 Ampliar ↗
 Ampliar ↗
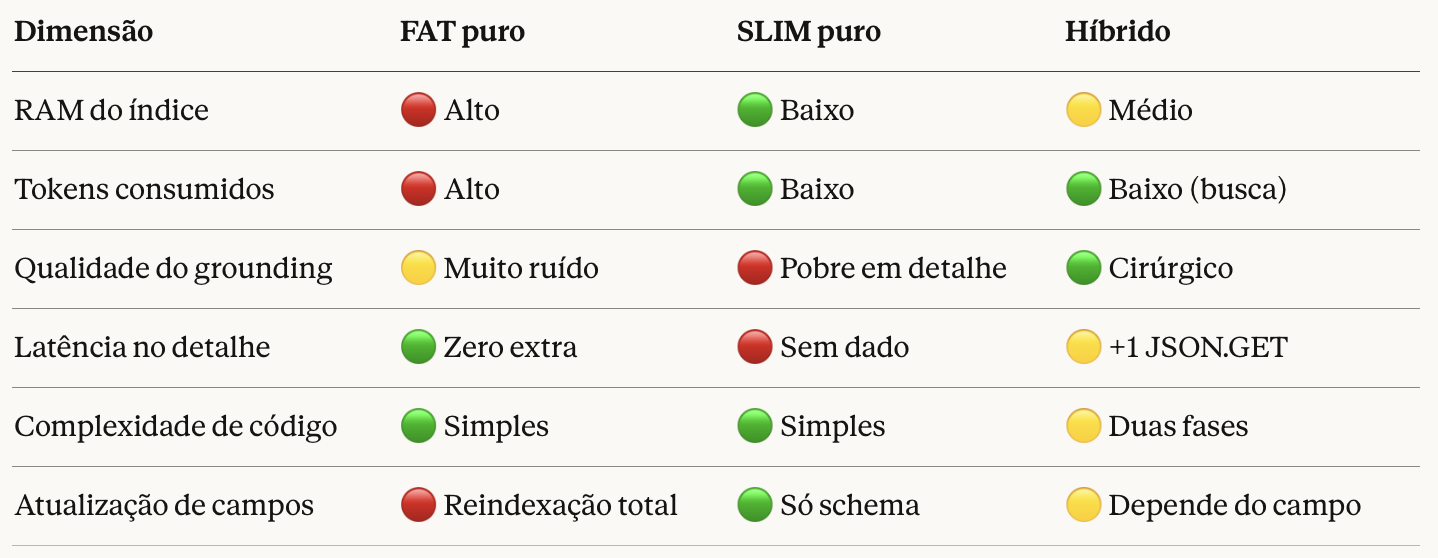
Os trade-offs de cada modelo:#
 Ampliar ↗
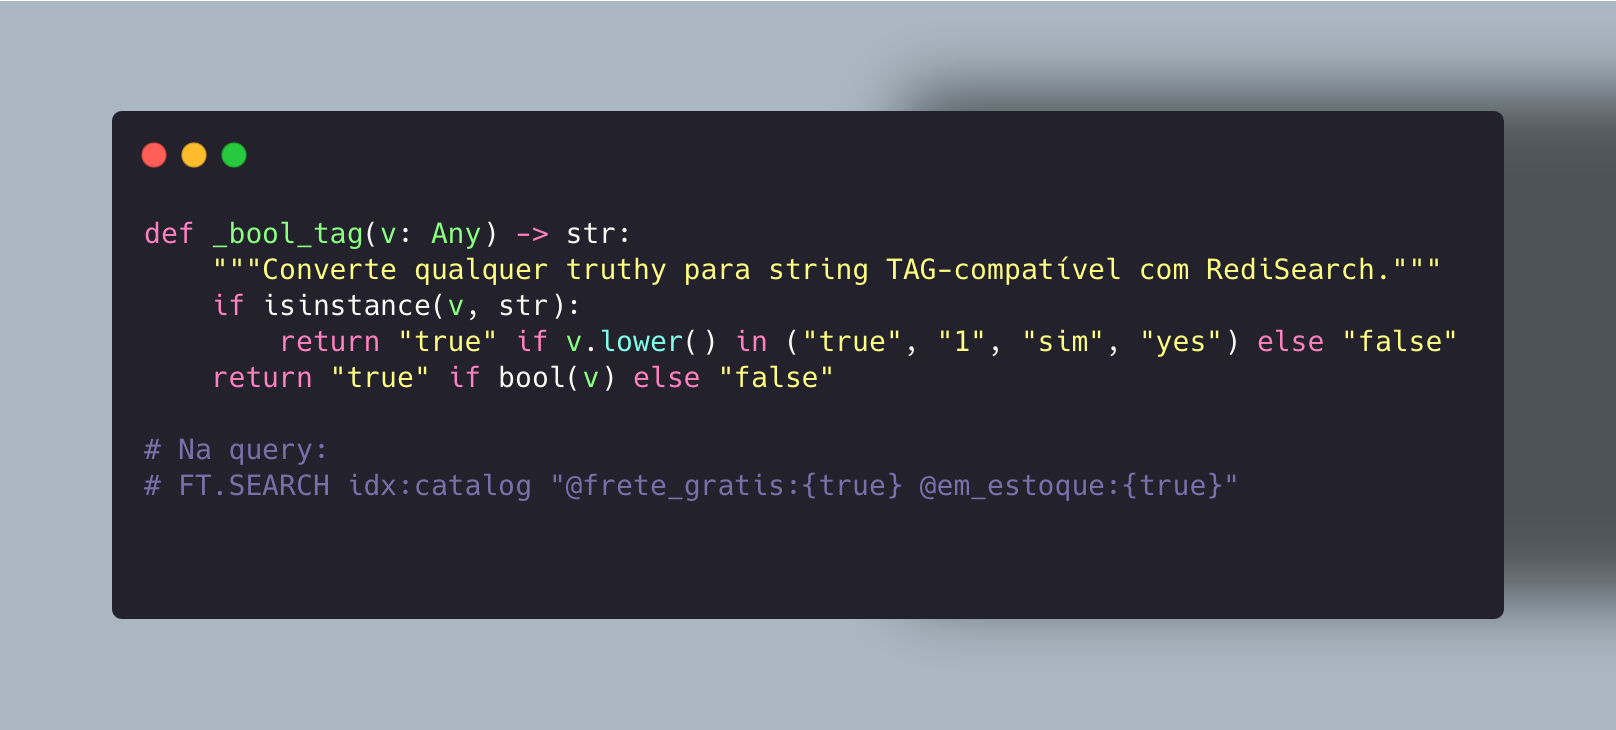
O RediSearch não tem tipo nativo BOOL. Então aprendi na marra: todo campo booleano vira TAG com string "true"/"false".
 Ampliar ↗
Parece trivial. Mas quando você recebe True, 1, "sim", "TRUE" do upstream (APIs de catálogo são cheias disso), sem esse conversor o índice fica inconsistente e a busca retorna zero resultados, sem erro explícito.
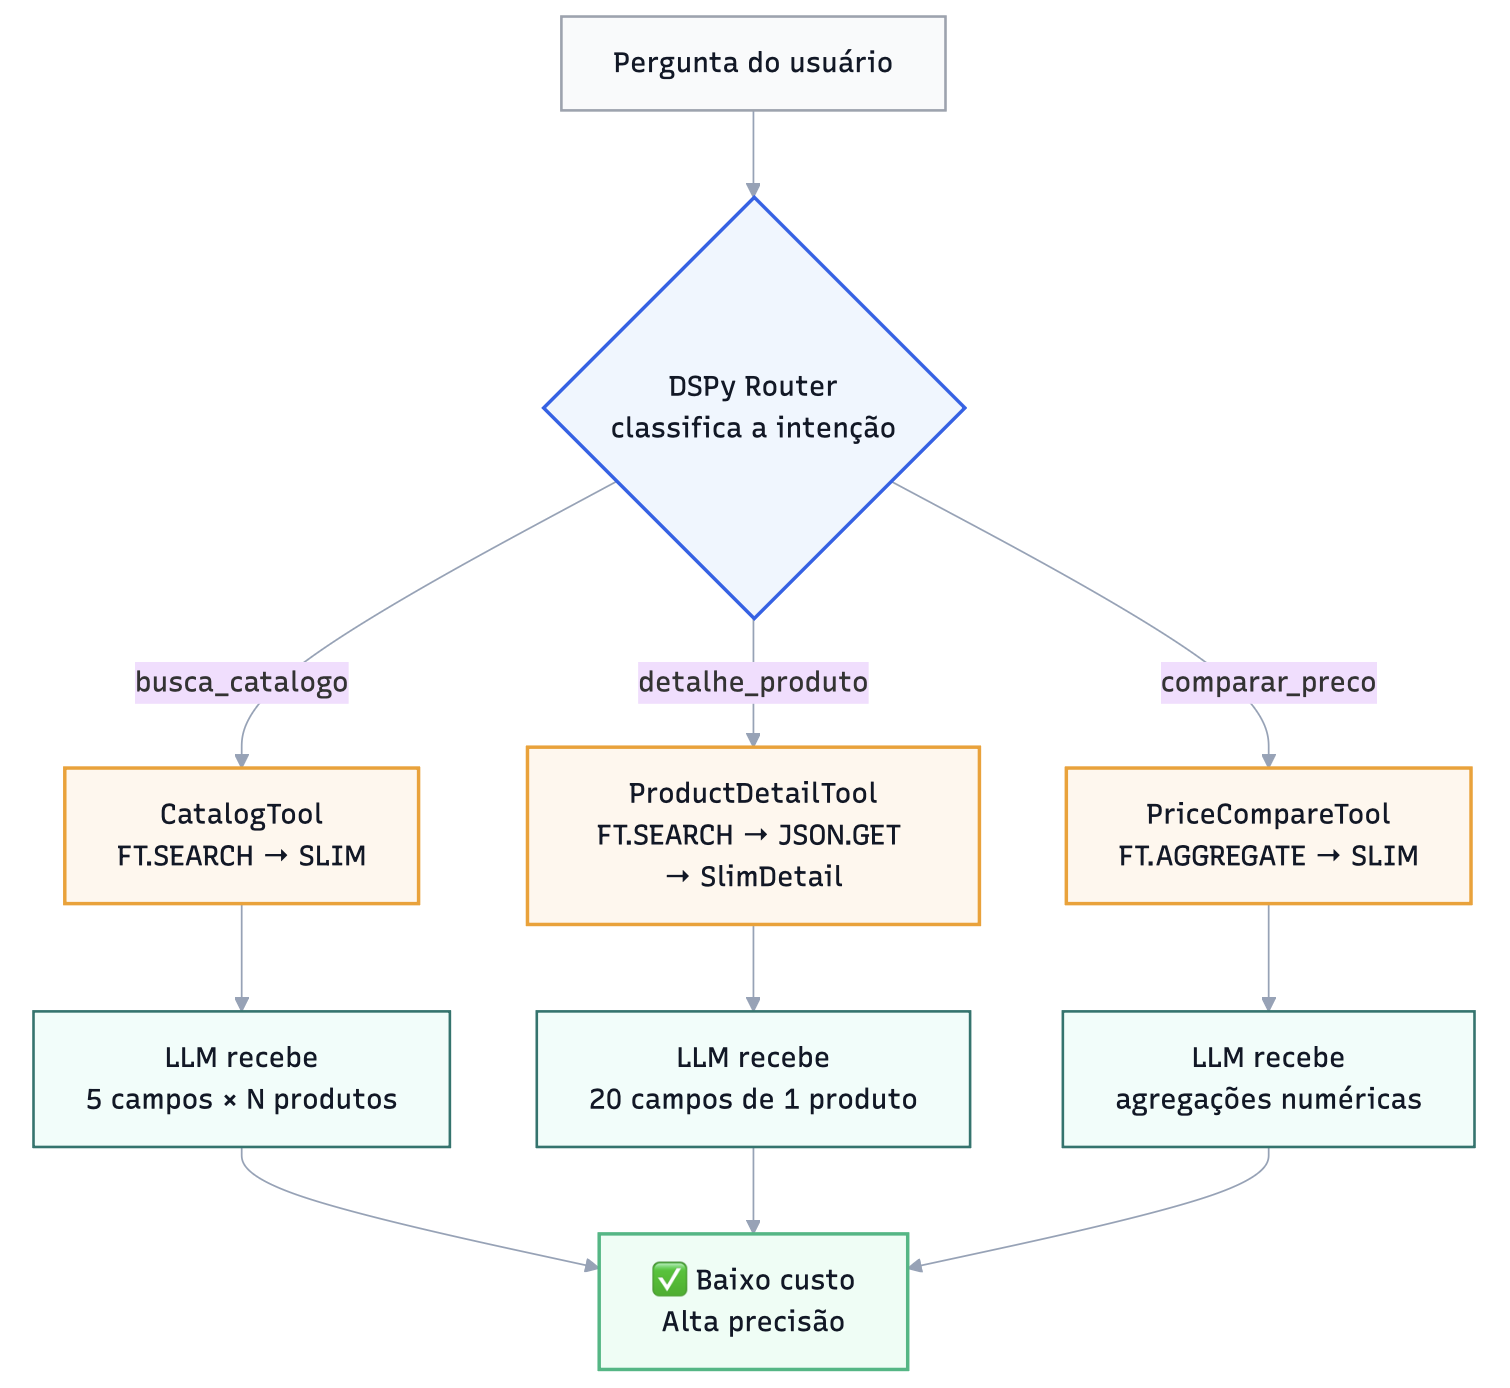
O que o LangGraph ganhou com isso#
 Ampliar ↗
Cada tool sabe exatamente o quanto de dado o LLM precisa para aquela intenção específica. Isso é o núcleo do padrão: o modelo de dados serve a intenção, não o contrário.
O que tirei de aprendizado#
Modelagem Fat/Slim/Híbrido no Redis não é uma escolha técnica, é uma decisão de contrato entre o retrieval e o LLM.
Se você joga dados demais, o modelo se perde. Se joga de menos, ele alucina pra preencher lacunas. O ponto ótimo é: o mínimo necessário para que o modelo responda com segurança, com um escape para o detalhe completo quando a intenção exige.
No meu caso, ficou assim:
Busca no catálogo -> Slim (5 campos, N produtos, contexto curto)
Detalhe de produto -> JSON.GET do Fat -> formatado como SlimDetail (20 campos, 1 produto, contexto médio)
Agregações -> FT.AGGREGATE diretamente, sem passar nenhum documento pro LLM
Cada padrão tem seu custo. Entender qual usar em qual fluxo foi o que realmente mudou a conta do projeto.
O próximo post será como o DSPy entrou nisso pra classificar intenção e rotear para a tool certa, sem regras hardcoded, com exemplos supervisionados e otimização automática do prompt.