Nos últimos meses publiquei posts separados sobre cada componente do assistente conversacional de e-commerce: memória episódica, roteadores, DSPy, anáforas, Redis Stack, guardrails, observabilidade, QueryBuilder.
Esse post fecha o ciclo, mostrando o caminho completo de uma query: do texto que o usuário digitou até a resposta que ele recebe, passando por cada componente na ordem em que é executado.
Novamente vou usar como exemplo o domínio e-commerce. A arquitetura é a mesma que documentei ao longo da série.
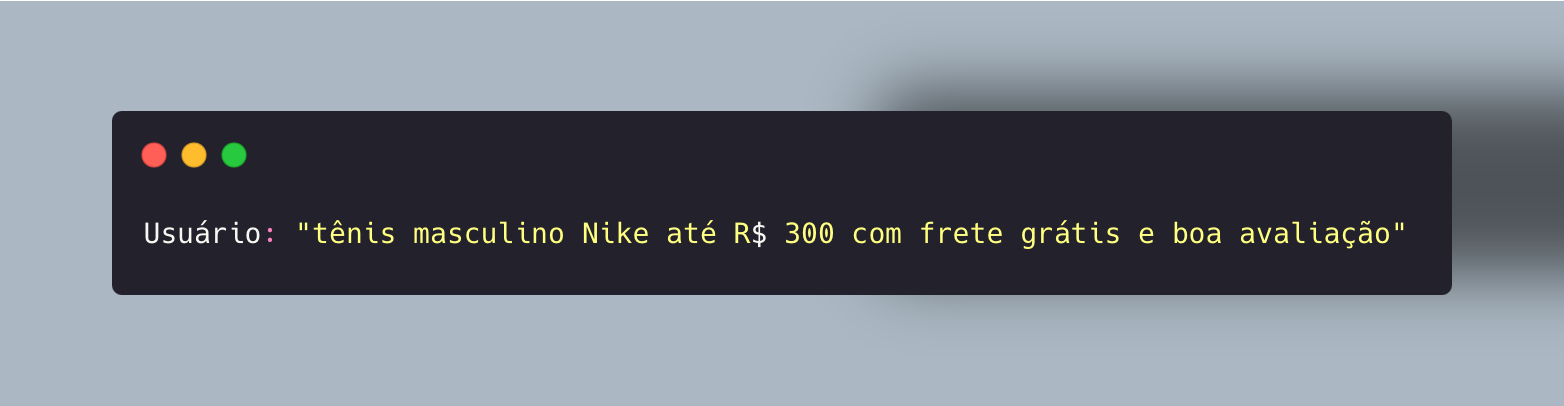
A query de exemplo#
 Ampliar ↗
Turno 2, numa sessão que já teve uma pergunta sobre tênis feminino no turno anterior.
Etapa 1 Supervisor: macro roteamento sem LLM#
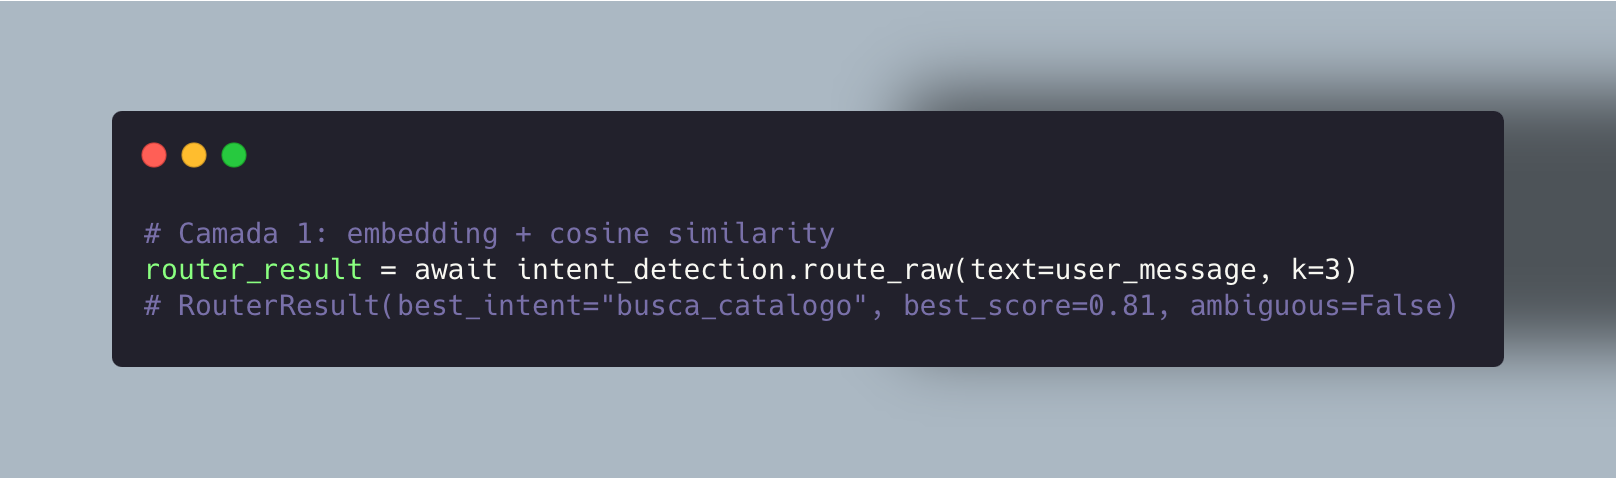
A mensagem chega no supervisor. Antes de qualquer LLM, o semantic router por embeddings classifica a macro-intent:
 Ampliar ↗
Score 0.81, acima do threshold de 0.72 para busca_catalogo, não ambíguo. O supervisor roteia para o subgrafo de busca de catálogo sem chamar nenhum LLM.
Latência desta etapa: ~35ms.
Etapa 2 Setup node: contexto de negócio em paralelo#
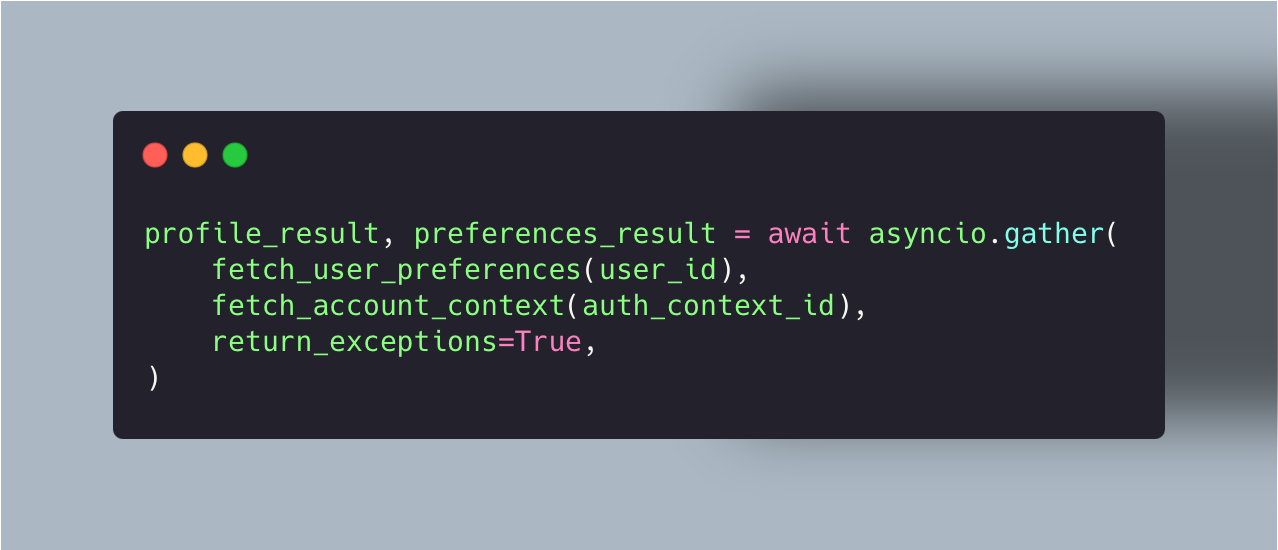
O subgrafo começa com o setup_node. Ele carrega em paralelo com asyncio.gather tudo que o subgrafo vai precisar:
 Ampliar ↗
Num sistema sequencial, essas duas chamadas seriam ~300ms cada. Em paralelo, ficam no tempo da mais lenta: ~320ms no P50.
O estado do grafo sai do setup com user_preferences, browsing_history_summary e account_context preenchidos. Se o cliente já comprou tênis antes, isso está no contexto quando o LLM gerar a resposta.
Latência desta etapa: ~320ms.
Etapa 3 Router node: anáfora + DSPy#
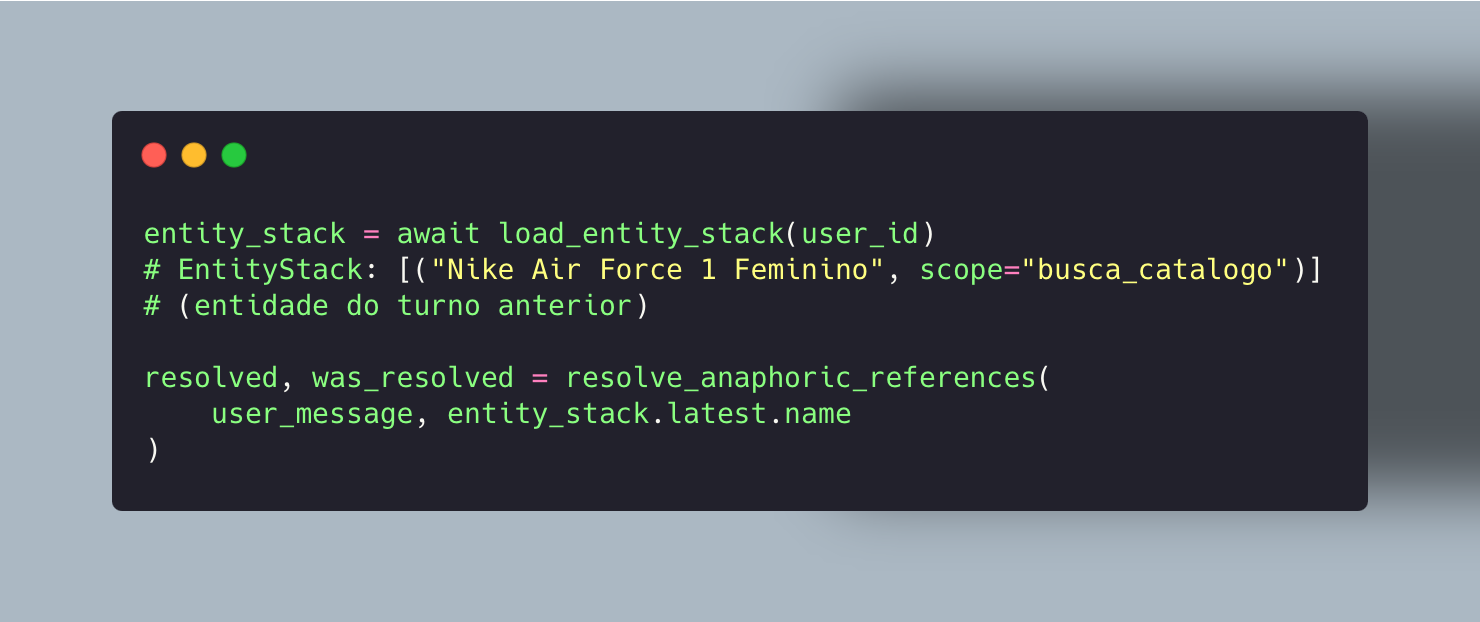
O router_node é onde a decisão cognitiva acontece. Mas antes de chegar no DSPy, o resolver de anáforas verifica se a mensagem tem referências implícitas:
 Ampliar ↗
"tênis masculino Nike até R$ 300 com frete grátis e boa avaliação" não tem pronomes, não tem continuação implícita. O resolver não modifica a mensagem.
Se o usuário tivesse dito "e esse com frete grátis?", o resolver teria expandido para "e o Nike Air Force 1 Feminino com frete grátis?" antes de passar para o DSPy.
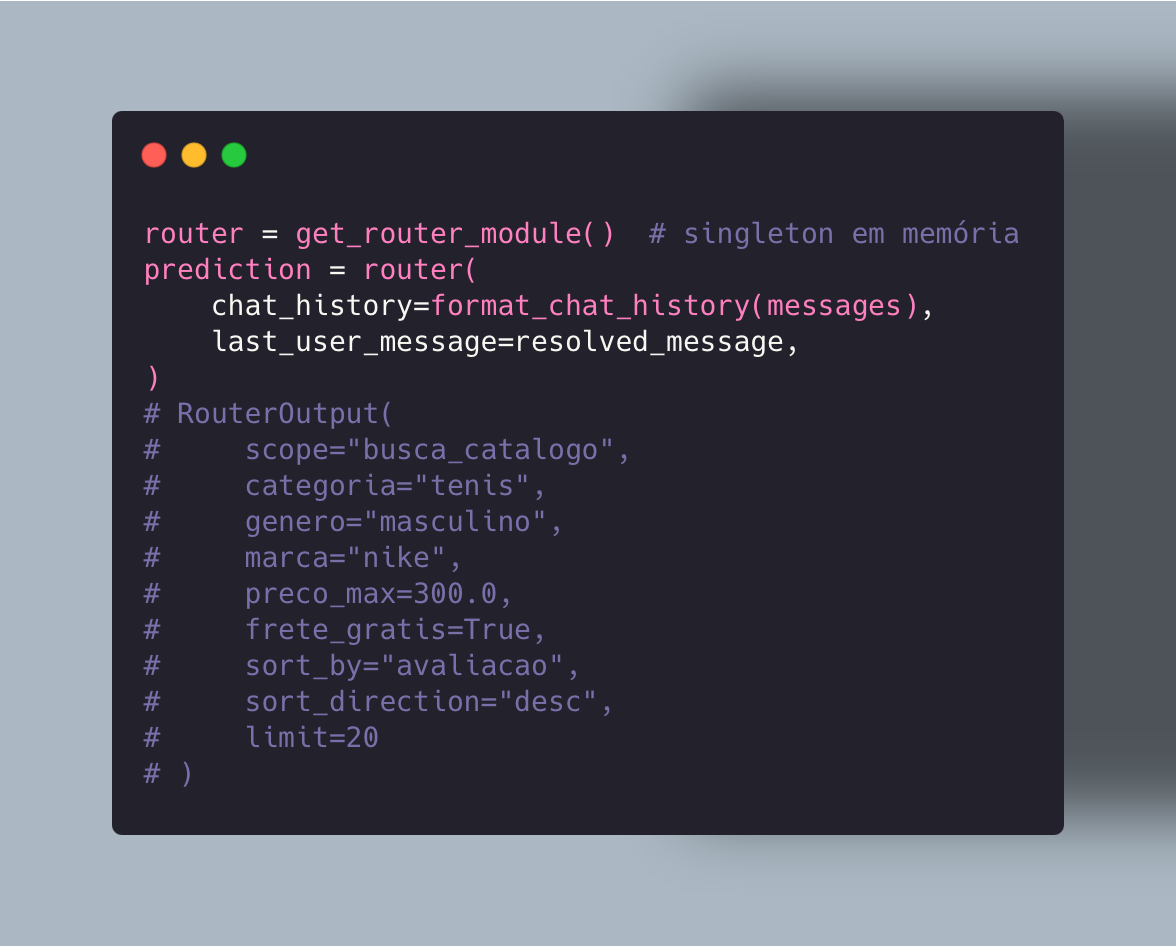
Agora o DSPy:
 Ampliar ↗
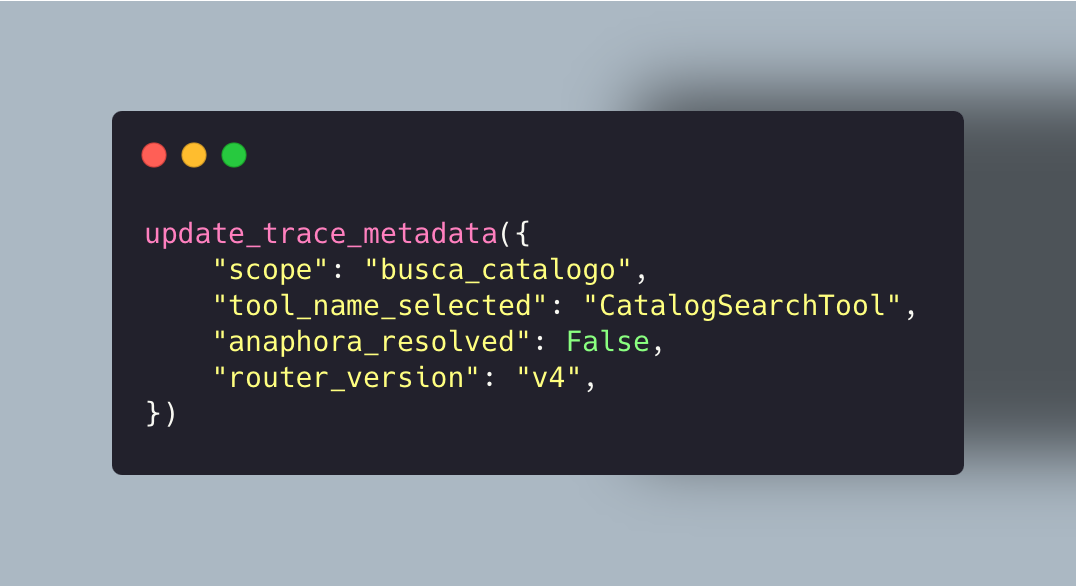
O scope é busca_catalogo, o router_node seleciona a CatalogSearchTool e constrói os argumentos a partir do RouterOutput:
 Ampliar ↗
Latência desta etapa: ~2.1s (embedding da query + LLM DSPy).
Etapa 4 Tools node: FT.SEARCH no Redis Stack#
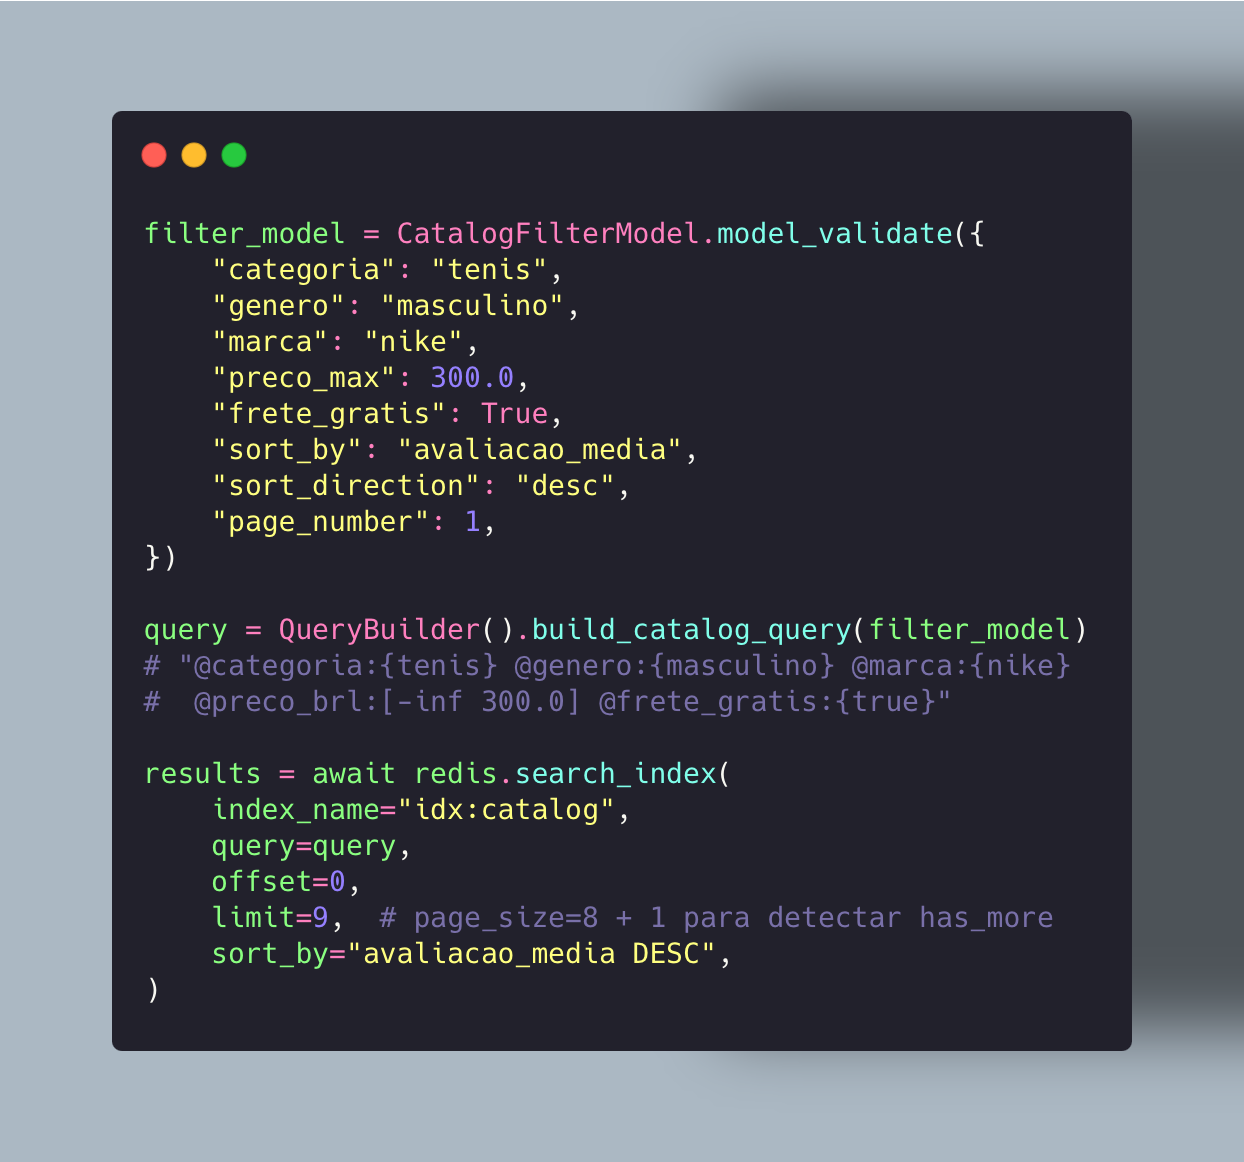
A tool recebe os argumentos do RouterOutput e chama o QueryBuilder:
 Ampliar ↗
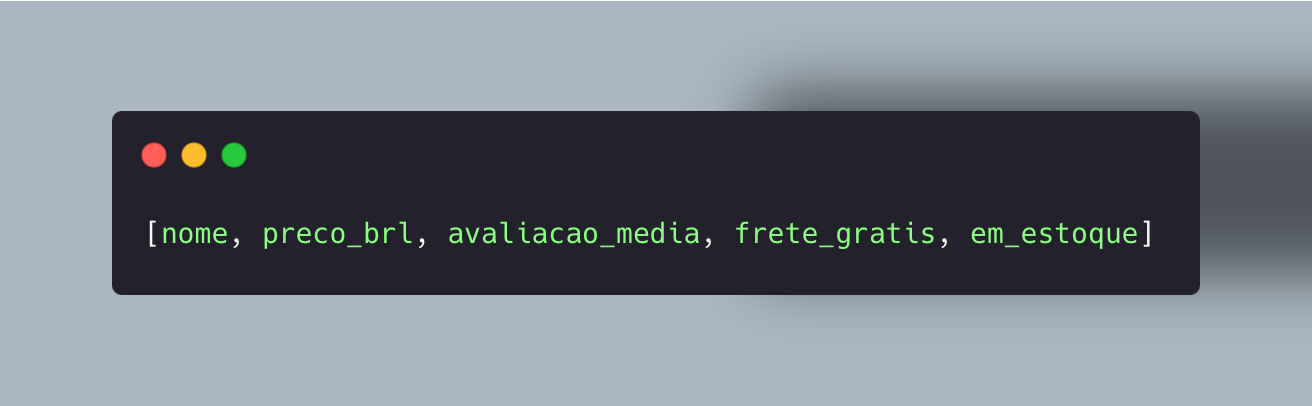
O Redis retorna 8 produtos (9 encontrados, 1 indica has_more=True). Cada documento chega com 5 campos (projeção Slim):
 Ampliar ↗
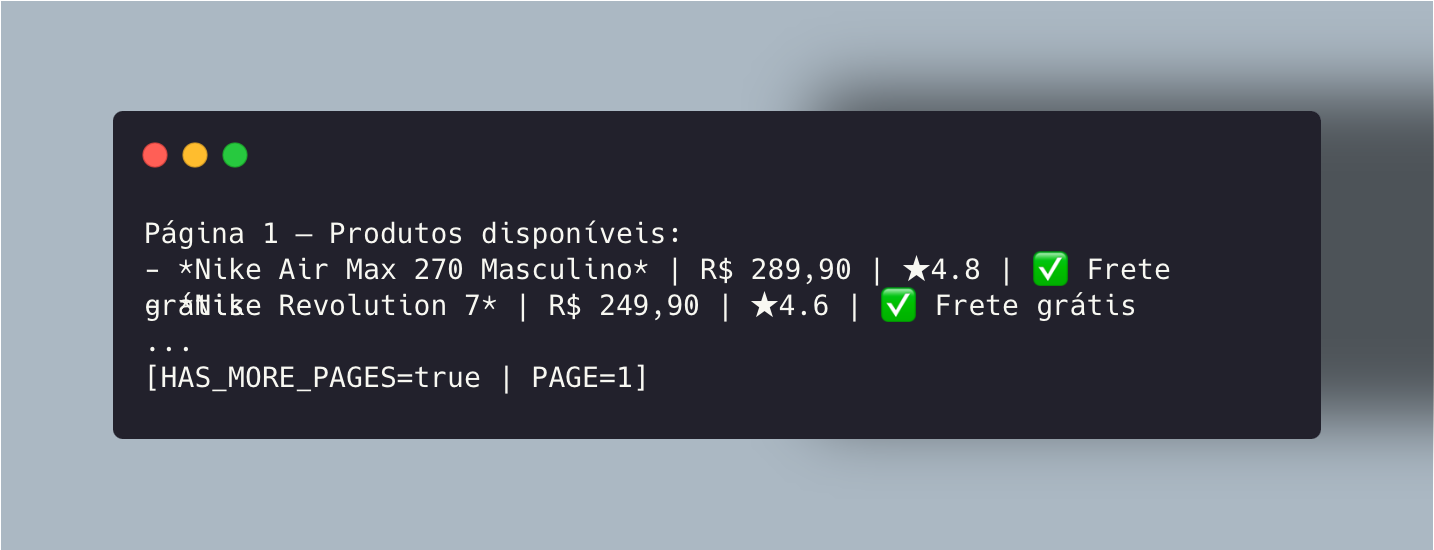
A tool formata o output para o LLM:
 Ampliar ↗
O token [HAS_MORE_PAGES=true] no output da tool vai ser lido pelo generate_node para saber se deve preparar a UX de paginação.
Latência desta etapa: ~45ms.
Etapa 5 Generate node: DSPy Advisor com Refine#
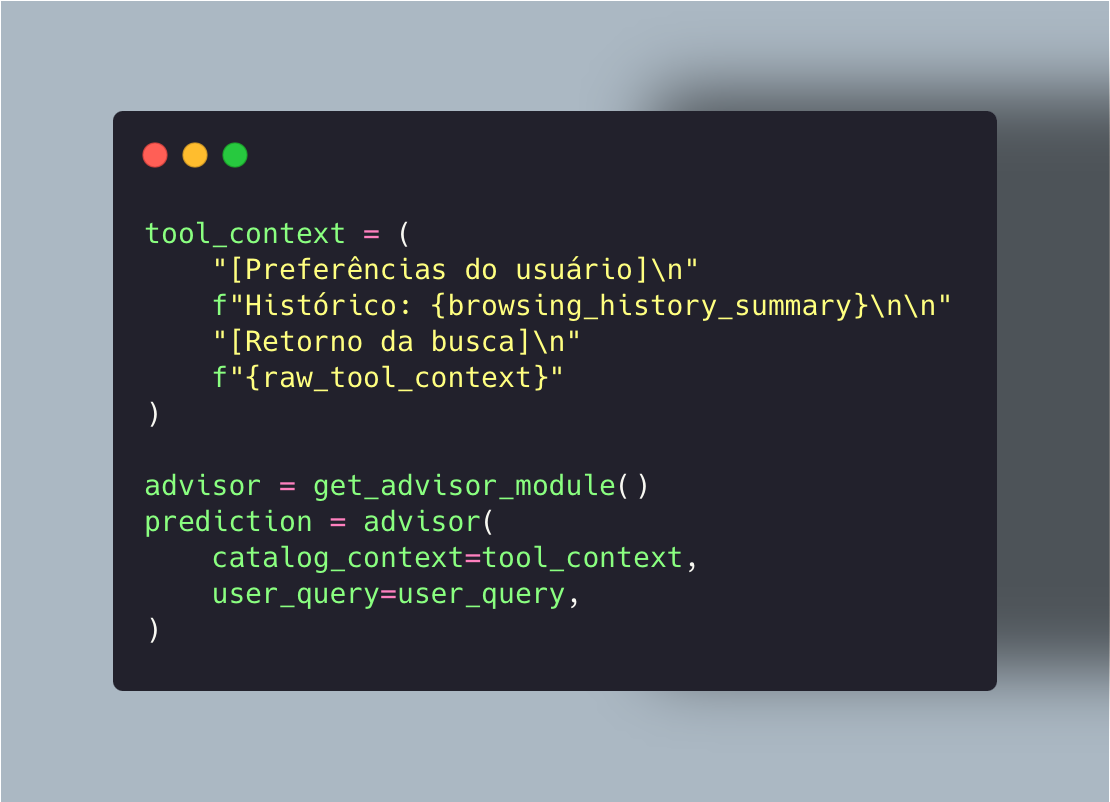
O generate_node monta o contexto e chama o CatalogAdvisorModule:
 Ampliar ↗
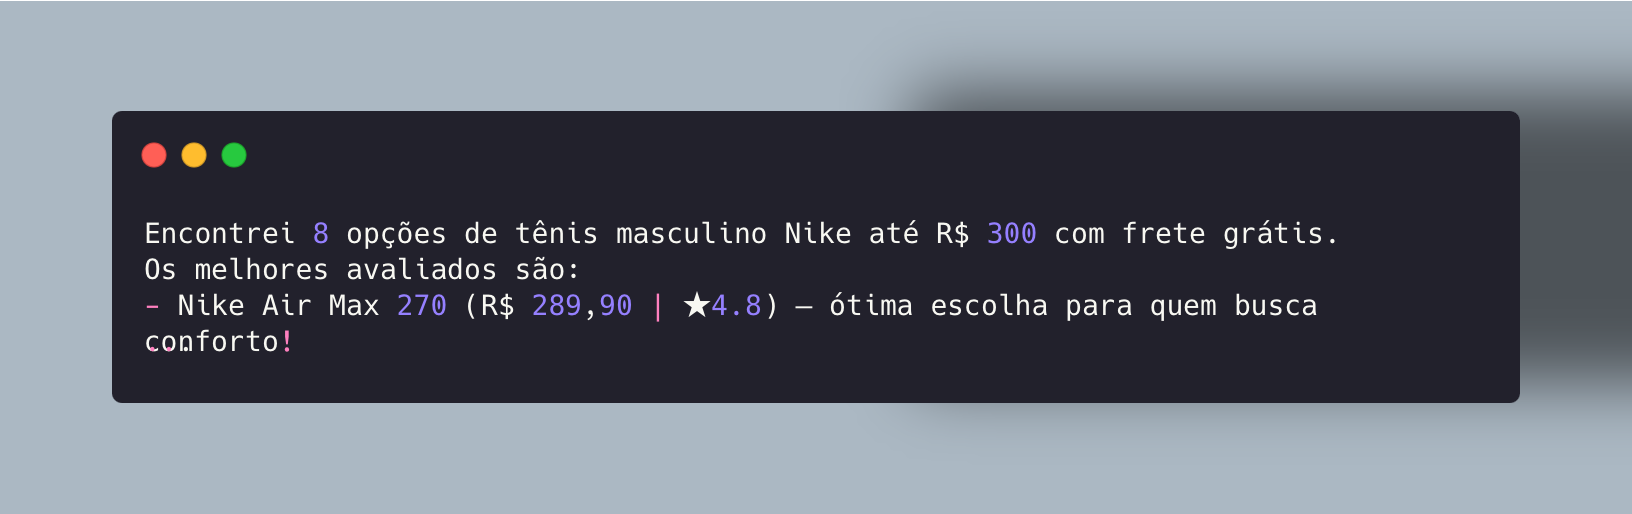
O CatalogAdvisorModule usa dspy.Refine(N=3, threshold=1.0). Na primeira tentativa, o LLM gera:
 Ampliar ↗
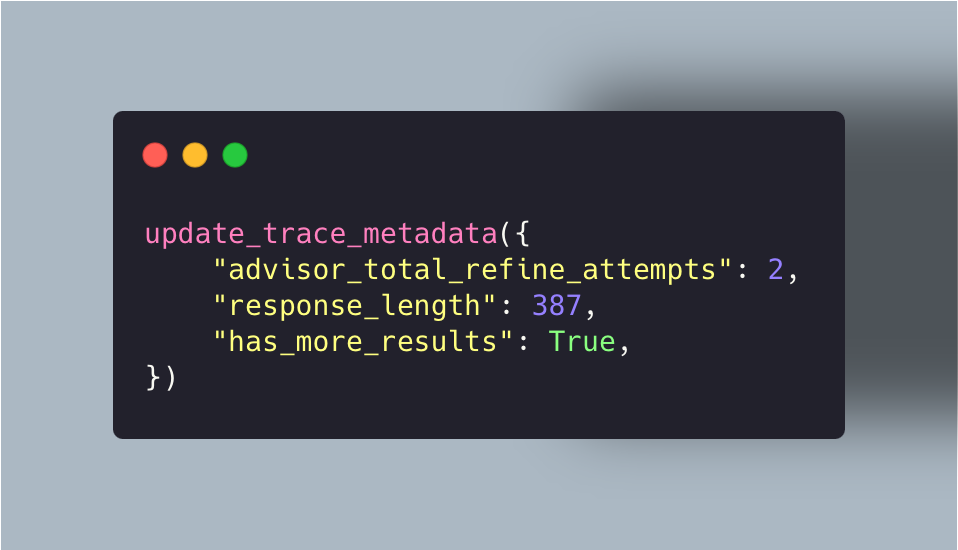
A função de recompensa detecta "ótima escolha", que violação da regra de opinião qualitativa. Score: 0.75. O Refine gera novamente.
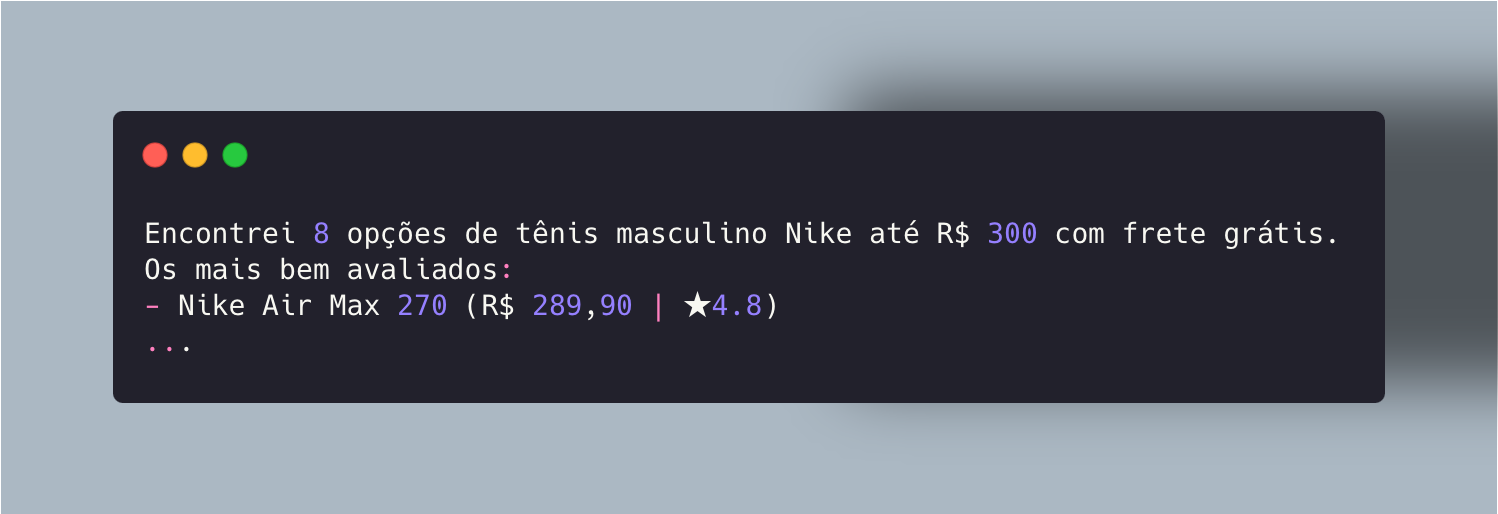
Segunda tentativa:
 Ampliar ↗
Score: 1.0. O Refine encerra.
 Ampliar ↗
Latência desta etapa: ~3.6s (2 chamadas ao LLM).
Etapa 6 Critique node: validação final#
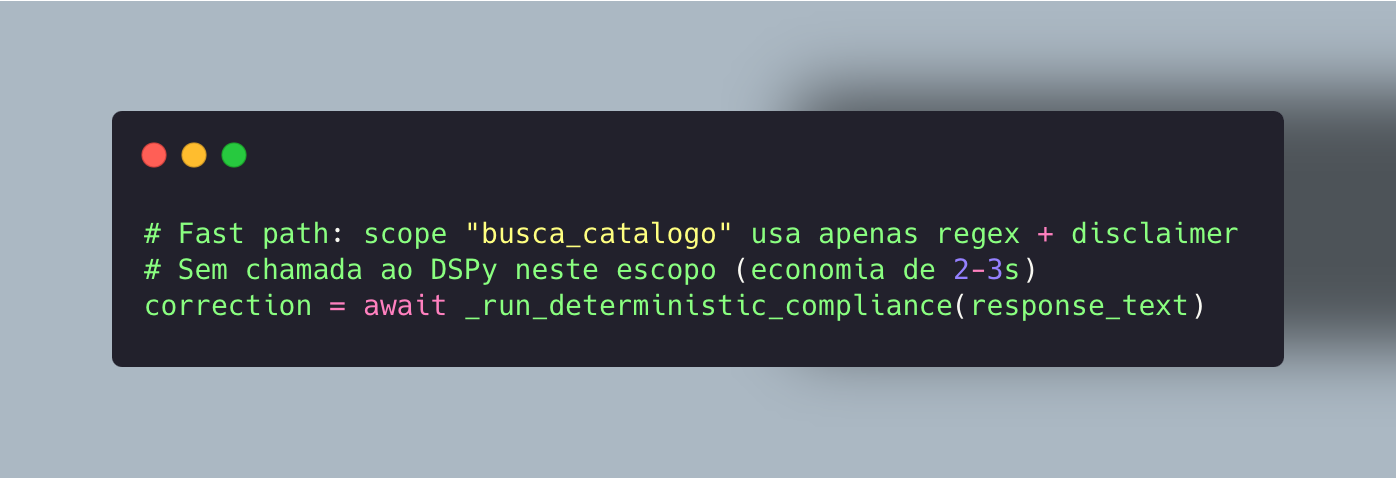
O critique_node recebe a resposta gerada e valida:
 Ampliar ↗
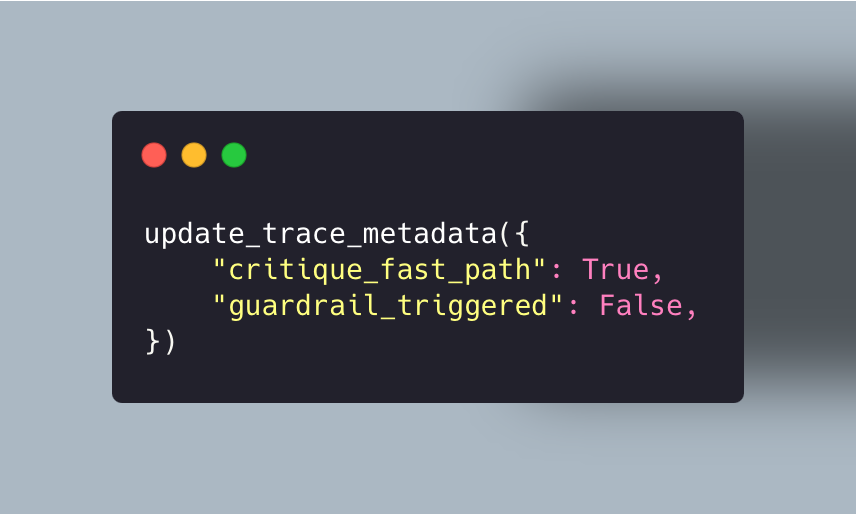
Fast path ativo para scope="busca_catalogo". Checks síncronos em <5ms:
Strip de oferta de PDF prematura → não encontrou
Quick regex (imperativo) → passou
Disclaimer ausente → não há disclaimer obrigatório, não aplica
Perspective check → passou
 Ampliar ↗
Latência desta etapa: <5ms.
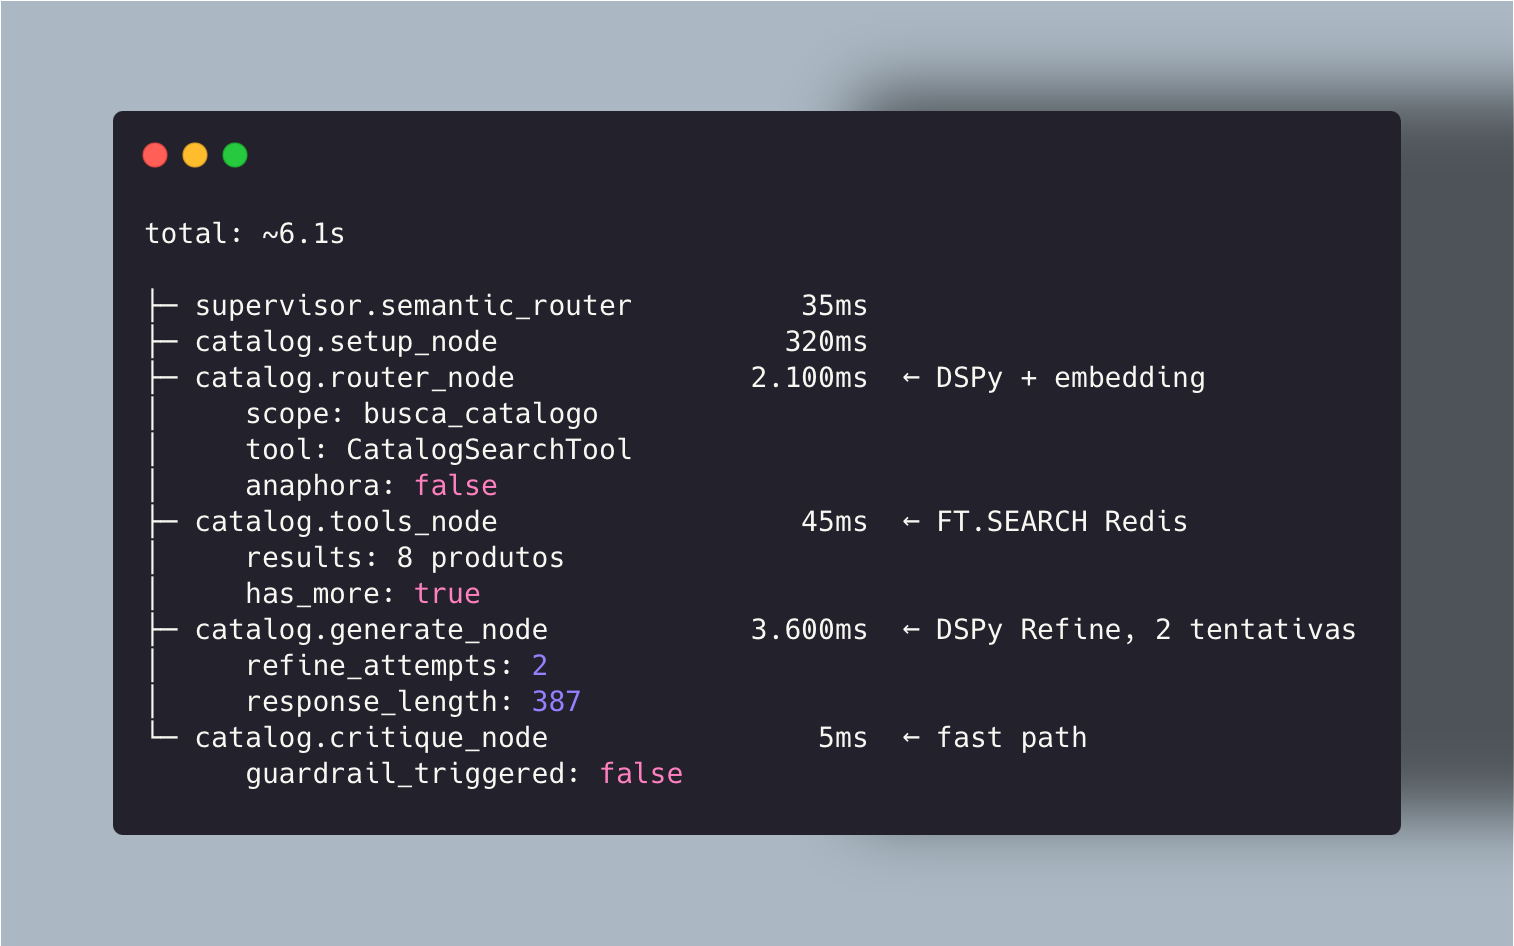
O trace completo#
 Ampliar ↗
O que cada componente decidiu#
O semantic router decidiu que é busca de catálogo, sem LLM, em 35ms.
O resolver de anáforas decidiu que a mensagem não tem referência implícita em <1ms.
O DSPy router decidiu scope, ferramenta e 8 parâmetros de filtro em 2.1s.
O QueryBuilder transformou esses parâmetros numa query FT.SEARCH segura em <1ms.
O Redis Stack executou a busca e retornou 5 campos × 8 produtos em 45ms.
O DSPy Refine gerou a resposta, detectou uma violação e se corrigiu em 3.6s.
O
critique_nodeconfirmou que nada passou em 5ms.
Cada componente tem uma responsabilidade única, nenhum sabe o que o anterior fez. A arquitetura de grafo garante que eles se conectam pelo estado.
O que custou mais e onde há espaço de melhoria#
O DSPy domina a latência: 2.1s no router + 3.6s no generate = 5.7s dos 6.1s totais.
O router DSPy só pode ser acelerado com um modelo mais rápido ou com o fast-path de paginação (que bypassa o DSPy completamente quando o usuário pede "mais" resultados). O generate pode ser acelerado reduzindo a taxa de re-geração do Refine, pois se a Signature for mais explícita sobre a regra de opinião, a primeira tentativa passa e economizamos ~1.8s.
O Redis Stack é irrelevante na latência total: 45ms para busca e retorno de 8 documentos paginados. É onde a modelagem Fat/Slim/Híbrido pagou o custo de construção.
Fechando a série#
Esta série cobriu o sistema de ponta a ponta:
→ Fat/Slim/Híbrido no Redis Stack: como modelar dados para o LLM não se perder
→ DSPy: prompts como código compilável: os 4 conceitos fundamentais
→ Migração Agno → DSPy: o que muda quando o roteador já é LLM
→ Anáforas: resolver antes do LLM, com EntityStack e regex
→ Três roteadores: DSPy, customizado e Aurélio AI comparados
→ Guardrails regulatórios: critique_node com três camadas de defesa
→ Observabilidade com Langfuse: traces, metadata e detecção de degradação
→ dspy.Refine: autocorreção em runtime com função de recompensa
→ QueryBuilder: Pydantic → FT.SEARCH seguro
→ Pipeline completo: a visão de síntese
Cada artigo existe independentemente. Juntos, formam a documentação de uma arquitetura real em produção, com os trade-offs, os bugs silenciosos e as decisões que não ficam visíveis no código.