Sabe quando a versão do modelo vai ser depreciada ou quando você precisa alterar o modelo para outro provider, e isso faz que você precise ajustar seus prompts pra eles funcionarem? Um dos propósitos do DSPy é ajudar nessa dor.
O problema que o DSPy resolve#
A maioria das aplicações com LLM hoje depende de prompt engineering manual. Você escreve uma string longa, testa, ajusta uma palavra, testa de novo, adiciona um ou mais exemplos, reza, e vai ajustando até funcionar. Até o modelo mudar de versão, ou você trocar de provider, ou o caso de uso crescer além dos cenários que você testou.
O DSPy (dspy.ai) propõe uma mudança: em vez de escrever prompts, você programa módulos declarativos e deixa o framework compilar os prompts otimizados automaticamente, com base em dados, métricas e o modelo que você está usando.
A analogia que o próprio time de Stanford NLP usa: DSPy está para LLMs assim como PyTorch está para redes neurais. Você define a arquitetura (módulos), define o loss (métrica), e o compilador (optimizer) cuida de encontrar os melhores pesos, que no caso de LLMs são instruções e exemplos few-shot.
Quem criou e onde está#
O DSPy nasceu no Stanford NLP Lab em fevereiro de 2022, evoluiu do projeto DSP (Demonstrate-Search-Predict), e ganhou a forma atual em outubro de 2023. A documentação oficial está em dspy.ai, o código-fonte em github.com/stanfordnlp/dspy, e a comunidade é ativa no Discord.
O framework é open-source, tem mais de 250 contribuidores, e já inspirou uma série de trabalhos acadêmicos e ferramentas derivadas. Se você trabalha com pipelines de LLM em produção, vale investir tempo entendendo os conceitos, mesmo que não adote o framework inteiro.
Os 4 conceitos fundamentais#
1. Signatures: o contrato de I/O#
Uma Signature define o que o módulo faz, não como. É a interface declarativa entre seu código e o LLM.
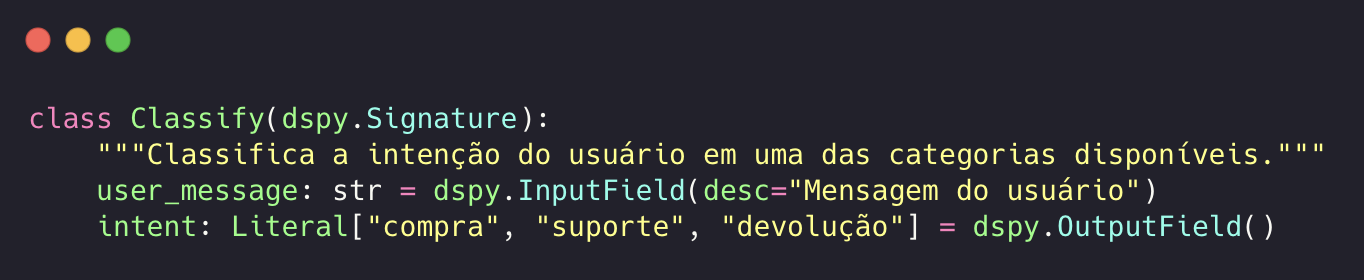
Na forma mais simples:
"question → answer"Ou com tipos e descrições:
 Ampliar ↗
O ponto-chave: você não escreve o prompt. A Signature descreve o contrato, e o DSPy monta o prompt automaticamente, incluindo instruções, formatação e exemplos few-shot se compilado.
A docstring da Signature é mais importante do que parece. Ela vira parte do prompt enviado ao LLM. Regras explícitas ali influenciam diretamente a classificação.
2. Modules: a estratégia de execução#
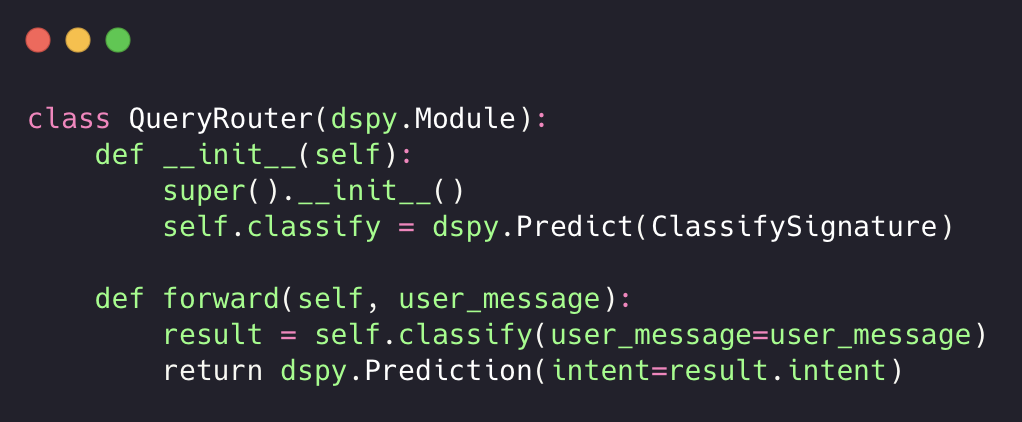
Modules definem como o LLM deve processar a Signature. Os principais:
dspy.Predict: chamada direta, sem raciocínio intermediário;dspy.ChainOfThought: força o modelo a raciocinar passo a passo antes de responder;dspy.ReAct: agente que pode usar ferramentas (busca, código, APIs) em loop;dspy.Retrieve: busca em bases vetoriais integrada ao pipeline.
Você compõe módulos em classes Python normais:
 Ampliar ↗
Isso é código. Testável, debugável, versionável. Não é uma string com mais de 200 linhas colada num template.
3. Optimizers: o compilador de prompts#
Aqui é onde o DSPy se diferencia radicalmente. Os Optimizers (antes chamados de Teleprompters) compilam seu programa gerando automaticamente as melhores instruções e exemplos few-shot para cada módulo.
Os principais:
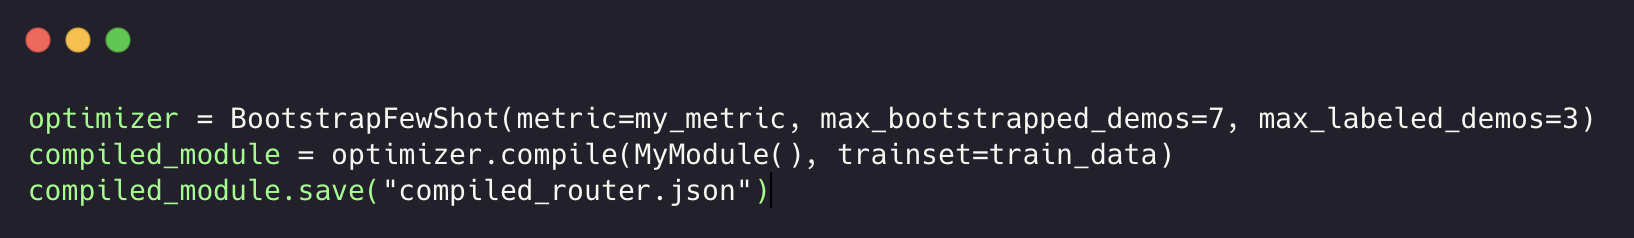
BootstrapFewShot: usa seu próprio programa como professor. Roda exemplos do trainset, valida com sua métrica, e guarda os que passam como demos few-shot no prompt compilado;BootstrapFewShotWithRandomSearch: igual ao anterior, mas testa múltiplas combinações de demos e seleciona a melhor no validation set;MIPROv2: é o mais sofisticado. Gera instruções e exemplos few-shot conjuntamente, usando Bayesian Optimization para buscar a melhor combinação. É data-aware e demonstration-aware;COPRO: foco exclusivo em otimizar instruções (sem few-shot), usando hill-climbing;BootstrapFinetune: vai além do prompt: gera datasets e faz fine-tuning nos pesos do modelo.
Na prática, o fluxo é:
 Ampliar ↗
Depois de compilado, o módulo carrega o JSON e usa os demos otimizados em cada chamada. Sem recompilar a cada request.
4. Metrics : a função de perda#
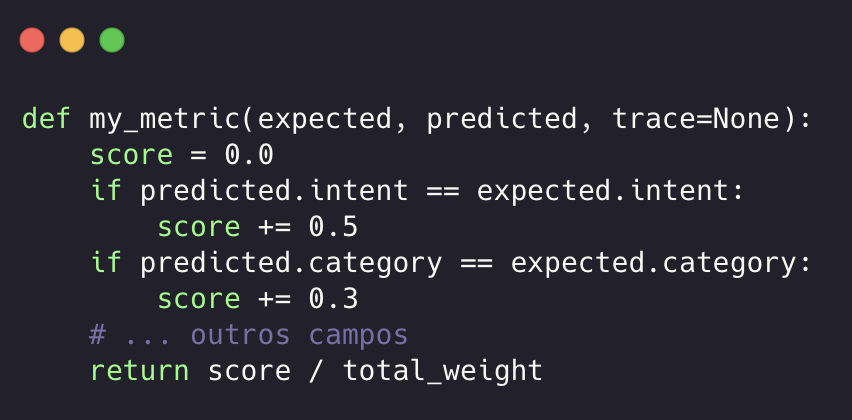
Para o optimizer funcionar, você precisa de uma métrica que diga se essa saída é boa ou não. Pode ser booleana (True/False) ou numérica (0.0 a 1.0).
 Ampliar ↗
O optimizer usa essa métrica para decidir quais demos manter e quais instruções gerar. Quanto mais granular e representativa a métrica, melhor o resultado da compilação.
O que você pode construir com DSPy#
Classificadores estruturados: ecebe texto livre, retorna objetos Pydantic validados (intent, categoria, filtros). Sem regex, sem parser frágil.
Pipelines RAG otimizados: a documentação oficial mostra ganhos de 10% em SemanticF1 otimizando RAG sobre StackExchange com
MIPROv2.Agentes com ferramentas:
dspy.ReActorquestra chamadas a ferramentas em loop, com otimização automática das instruções do agente.Guardrails e compliance : módulos que auditam a saída de outros módulos, com
Signaturesespecíficas para detectar violações.Roteadores cognitivos: classificam queries ambíguas e direcionam para a ferramenta/pipeline correta, com saída estruturada e validada por Pydantic.
Quando vale e quando não vale#
Vale quando:
Você tem múltiplos módulos LLM em pipeline (não é um chat simples);
Precisa de saída estruturada e validada (classificação, extração, roteamento);
Quer portabilidade entre modelos (trocar GPT por Claude sem reescrever prompts);
Tem dados de treino/validação (mesmo que poucos — 50 exemplos já ajudam);
Precisa de reprodutibilidade (o JSON compilado é determinístico para a mesma versão do optimizer).
Não vale quando:
É um chatbot simples de pergunta e resposta;
Você tem zero dados de avaliação;
O custo de aprendizado do framework não se justifica pelo tamanho do projeto;
Precisa de controle total sobre o prompt (DSPy gera o prompt pra você. Se você precisa de controle byte a byte, ele atrapalha mais do que ajuda).
Cuidados práticos que a documentação não enfatiza#
JSON compilado é frágil: se você renomeia um campo na
Signaturee não recompila, o módulo carrega demos antigos com chaves incompatíveis. Resultado: classificação silenciosamente errada, sem erro visível.Diversidade do trainset importa mais que volume: se seus 100 exemplos de treino cobrem 80% do mesmo padrão de query, o optimizer vai sobreajustar. Padrões raros precisam de representação explícita.
A docstring da
Signatureé load-bearing: o DSPy injeta a docstring no prompt. Regras vagas geram classificações vagas. Regras explícitas com exemplos diretamente na docstring influenciam o comportamento do LLM.dspy.inspect_history()é seu melhor amigo. Quando o módulo erra, o primeiro passo é ver o prompt real que foi enviado ao LLM. Sem isso, você está debugando no escuro.Compilar custa dinheiro: cada compilação faz N chamadas ao LLM (N = tamanho do trainset × tentativas). Com GPT-4o, uma compilação pode custar quase nada ou bastante, dependendo da config.
Recursos pra começar#
Documentação oficial: dspy.ai
Código-fonte: github.com/stanfordnlp/dspy
Paper original: "DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines" (Khattab et al., Stanford NLP)
Cheatsheet: dspy.ai/cheatsheet: referência rápida de todos os módulos e optimizers
No próximo post vou mostrar como usei DSPy na prática para construir um roteador cognitivo em um assistente conversacional (trocando o tema investimentos para e-commerce), classificando queries ambíguas do usuário em escopos estruturados com saída Pydantic validada, compilado com BootstrapFewShot e métrica ponderada por campo.