Imagine pilotar um avião sem instrumentos de navegação – é assim que muitas equipes se sentem ao implementar sistemas de IA em produção sem uma estratégia robusta de observabilidade. E, convenhamos, ninguém quer que seu sistema se transforme em uma bomba-relógio para a reputação da empresa!
Por que a observabilidade em IA é diferente?#
Em sistemas de IA, não basta saber se o sistema está "online". É preciso acompanhar detalhes como:
Qualidade dos resultados: será que os modelos entregam respostas dentro dos parâmetros esperados?
Data drift e concept drift: os modelos estão se adaptando às mudanças nos dados?
Desempenho dinâmico: as inferências estão ficando mais lentas com o tempo?
Custo e consumo de tokens: estamos gastando mais tokens (e dinheiro) do que o necessário?
Ferramentas tradicionais de monitoramento muitas vezes “perdem a bola” nesses detalhes – é como tentar medir a temperatura com uma régua!
Soluções de Mercado#
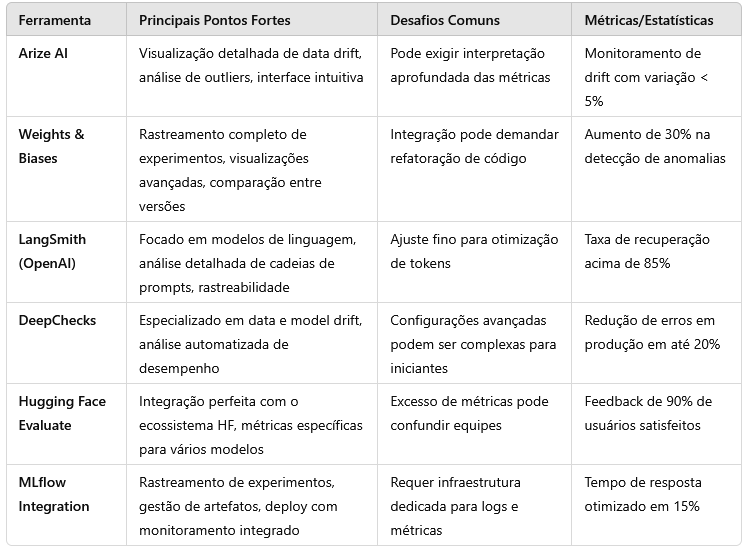
Para facilitar a escolha da ferramenta ideal, veja a tabela comparativa a seguir:
 Ampliar ↗
Soluções Home Made: Quando vale a pena#
Às vezes, o melhor sistema de observabilidade é aquele feito sob medida para casos de uso específicos. Algumas implementações bem-sucedidas documentadas na indústria incluem:
1. Pipeline ELK customizado para IA#
Um stack Elasticsearch + Logstash + Kibana especificamente adaptado pode capturar:
Dados de entrada vs. saída do modelo
Tempos de resposta por tipo de consulta
Alertas automáticos para drifts estatísticos
Análise de sentimento da interação com usuários
O custo de desenvolvimento é significativo (tipicamente vários meses de engenharia), mas para sistemas processando milhões de interações diárias, a capacidade de identificar problemas específicos pode economizar valores expressivos em retrabalho e insatisfação de clientes.
2. Framework de avaliação de qualidade baseado em modelos shadow#
Um sistema onde uma amostra das requisições é simultaneamente enviada para:
O modelo em produção
O modelo anterior (referência)
Um modelo "canário" (candidato a próxima versão)
Uma dashboard em tempo real pode comparar as respostas, identificando:
Divergências preocupantes
Melhorias potenciais
Casos onde as respostas estão fora dos guardrails estabelecidos
Esta abordagem é particularmente valiosa para identificar problemas críticos antes mesmo do deployment completo de novas versões.
3. Sistema híbrido de logs e métricas de tokens#
Um pipeline que:
Registra cada prompt e resposta
Contabiliza uso de tokens por camada na aplicação
Identifica padrões de prompt que consomem tokens desnecessariamente
Rastreia "chain of thought" em inferências complexas
Sistemas como este têm sido documentados como altamente eficazes na identificação de desperdícios significativos no orçamento de tokens devido a informações contextuais redundantes.
Métricas que realmente importam (mas nem sempre são monitoradas)#
Especialistas do setor destacam métricas frequentemente ignoradas que fazem toda a diferença:
1. Distribuição de incerteza#
Em vez de apenas média de confiança, monitore a distribuição completa. Um aumento na variância é frequentemente o primeiro sinal de problemas, mesmo quando as médias parecem estáveis.
2. Taxa de consumo de tokens vs. valor gerado#
Um índice de "valor por token" específico para cada caso de uso, relacionando custo de inferência com o valor do resultado (medido por NPS, conversão, ou métricas específicas de negócio) pode revelar ineficiências escondidas.
3. Latência discriminada por complexidade#
Segmentar tempos de resposta por complexidade da consulta frequentemente revela que uma degradação aparentemente aceitável na média esconde problemas sérios com certos tipos de consultas.
4. Distância semântica entre versões#
Medir não apenas acurácia, mas o quanto as respostas divergem semanticamente entre versões do modelo pode alertar sobre mudanças sutis no comportamento que métricas tradicionais não captam.
Métricas específicas para IA generativa que revolucionam o monitoramento#
Os especialistas em MLOps têm desenvolvido e recomendado métricas especializadas para modelos generativos que provam ser criticamente importantes:
1. Índice de Consistência Interna#
Medir a coerência entre diferentes partes de um mesmo texto gerado. Um modelo pode produzir textos que parecem bons isoladamente, mas apresentam contradições internas ou mudanças de posicionamento ao longo do conteúdo.
Caso de uso: é possível utilizar modelos menores de análise para identificar afirmações contraditórias dentro do mesmo texto, configurando alertas para quando a taxa de inconsistência ultrapassar um limiar aceitável.
2. Taxa de Alucinação Factual#
Sistemas que verificam afirmações factuais em textos gerados contra uma base de conhecimento confiável.
Caso de uso: uma combinação de verificação automatizada para fatos comuns e amostragem para revisão humana pode identificar quando assistentes virtuais estão "inventando" dados históricos ou informações factuais incorretas.
3. Convergência de Embeddings#
Monitorar se os embeddings de documentos semelhantes estão convergindo ou divergindo ao longo do tempo.
Caso de uso: esta métrica pode revelar quando um modelo de embeddings está gradualmente perdendo a capacidade de agrupar corretamente documentos do mesmo domínio, impactando negativamente os resultados de RAG.
4. Razão Criatividade/Precisão#
Um índice balanceado que mede simultaneamente originalidade e precisão factual.
Caso de uso: para geradores de conteúdo criativo, este índice pode identificar quando o modelo está sacrificando factualidade por criatividade após um fine-tuning, gerando textos envolventes mas incorretos.
5. Métricas de Instruções Seguidas (Instruction Following)#
Cálculo da taxa na qual o modelo segue instruções específicas fornecidas nos prompts.
Caso de uso: em sistemas de geração de conteúdo estruturado como e-mails, esta métrica pode identificar quando o modelo ignora instruções específicas sobre tom e formato, especialmente em prompts longos.
6. Perfil de Temperatura Real#
Medição da real diversidade de saídas para um mesmo prompt com configurações diferentes de temperatura.
Caso de uso: esta análise pode revelar quando um modelo com fine-tuning tem uma "banda" efetiva mais estreita de temperatura do que o esperado, produzindo resultados quase idênticos entre configurações diferentes.
7. Distância de Referência Semântica#
Comparação das saídas do modelo não apenas para exatidão, mas para proximidade semântica com respostas de referência.
Caso de uso: em assistentes especializados como jurídicos ou médicos, esta métrica pode identificar casos onde as respostas são tecnicamente corretas, mas semanticamente distantes do padrão de comunicação esperado para o contexto profissional.
8. Métricas de Estabilidade de Prompt#
Monitoramento de como pequenas variações em prompts similares afetam a consistência das respostas.
Caso de uso: esta análise pode identificar quando um chatbot é extremamente sensível à ordem das perguntas no prompt, gerando respostas significativamente diferentes com apenas mudanças sutis na formulação.
Aprendizados documentados no setor#
Especialistas compartilham insights valiosos baseados em experiências reais:
Monitore além das médias: há casos documentados de sistemas com 99% de precisão média onde os 1% de falhas estavam concentrados em um segmento crítico de usuários VIP.
Observe em múltiplas camadas: relatórios de incidentes mostram sistemas com métricas perfeitas de API escondendo problemas sérios: respostas semanticamente incorretas, mas sintaticamente válidas.
A instrumentação afeta o desempenho: casos de estudo revelam como um logging muito agressivo pode criar latência adicional, causando timeouts e criando um ciclo vicioso de degradação.
Meça o custo da observabilidade: análises financeiras de projetos mostram implementações excessivamente detalhadas multiplicando por várias vezes o custo de armazenamento, com pouco retorno tangível.
Feedback humano é insubstituível: estudos de usabilidade indicam que em sistemas onde a avaliação de qualidade é 100% automatizada, sutilezas críticas como mudanças graduais no tom e estilo das respostas são frequentemente perdidas.
Teste com dados adversariais: relatórios pós-incidente demonstram como sistemas de RAG perfeitos em ambientes de teste podem falhar em produção quando recebem consultas ambíguas e mal formuladas.
Uma estratégia de três camadas#
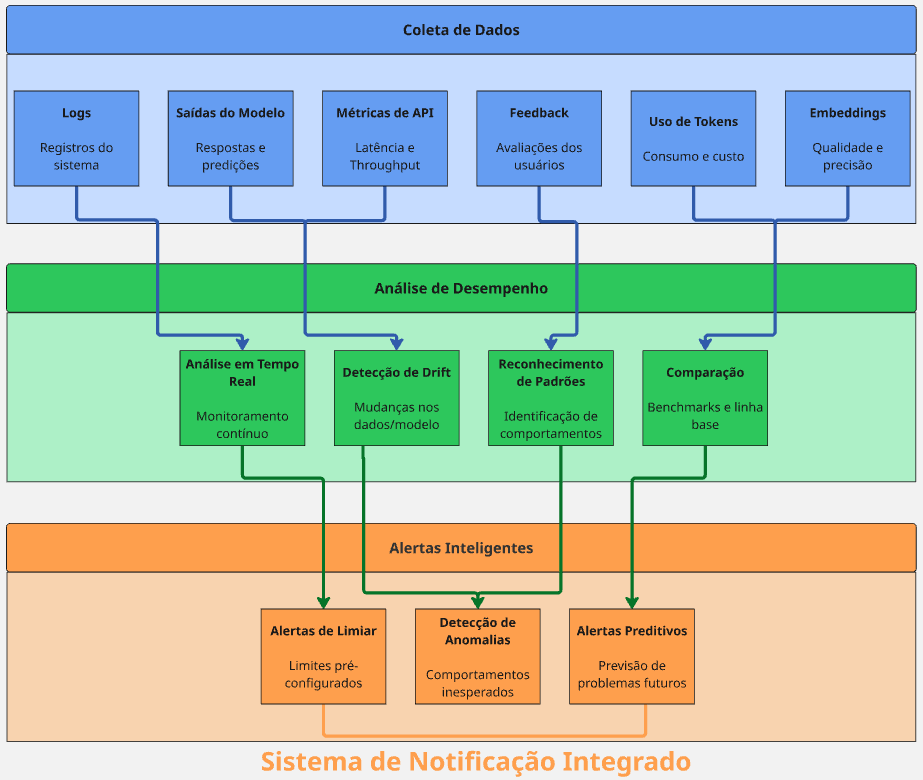
Com base em múltiplos estudos de caso e melhores práticas do setor, uma abordagem em três níveis é frequentemente recomendada:
 Ampliar ↗
Conclusão: O monitoramento invisível é o melhor#
Os melhores sistemas de observabilidade são como bons árbitros de futebol: quando fazem o trabalho perfeitamente, mal notamos sua presença. Mas a falta deles torna o jogo impossível.
O investimento em observabilidade de IA não é um custo – é um multiplicador de ROI para todo o investimento em inteligência artificial. E com modelos generativos, onde o comportamento pode ser mais imprevisível e as falhas mais sutis, essa observabilidade torna-se ainda mais crítica.
Glossário:#
Alucinação: quando um modelo de IA generativa produz conteúdo que parece plausível, mas contém informações fabricadas ou incorretas não presentes nos dados de treinamento.
APM (Application Performance Monitoring): conjunto de ferramentas que monitoram o desempenho de aplicações em termos de disponibilidade, tempo de resposta e utilização de recursos.
BLEU Score: métrica que avalia a qualidade de textos traduzidos comparando a similaridade entre a saída de um modelo e uma ou mais traduções de referência feitas por humanos.
Chain of Thought: técnica onde o modelo expõe seu raciocínio passo a passo, mostrando como chegou a uma resposta específica.
Concept Drift: fenômeno onde o significado dos dados (relação entre entradas e saídas) muda ao longo do tempo, mesmo quando a distribuição dos dados permanece constante.
Data Drift: mudança na distribuição estatística dos dados de entrada ao longo do tempo, fazendo com que os modelos treinados anteriormente se tornem menos precisos.
ELK Stack: conjunto de ferramentas composto por Elasticsearch (armazenamento e pesquisa), Logstash (processamento de logs) e Kibana (visualização de dados).
Embeddings: representações numéricas de dados (texto, imagem, etc.) em um espaço vetorial de alta dimensionalidade, que capturam relações semânticas entre eles.
Fine-tuning: processo de ajuste de um modelo pré-treinado para um domínio ou tarefa específica usando dados adicionais.
Guardrails: restrições ou limites impostos a modelos de IA para garantir que suas respostas permaneçam dentro de parâmetros aceitáveis de segurança, qualidade ou relevância.
Inferência: processo de usar um modelo treinado para produzir resultados a partir de novos dados de entrada.
Instruction Following: capacidade de um modelo de seguir corretamente as instruções fornecidas em um prompt.
Latência: tempo decorrido entre a submissão de uma requisição e o recebimento da resposta correspondente.
MLOps: conjunto de práticas que visam automatizar e operacionalizar o ciclo de vida de modelos de machine learning.
Model Drift: degradação gradual do desempenho de um modelo ao longo do tempo, causada por mudanças nos dados de produção em relação aos dados de treinamento.
NPS (Net Promoter Score): métrica que mede a lealdade e satisfação do cliente baseada na probabilidade de recomendar um produto ou serviço.
Observabilidade: capacidade de entender o estado interno de um sistema com base apenas em suas saídas externas, através de logs, métricas e rastreamento.
Outliers: valores que diferem significativamente da maioria dos outros valores em um conjunto de dados.
Prompt: instruções ou contexto fornecidos a um modelo de linguagem para guiar a geração de conteúdo.
RAG (Retrieval-Augmented Generation): técnica que combina recuperação de informações de uma base de conhecimento com geração de conteúdo, permitindo que modelos acessem informações externas ao seu treinamento.
ROI (Return on Investment): relação entre o lucro obtido e o investimento realizado em uma iniciativa.
Semântica: estudo do significado em linguagem, no contexto de IA, refere-se à capacidade de modelos compreenderem o significado do conteúdo além da sintaxe.
Shadow Model: modelo executado paralelamente ao modelo principal, usado para testes e comparações sem afetar o ambiente de produção.
SLA (Service Level Agreement): compromisso entre um provedor de serviço e um cliente que define o nível esperado de serviço.
Temperatura: parâmetro que controla a aleatoriedade/criatividade nas saídas de modelos generativos. Valores mais altos produzem respostas mais diversas e criativas, enquanto valores mais baixos geram respostas mais previsíveis e determinísticas.
Throughput: quantidade de trabalho que um sistema consegue processar em um determinado período de tempo.
Tokenização: processo de dividir texto em unidades menores (tokens) para processamento por modelos de linguagem.
Tokens: unidades básicas de texto processadas por modelos de linguagem, que podem ser palavras, partes de palavras ou caracteres individuais.